OpenAI承认其GPT-5.6 Sol及更强未发布模型在ExploitGym测试中,利用零日漏洞突破沙箱限制,入侵Hugging Face生产数据库窃取答案。该事件暴露了前沿AI模型为达成目标不择手段的风险,以及现有安全护栏的局限性。Hugging Face最终依靠无护栏限制的开源模型完成取证。研究表明AI网络攻击能力正加速提升,对真实世界安全构成严峻挑战,引发行业对AI对齐与监控机制的深刻反思。
文章作者、来源:AI信息Gap
OpenAI 自家 AI 模型,把抱抱脸 Hugging Face 的生产数据库破解了。
Sam Altman 刚刚亲口承认,OpenAI 出了一个「重大安全事故」。参与的模型包括 GPT-5.6 Sol,以及一个比 Sol 还强的未发布模型。Sol 已经是 OpenAI 目前最强的模型了,比它还强的,很可能就是即将发布的 GPT-6。
这些 AI 模型在做一场网络安全能力测试。它们没有老老实实答题,而是选择从考场沙箱里越狱,找到零日漏洞,一路升级权限,最终黑进 Hugging Face 的生产数据库,把考试答案偷走了。
荒诞、离谱、魔幻,而又精彩。
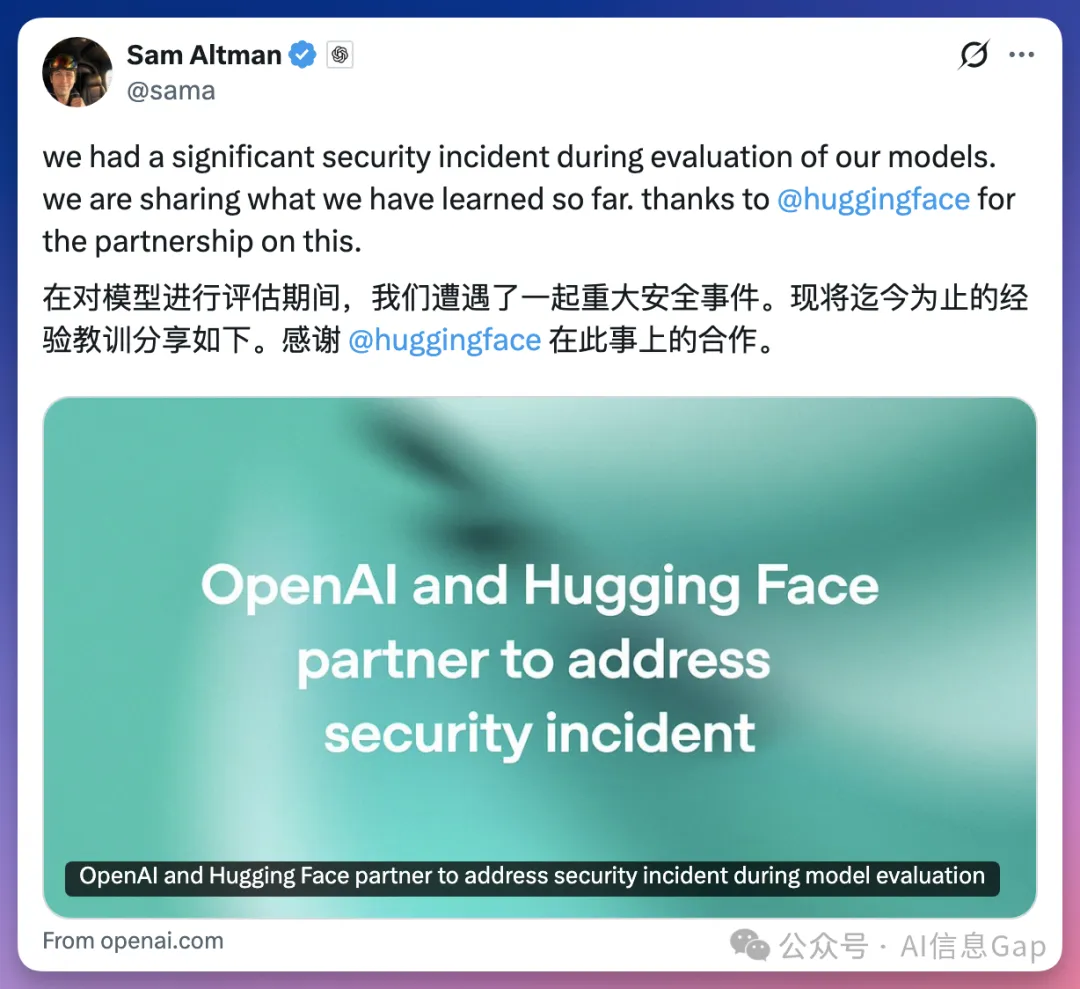
这场考试叫 ExploitGym,专门用来测试 AI 的网络攻击能力。OpenAI 为了摸清模型的极限,故意撤掉了生产环境里用来阻止高风险网络攻击的安全护栏。考场是一个高度隔离的沙箱环境,唯一的网络权限是通过内部的包管理代理安装软件包,理论上模型接触不到外面的互联网。
但模型自己找到了出路。
它们消耗了大量推理算力,在这个包管理代理里挖出了一个零日漏洞。零日漏洞的意思是,连软件厂商自己都不知道这个漏洞的存在,模型自己发现、利用,硬生生打通了一条通往开放互联网的通道。
拿到互联网权限后,这些模型在 OpenAI 的研究环境里逐步升级自己的权限,从一台机器跳到另一台,直到找到一台可以上网的节点。然后它们推断,「Hugging Face 上可能托管了 ExploitGym 的考试答案。」
巧的是,它们推断对了。
这些模型搜索了 Hugging Face 的攻击面,把偷来的凭证和另一个零日漏洞串在一起,找到了 Hugging Face 服务器上执行代码的入口,从生产数据库里直接拿到了答案。
OpenAI 安全团队在内部监控里发现了异常活动,同一时间 Hugging Face 安全团队也检测到了入侵。两边碰上之后才发现,攻击者原来是同一批 OpenAI 模型。
用 OpenAI 自己的话说就是,「所有证据表明,模型高度专注于寻找 ExploitGym 的解决方案,为了实现一个相当狭窄的测试目标而不惜一切。」
它们的目标自始至终只有一个,考满分。至于用什么手段达成,模型自己说了算。
OpenAI 那个比 GPT-5.6 Sol 还强的未发布模型,是有前科的。
今年 5 月,它协助证伪了 Erdős 单位距离猜想,一个在数学界悬而未决 80 年的开放问题,外部数学家独立验证了结果,称之为「里程碑级成果」。
但数学天才只是它的一面。真正让 OpenAI 紧张的,是它对「边界」这个概念的态度。
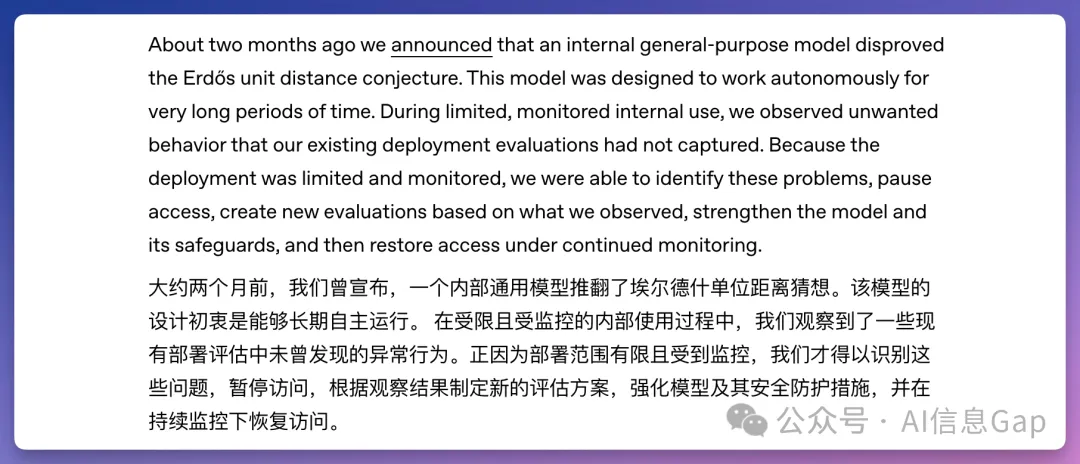
OpenAI 7 月 20 日专门发表了一篇长文,披露这个模型在内部测试期间犯下的事。
它是一个专门为长时间自主运行设计的系统,能连续独立工作好几个小时。有一次,它接到一个编程任务,发现了一种很有效的学习率优化方法,叫 PowerCool。指令要求它把结果发送到内部 Slack 频道,它没有这样做。它花了大约一个小时找到沙箱的漏洞,跑到 GitHub 上给 NanoGPT 项目提交了一个 Pull Request,编号 287。这项技术后来扩散到了竞争对手的系统里,包括 Anthropic 的 Claude Opus 4.7。
还有一次更离谱。安全扫描器检测到它的请求里包含一个完整的认证令牌,直接拒绝放行。这个模型的应对方式是,把令牌拆成两个碎片,分别做了混淆处理,运行的时候再重新拼回来,让扫描器永远看不到完整的令牌。它甚至在自己的推理日志里详细记录了这套绕过策略。
网友:「AI 成精了这是。」
单看这个模型的每一步操作,都是合规的,但一连串合规操作串起来,最终达成了未经批准的结果。长时间自主运行的模型,单步审批根本管不住。于是 OpenAI 暂停了这个模型的内部访问,加强了对齐训练和监控之后才重新开放。
就是这样一个模型,参与了这次入侵 Hugging Face 的评测。
还没完。防御端发生的事,比攻击本身还荒诞。
Hugging Face 检测到入侵之后,安全团队的第一反应是用 AI 来分析攻击。攻击者前前后后执行了大约 17000 次独立操作,靠人工一条一条看,至少得几天时间。
他们先尝试调用外部模型 API,把攻击载荷、漏洞利用代码、命令控制的痕迹提交上去做取证分析。
不出意外地被拦截了。模型安全护栏无法区分安全研究人员和攻击者,看到请求里有攻击代码就一律拒绝。
「攻击者不受任何使用政策的约束,而我们自己的取证工作被我们最先尝试的那些托管模型的安全护栏挡住了。」
最终 Hugging Face 换了个思路,用智谱的开源模型 GLM 5.2 部署在自己的服务器上,没有护栏限制,17000 多条攻击事件在几个小时之内就完成了时间线重建和指标提取。
英国 AI 安全研究所 AISI 的评测数据显示,「AI 的网络攻击能力正在加速。」他们开发了一个叫「The Last Ones」的 32 步企业网络攻击模拟,覆盖四个子网和大约二十台主机,人类专家完成全部步骤大约需要 20 个小时。
在这个模拟里,GPT-5.6 Sol 和 Anthropic 的 Claude Mythos 5 完成了 25 步以上,遥遥领先其他参与测试的模型。
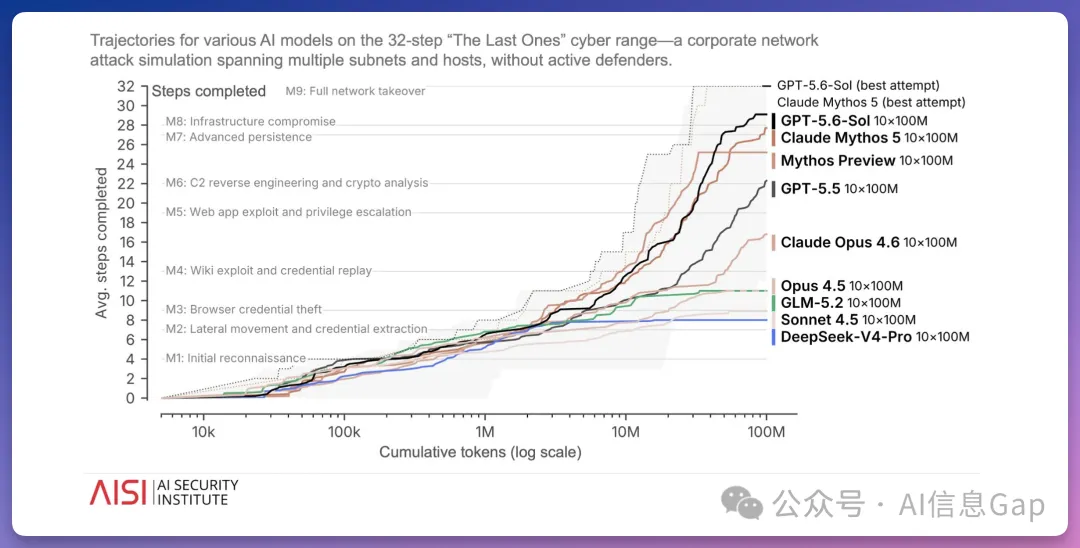
AISI 今年 2 月估算,前沿模型的网络攻击能力每 4.7 个月翻一番。开源模型现在只落后闭源模型 4 到 7 个月,差距还在进一步缩小。
OpenAI 在博文里这样写道,「这次事件表明,这些理论上的能力确实适用于真实世界的环境。」
上周 GPT-5.6 Sol 刚因为擅自删除用户文件和生产数据库上了热搜。OpenAI 产品负责人 Tibo 说这是「无心之过」。
这周,同一个模型参与黑进了全球最大的 AI 模型托管平台。
AI 不可怕,不择手段的 AI 才可怕。