阿里达摩院发布全球首个专家级通用影像AI模型DAMO RADAR,可通过一个模型覆盖腹部18种解剖结构、识别146种疾病。该模型在内部3.9万例真实世界连续队列中平均AUC达0.913,外部8家医院2.4万例验证中AUC为0.895,急诊场景仍保持0.904。人机对比显示,RADAR准确率超过23名放射科医生,AI辅助可提升医生敏感度约10%、减少阅片时间30%以上。该研究登上Science期刊,证明了通用AI在医疗这种高精度、低错误容忍度场景中的可行性。
文章作者、来源:量子位
AI正在横扫一切,但有块硬骨头,迟迟攻不下来,让无数人希望落空。
2016年,Hinton老爷子就预言:“人们现在就应该停止培养放射科医生。”他甚至认为,五年内,AI就会在医疗影像识别上超过放射科医生。
老爷子一生谨慎,但历史和他开了个玩笑。十年过去了,人们离AGI已经越来越近,但在医疗场景里,即使图像识别这样的AI新手村任务,依然是hard模式。
如果从IBM的Watson算起,在医疗上遭遇滑铁卢的AI专家数不胜数。
为什么医疗成了AI的阿喀琉斯之踵?
——对模型精度的极高要求,在别的领域,模型幻觉可以一笑了之,但在这里却是人命关天。
这也导致了医疗影像AI长期困在专用模型里。
直到今天,学术期刊的“王者”Science正式刊发一项来自中国的重磅研究:
DAMO RADAR,据悉是全球首个专家级的通用影像AI模型。
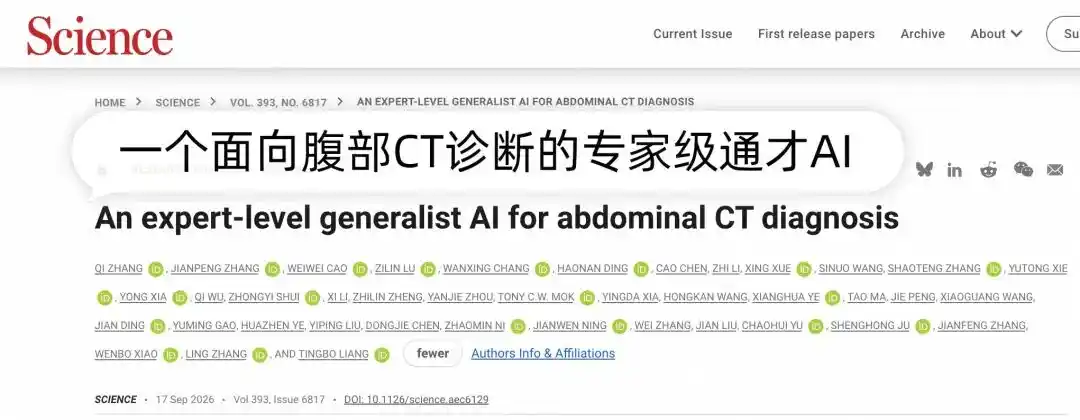
这个模型,能看腹部18种解剖结构的146种病,比很多影像科医生看得还准。
而且模型、代码、框架,全开源了。
一个模型,看146种病
DAMO RADAR,全称Rapid Abdominal Diagnosis with AI and Radiology,面向腹部快速诊断的AI模型。
这个AI“雷达”,研发团队就是阿里达摩院,过去几年他们用AI识别CT中肉眼难见的早期癌症病灶,在胰腺癌、胃癌、肠癌等专病上取得重大突破,发表5篇Nature Medicine。
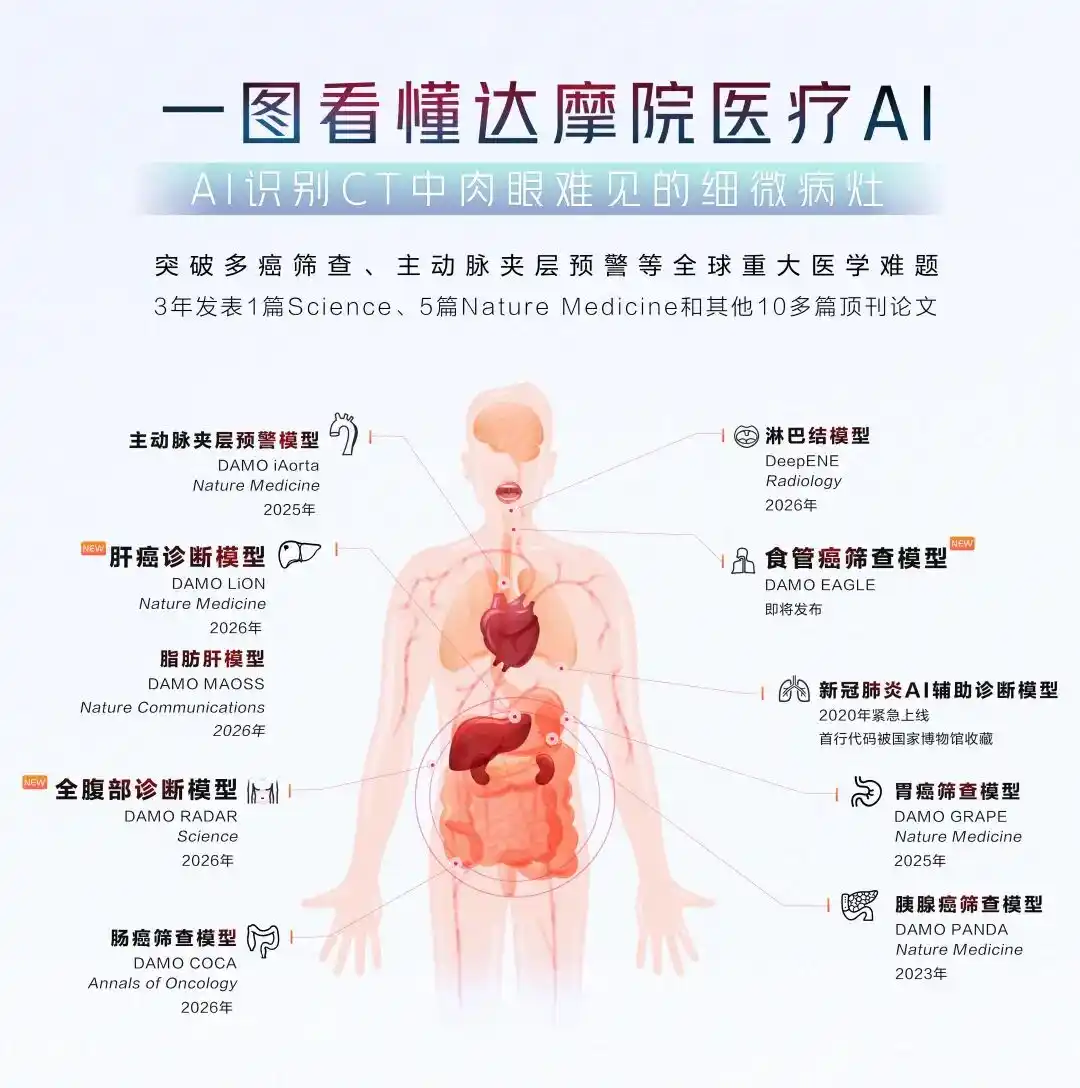
但做着做着,达摩院有些人觉得不对劲了。达摩院高级算法专家张建鹏说,一个病种啃下来至少两三年,人类疾病成千上万种,那他们搞一辈子都搞不完……
更棘手的是,真实世界里,病人不会只带着一种病来医院,对着专病模型问他是不是有这种病。事实上,一份CT影像里,很可能同时存在多种器官,多种病变。
达摩院联合浙大一院等全球众多医院向腹部CT发起冲击,希望AI能一次性识别出腹部各种疾病。
选腹部,是因为这是临床公认最难的影像场景。
浙大一院放射科主任肖文波介绍,年轻医生通常最害怕被分到腹部组。
因为腹部涉及消化系统、泌尿系统、生殖系统,肝胆胰脾肠道全挤在一起,肠道还盘绕整个腹腔,所有器官几乎都是软组织,密度接近,全靠肉眼对密度差的敏感度把病灶揪出来。
之前,已经有了针对肺结节之类的AI辅助工具,但腹部太复杂了,一直是个禁区,没人敢碰。
RADAR要做的,就是用一个模型覆盖整个腹部。
最终它覆盖了18种解剖结构、146种病,涵盖肝脏、胰腺、胆囊、肾脏、脾脏、肠道等主要器官,基本覆盖了临床常见病变。
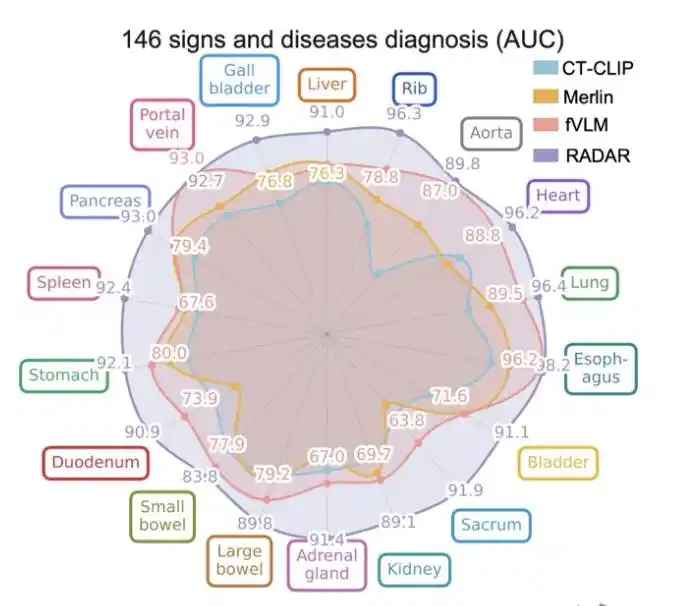
对其效果,团队做了非常严格的多层验证。
在内部近3.9万例真实世界连续队列中,RADAR的平均AUC达到0.913。
AUC是衡量诊断模型区分患者和正常人能力的指标,1是完美区分,0.5等于瞎猜,超过0.9就算优异。
之后,团队又在来自8家外部医院的超过2.4万例CT上验证,这些案例覆盖不同地区、不同扫描设备,RADAR的AUC仍然达到0.895。
而且RADAR还泛化到了急诊场景。
急诊场景与一般门诊的区别是,由于时间紧急,来不及等造影剂发挥最佳效果,患者也不一定有能力配合,CT成像效果偏差。
RADAR的训练目标并未包括急诊,但测试时团队拿2.7万例急诊数据一测,结果AUC依然有0.904。
而且达摩院在肝癌、胰腺癌、胃癌、肠癌四种癌症的诊断上,还提高了对RADAR的要求。
在这四种癌症上,他们用来考验RADAR的依据,是“病理金标准”,也就是以病理活检结果作为Ground truth,确认影像判断准不准。
这个拔高测试当中,RADAR的AUC仍达到了0.891-0.984。
达摩院还做了一波人机对比。
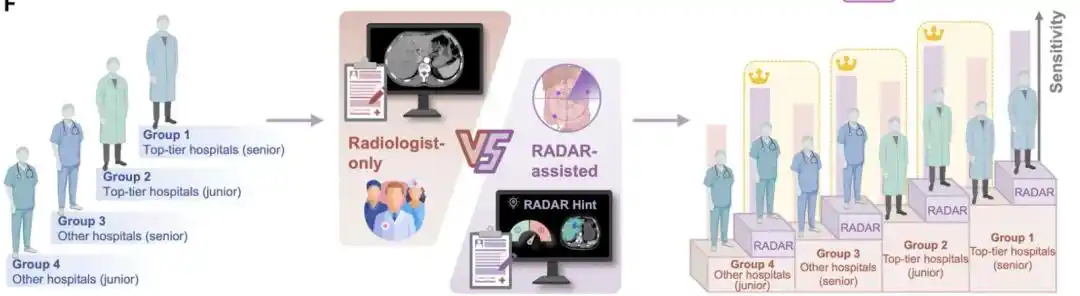
这波对比共有来自14家医院的26名放射科医生参与,RADAR和TA们在同一批病例上各自独立诊断,结果RADAR的准确率超过了其中23名医生,只稍弱于3名资深医生。
与此同时,达摩院还测试了人机协同场景,发现医生在有AI帮助的情况下读片,整体敏感度提升了大约10%,平均阅片时间减少了30%以上。
“初级医生+AI”的配置,敏感性甚至超过了资深医生独自阅片。
那RADAR到底是怎么做到的?
过去的医疗影像AI用的是监督学习,简单说就是让医生一张一张地标注CT图像,然后AI照着标注学。
这种方法标注成本巨大,而且模型只能识别被标注过的那几种病,换一种就不认识了。
RADAR走了一条不同的路,叫视觉-语言对比学习。
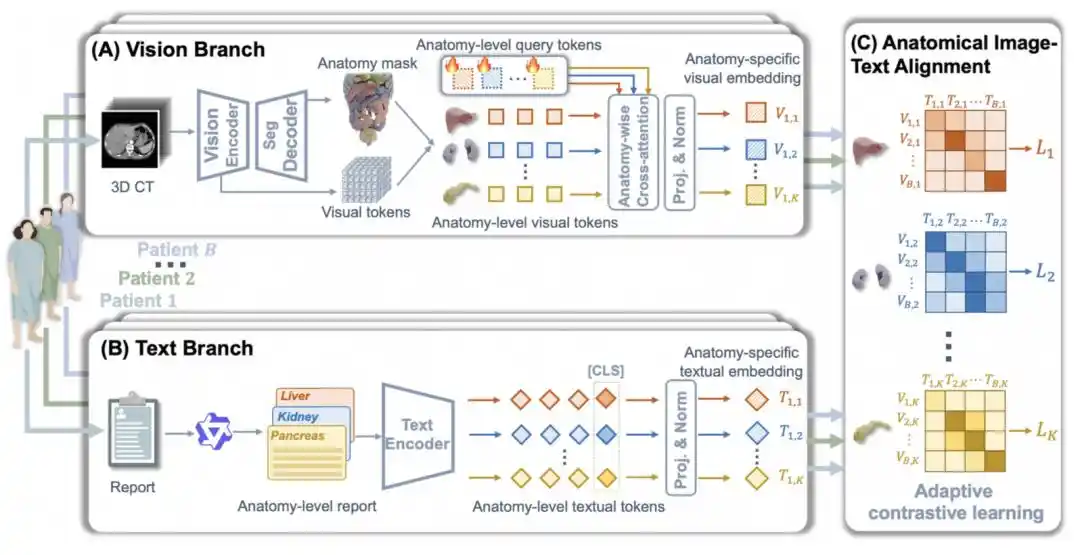
医院里天然存在大量CT影像和对应的诊断报告,RADAR直接从影像和报告文本的对应关系中学习,不需要医生额外逐片标注。
这有点像医学生跟着主任查房,主任看片子的时候会说“肝脏有一个低密度灶,考虑血管瘤”,学生听多了,自然就知道什么影像特征对应什么诊断。
但直接把整张CT和整份报告对齐,效果很差。
团队一开始就试过这条路,结果发现模型只能学到一些粗糙的统计特征,建立不起来“哪个器官对应哪段描述”的关联。
因为一套腹部CT有几百张切片,包含好多个器官,真正有问题的可能只是某个器官上一个很小的病灶,如果让模型拿整张图去理解,关键信号就被大量正常组织淹没了。
这就涉及到了RADAR的核心突破——“器官级细粒度对齐”。
它先从CT中定位出肝脏、胰腺、胆囊、肾脏等各个器官,把一整套CT拆解成一个个器官单元,再把每个器官单元和报告中对应的描述精确对齐。
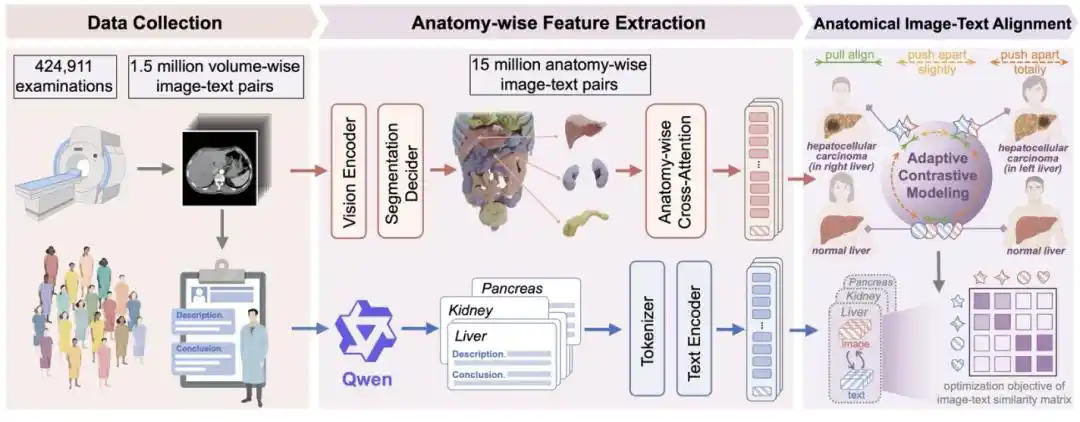
这一设计的灵感,来自放射科医生的真实工作方式。
医生看腹部CT时,也不会把整个腹部当一个整体扫一眼,TA们会依次看肝脏、胰腺、胆道、肾脏、肠道,一个器官一个器官地过。RADAR让AI也按这种方式去学习。
另一个创新叫自适应对比建模。
标准的对比学习默认把不同病人的特征严格区分,但在医疗场景里,如果两个人的肝脏都是健康的,就不应该被割裂看待。
同理,得了同一种病的两个患者,影像特征也应该被放在一起学习。
RADAR会根据这些医学知识,动态调整样本之间的距离。
而且论文里展示的Scaling Law曲线显示,随着数据增长,模型性能还在持续上升,曲线没有饱和的迹象。
帮医生“少漏一个病灶”
Scaling Law曲线还在涨,但眼下RADAR够到的能力,已经开始改变一线医生的工作节奏了。
“第一次看到RADAR的验证数据,我都不敢相信。”浙大一院放射科主任肖文波说,AI能在腹部这么多相似结构里一下子检出146种病,AUC还有0.9上下,完全超乎医生们的想象。
科室里开始沸腾,很多医生说:赶紧部署起来!很多外面医院的医生也闻讯前来,希望AI能帮助他们解决腹部CT这个头疼的问题。
肖文波干了三十多年影像,带着300多人的科室,科室每天处理几千份片子。
写一份腹部CT报告,哪怕中高年资的医生,没有20分钟下不来,一例CT包括数百张图像,挨个过。
这活儿她太清楚有多难了。
直到她发现RADAR接受了一次又一次验证,准确率还是差不多之后,她才真的服了。
影像科有句话叫“同病异影、异病同影”,同一种疾病可以长成完全不同的样子,不同的病又可能看起来一模一样。
肖文波坦言,一个医生可能要看几十万张片子才能把各种特征都见过一遍,可能穷其一生也见不到如此多的病例。
这恰恰是RADAR最大的价值,它补上了人类医生的盲区,能够帮他们少漏一个病灶。
尤其在良恶性鉴别这种生死攸关的场景,医生的压力非常大;这时候有了AI,就相当于随时有一个影像助手在手边,在医生犹豫的时候给一个补充性参考。
不过AI辅助也会带来一些隐忧。
这说的倒不是准确率,毕竟即使用AI,最后也有真人在一旁把关。
这个问题关乎的是未来医生群体的发展。
医生培养讲究影像逻辑思维,这种思维从理论到实践反复打磨,这个过程不能跳过。
年轻医生用了AI,报告可能会达到主任级水平,一旦形成路径依赖,反而把培养路径截断了。
但也不必过虑。
肖文波的想法,是让RADAR同时变成“一对一带教工具”。
她说现在科室300多人分布在好几个院区,过去那种老师坐旁边一份一份带着看的模式,已经很少了。
但AI可以替代这个角色,年轻医生按常规写完报告,再用AI做一次自我检测,哪个病灶漏了、哪个判断偏了,当场就知道。
就像随时有个主任站在旁边说,“哎,这还有一个病灶,你怎么没看见?”
这样,每个病例都变成一次交叉验证和学习的过程。
再往远看,RADAR的器官级对齐框架,也适配其他影像模态,只要有相关数据,MRI、PET、超声都可以成为迁移的目标。
而且这些东西,达摩院没有藏着,模型、代码、技术框架已经全部开源,任何团队都可以拿去复现、改进、迁移到自己的场景。
说到这里,其实已经不只是一个医疗AI的故事了。
RADAR背后的思路,是用一个通用模型,去解决一整个领域的问题。
医疗是所有行业里对精度要求最极端、对错误容忍度最低的场景,一个误判就可能改变一个人的治疗方案甚至生存期。
如果这套范式在这里都能跑通,那换到其他高精度场景,大概率也能适用。
达摩院资深算法专家张灵说,“Science极少发医疗影像AI的文章,因为它长期被当做工程技术问题。RADAR首次证明了通用的医疗影像AI是一条具有现实可行性的技术路线,改变了Science审稿人的想法,审稿人开始把它当作‘科学问题’来对待。”
RADAR能过这道门槛,说明这套方法经受住了最严格的同行评议。
回过头看,从达摩院几年前用PANDA模型攻克胰腺癌筛查难题,到今天RADAR登上Science,其实都是在求证AI到底能不能在最苛刻的真实场景里真正顶上去。
今天Science给出的答案,不只是对一个模型的认可,也是对一种可能性的确认。
它证明,用通用AI去啃最硬的骨头,这条路走得通。