这项研究表明多模态大模型的可靠性问题不能只关注语言端,让模型“看得更准“才是通向可信多模态感知的必经之路。
文章作者、来源:新智元
多模态大模型的物体幻觉,长期被归因于语言先验。
先看下面两组对话。
第一组,一张只有小狗的照片,问模型「图中有椅子吗」,它答「没有,图中是一只狗」,完全正确;
第二组,另一张照片,问「图中有餐桌吗」,模型却言之凿凿地回答「有一张餐桌,还有一个男孩站在它前面」,而画面里根本没有餐桌。
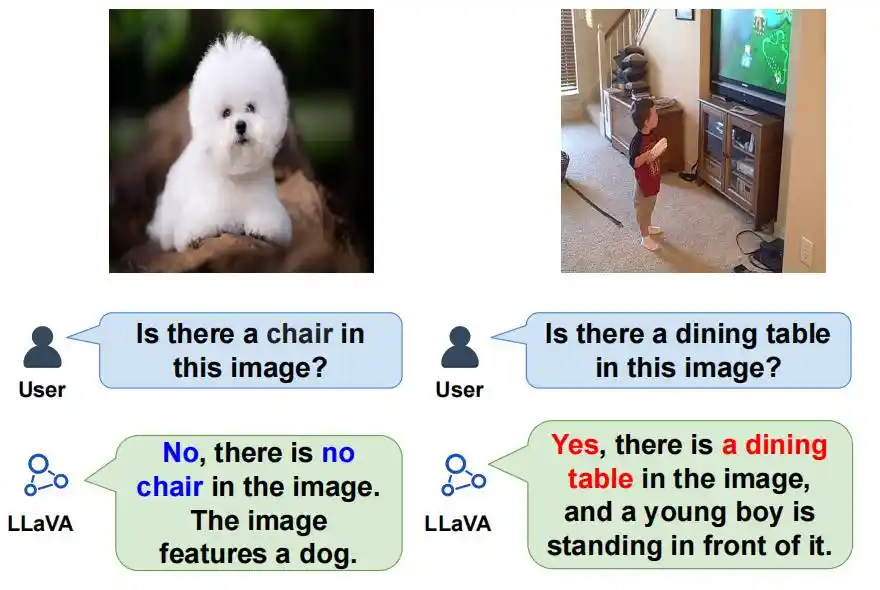
这就是困扰多模态大模型(MLLM)落地的物体幻觉:模型会「看见」并不存在的物体,或者对明明存在的物体视而不见。在自动驾驶、医疗辅助等高风险场景中,这种错误的代价可能非常高。
过去的主流解释是:这都怪语言先验。
模型在训练语料里见惯了「餐桌」和「男孩」共同出现,于是即便图里没有,也顺着语言统计规律说了出来。
但清华大学的研究团队认为,这个解释并不完整。
近日,来自清华大学的团队在ACM MM 2026(第34届ACM国际多媒体会议)论文中提出:当模型输出很短时,比如只回答Yes/No,推理更依赖视觉模态,此时会浮现出另一套幻觉机制,它根植于视觉特征提取本身。
研究人员将其命名为视觉源幻觉(visual-origin hallucination),并提出了对应的解法ACFT。
实验表明,ACFT仅使用COCO数据集0.9%的数据量、且不增加任何推理开销,就在POPE、MME及四个描述级幻觉基准上,于LLaVA、MiniGPT-4、Qwen2.5-VL三个模型上取得了优异表现。
研究背景
物体幻觉一直是MLLM可靠性的核心障碍。已有工作大多沿着「语言先验」这条线索展开:有的归因于对文本共现统计的过度依赖,有的定位到专门关注文本token的「幻觉注意力头」,有的指向摘要token的注意力汇聚现象,还有的认为是细粒度推理监督不足。
相应地,缓解方法也按干预位置分成几类:VCD、OPERA等在解码阶段做输入级干预;Woodpecker借助外部grounding模块做输出后处理;以及RLHF、DPO一类的后训练对齐方法。
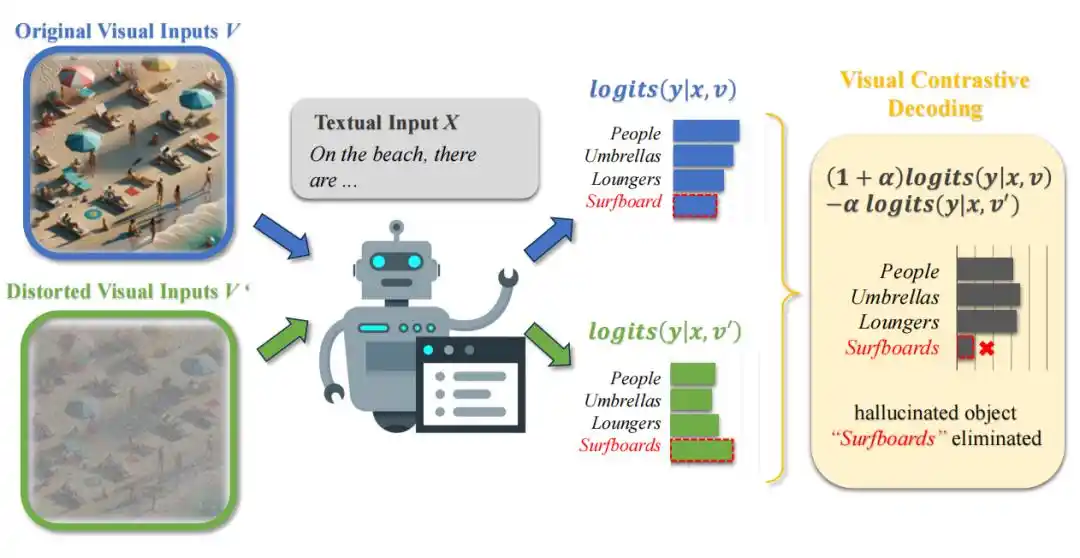
但这些方法有一个共同前提:幻觉主要来自文本侧偏置。这一假设在长文本输出场景(如“详细描述这张图“)下确实成立,因为丰富的上下文会放大语言偏见。
问题在于,当输出退化为一个「有/没有」的短回答时,语言先验能起的作用大幅削弱,而这类方法的效果也随之下降。那么,此时的幻觉究竟从何而来?
研究方法第一步:诊断,视觉源幻觉存在吗?
研究人员在LLaVA v1.5上做了两组互补分析,给出了量化证据。
发现一:图文嵌入错位。
幻觉样本的图像-文本嵌入余弦相似度显著低于正确样本。正确样本平均为0.158,幻觉样本平均为−0.122,表明跨模态对齐出现了系统性崩塌。
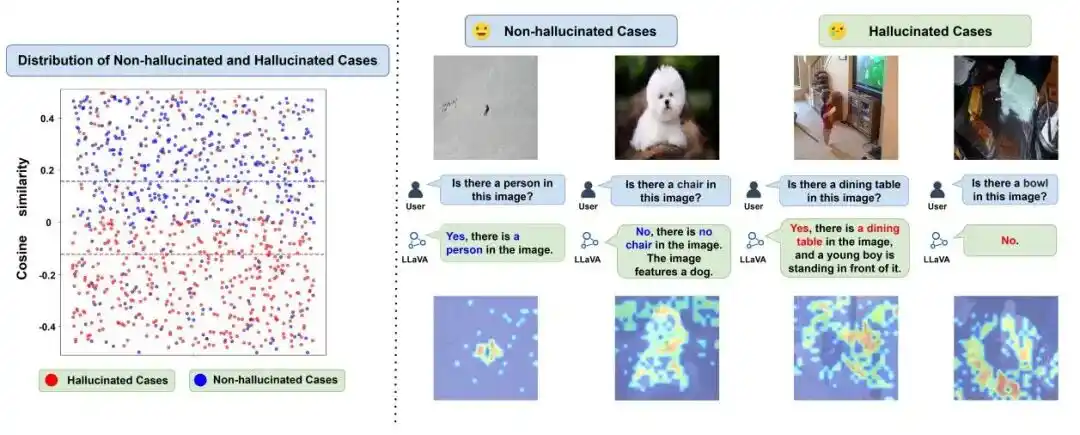
发现二:注意力模式反转。
研究人员用Smooth Grad-CAM可视化模型注意力,并定义了一个「语义合理」的分布标准:目标物体存在时,注意力应聚焦于目标区域;目标物体不存在时,注意力应当分散。
在500个幻觉样本和500个非幻觉样本上,用归一化香农熵量化后发现,幻觉模型系统性违反了这一模式:物体存在时熵值高出5.1%,说明注意力过度分散,漏掉了目标;物体不存在时熵值低了6.2%,说明模型错误地聚焦在无关区域,从而触发幻觉。
因果验证。 为了确认这不只是相关性,研究人员直接对视觉编码器做干预:施加高斯噪声、降采样、换用更弱的编码器,POPE平均准确率从0.842降至0.739至0.822;反过来换用更强的SigLIP-SO400M编码器,准确率升至0.864。这为「视觉特征质量驱动物体存在性幻觉」提供了因果层面的支撑。
第二步:AHAF——用对抗扰动翻转幻觉属性
诊断指向了视觉错位,那么对比学习是最直接的修正思路。但研究人员发现,普通对比微调(OCFT),即把匹配图像作正样本、随机取一张无关图像作负样本,效果并不理想。
原因在于:正负样本之间的特征差异不可控,也没有聚焦在目标物体上,模型很难学到究竟是哪些视觉特征触发了幻觉。
为此,研究人员提出AHAF(Adversarial Hallucination Attribute Flipping,对抗幻觉属性翻转):用PGD在极小的ℓ∞球内对原图施加定向对抗扰动,把一张不引发幻觉的图像「翻转」成引发幻觉的图像。这样构造出的正负样本对完全对齐,唯一差异就是那个受控的扰动。
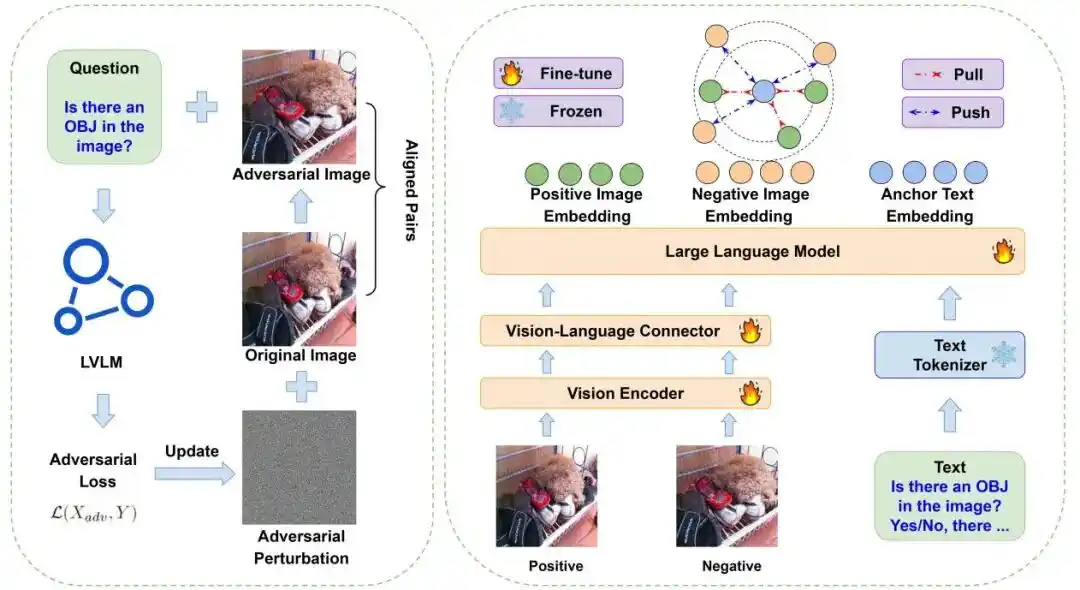
AHAF还有一个副产品价值:它同时是一个诊断探针。极小的像素级扰动就足以翻转模型的答案,这说明MLLM的视觉表征即便在干净图像上,也已经危险地贴近幻觉决策边界——这一现象反过来印证了「视觉源幻觉」的诊断。
第三步:ACFT——对抗对比微调
基于AHAF生成的对齐样本对,研究人员设计了ACFT(Adversarial Contrastive Fine-Tuning):在嵌入空间中最大化文本锚点与正样本图像的相似度,同时最小化其与负样本图像的相似度。
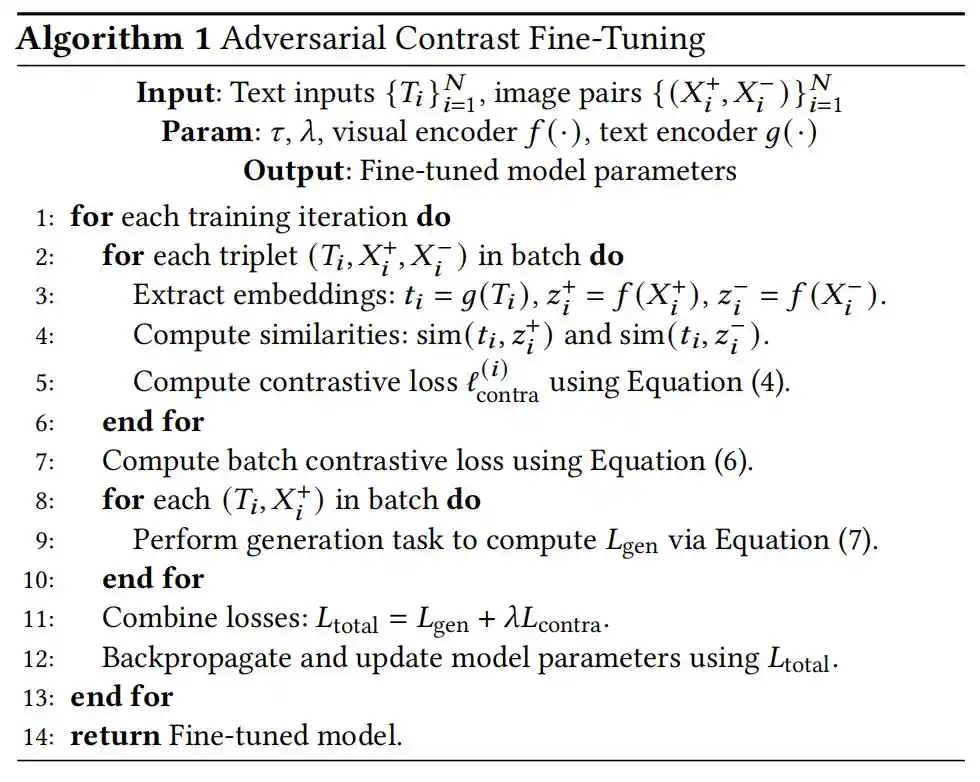
整套方法有三个工程上的好处:不依赖特定骨干架构、只需少量数据、且完全在训练阶段完成,推理时零额外开销。
实验结果
研究人员在LLaVA v1.5-7B、MiniGPT-4 13B、Qwen2.5-VL-7B三个模型上做了系统评估。基准包括POPE和MME。之所以选这两个,是因为它们的问题全部以Yes/No作答,正好对应本文关注的短输出场景。
主实验:POPE
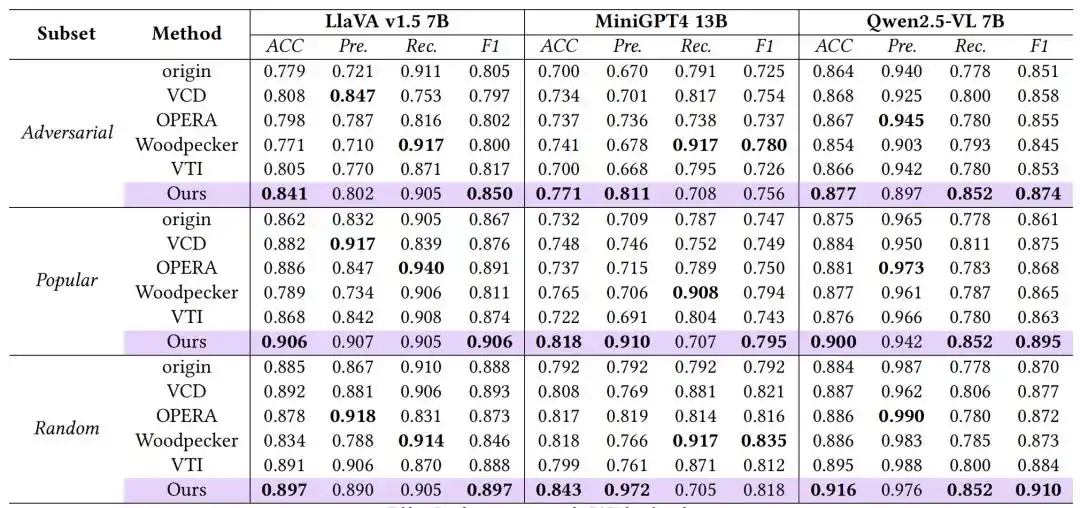
在LLaVA上,ACFT在三个子集分别取得0.841、0.906、0.897的准确率,比次优基线高出3.3%、2.0%、0.5%;在MiniGPT-4上分别领先次优基线3.0%、5.3%、2.5%;在本身基线已经很强的Qwen2.5-VL上,准确率依然从0.864、0.875、0.884分别提升到0.877、0.900、0.916。
关键消融:对齐的样本对到底有多重要?
这是论文中最能说明问题的一组对比。研究人员用同样的3000张COCO图像,分别训练OCFT和ACFT。
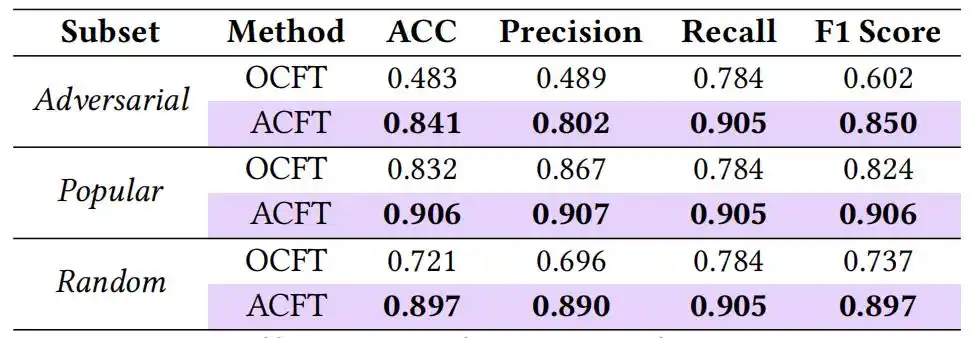
结果是:ACFT在三个子集上的准确率分别高出OCFT 35.8%、7.4%、17.6%。
尤其在Adversarial子集上,OCFT只有0.483的准确率,甚至远低于未经微调的原始LLaVA模型,说明不对齐的负样本不仅无益,反而有害。
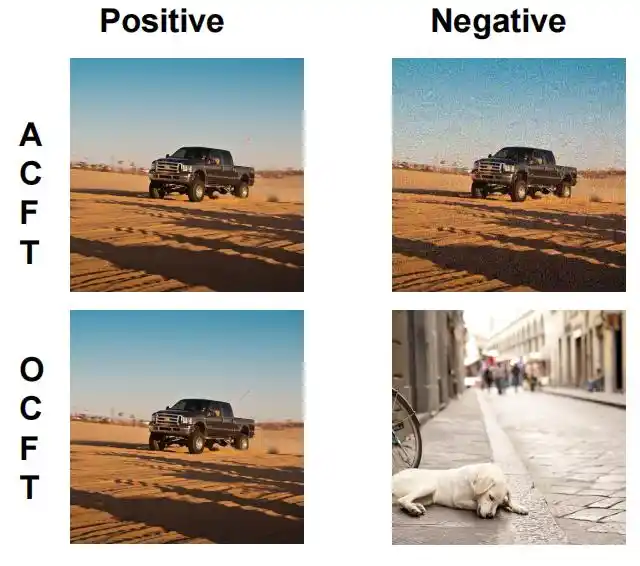
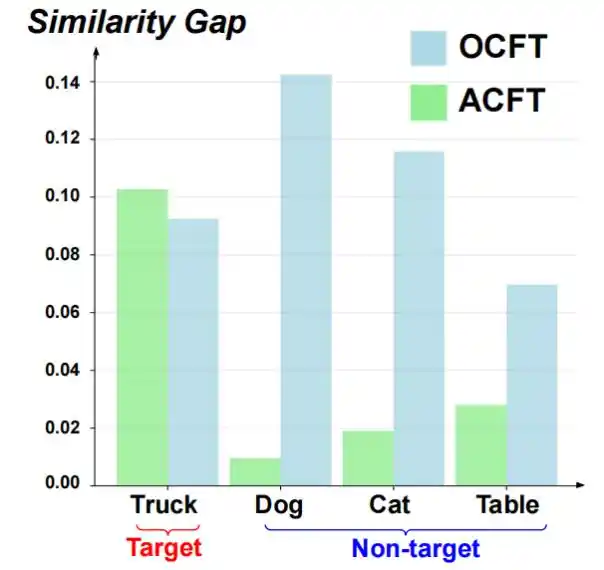
进一步的相似度差距分析给出了解释:在ACFT中,目标物体(truck)的正负样本相似度差距明显区别于非目标物体(dog、cat、table);而OCFT完全不具备这一性质。这意味着ACFT让模型学到了「一致的规则」,即去关注目标物体自身特征的差异。
可视化
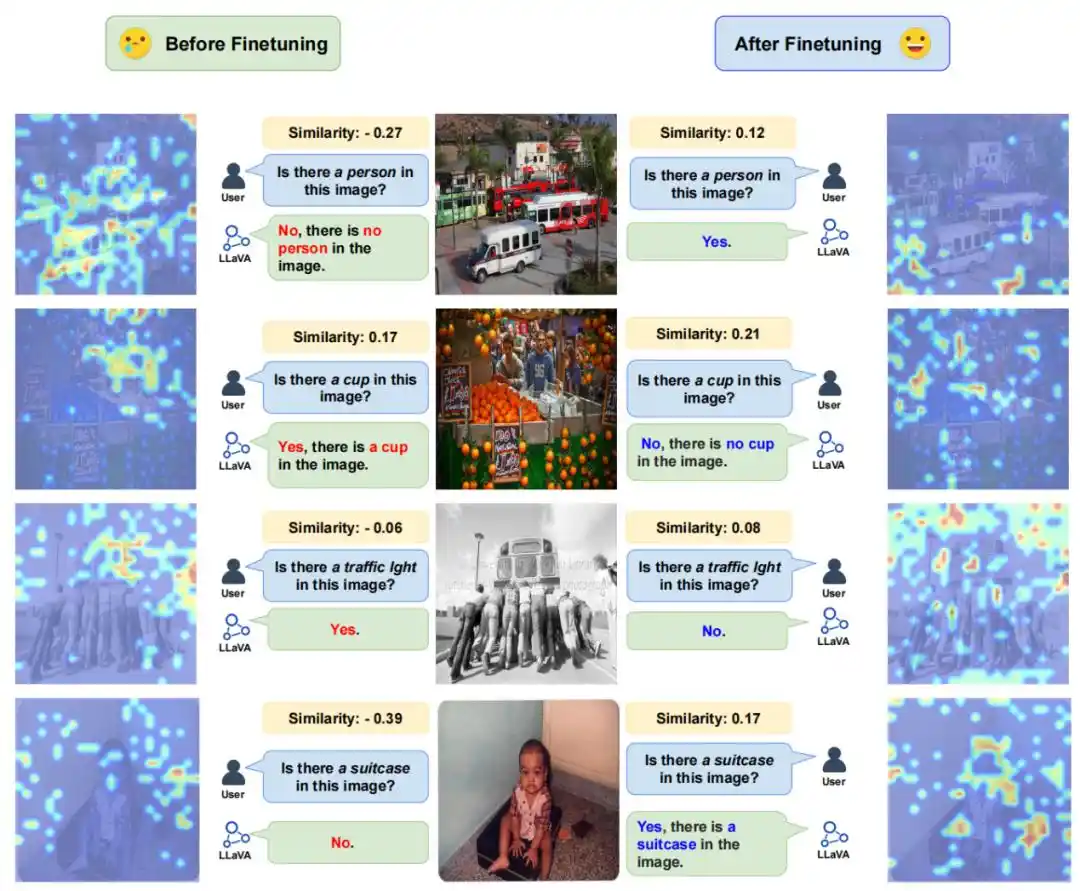
可视化直观展示了ACFT如何修正前文诊断出的两个「病征」:图文嵌入余弦相似度显著提升,Grad-CAM注意力也回归到语义合理的分布,即物体存在时聚焦,物体不存在时分散。熵分析进一步确认了这一修正:物体存在的案例熵值分别下降8.7%和2.6%,物体不存在的案例熵值分别上升7.4%和6.4%。
结论与展望
研究人员在已有「语言先验」解释的基础上,进一步识别并系统刻画了一类由视觉特征提取错误与图文嵌入错位驱动的幻觉机制,即视觉源幻觉。
在诊断的基础上,研究人员提出了AHAF与ACFT:前者既是揭示MLLM视觉表征脆弱性的诊断探针,也是对齐对比训练数据的高效生成器;后者则是一种仅需0.9% COCO数据、零推理开销的数据高效微调方法。
这项工作的意义不止于刷新指标。它提示我们:多模态大模型的可靠性问题,不能只盯着语言这一端。
当模型的视觉表征在干净图像上就已经紧贴幻觉决策边界时,任何只在文本侧或解码阶段做的补救,都可能是治标不治本的。让模型「看得更准」,或许才是通向可信多模态感知的必经之路。
作者介绍
论文作者依次为,徐沛阳(共同一作),清华大学本科生;朱小佩(共同一作),清华大学水木学者,合作导师为朱军教授;以及清华大学朱军教授和胡晓林副教授(通讯作者)。