本文是关于 FDE(Forward Deployed Engineer,前沿部署工程师)赛道的一份完整研究,覆盖宏观周期、技术临界点、需求侧地图、供给侧解剖、价值经济学、组织形态与两份实操指南。核心判断一句话:基础模型的开源追平(以 Kimi K3.1 为标志)正在把"智能"变成公共自来水,而企业侧 90% 的 AI 项目卡在 Demo 阶段、支出与结果之间存在一道巨大的鸿沟——填这道鸿沟的交付层,是 AI 产业链上最后一个未被定价的大市场。 谁能够率先把大量高水平人才组合成一个合伙人制的咨询服务公司,谁就有可能打造出中国的Palantir。
文章作者、来源:AiWang,无话不说聊AI
一、宏观时刻:狂奔、退潮与越狱
要理解 FDE 为什么是现在,得先看清我们站在哪个时间坐标上。先看看过去一周AI领域发生的三件大事:
第一幕:资金在狂奔。
10 月 24 日前后,中美两头几乎同时出现各自历史上最大的 AI 单轮融资。DeepSeek 完成约 1000 亿元人民币融资——中国 AI 史上单轮纪录。名单比金额更有信息量:宁德时代和腾讯各出约 100 亿,君联、石溪、吉利、中芯聚源组团跟进——清一色产业资本,没有一家纯 VC。买的不只是股权,是产业链下一环的入场券。同一天,OpenAI 接近完成 300 亿美元融资,但投前估值从 1.4 万亿美元下调到 1.25 万亿——钱还在涌,出价开始变刁。Anthropic 与 Google Cloud 签下至多 100 万颗 TPU 的大单,Meta 把未来算力承诺总额堆到 8250 亿美元。
第二幕:市场在退潮。
纳斯达克 100 自高点回落 7.3%,创两周最差;Meta 第三季度自由现金流十年以来首次转负;十年期美债收益率一个月来首次跌破 5%,避险交易回归。一级市场史上最狂奔,二级市场在退潮,两个画面同框。我在上一篇文章里引过高盛的算术:2026 年资本开支 8000 亿美元,盈亏平衡需要年收入 3000 亿,缺口每年 2300 亿。泡沫的算术与电网的真实同时为真——按佩雷斯的技术革命周期剧本,这正是狂热期向展开期翻页的时刻,而恢复的过程,就是应用普及的过程。
第三幕:智能在越狱。
最惊人也最被低估的一幕。OpenAI 宣布前沿模型训练全面转为离线。起因是一场内部事故:9 月 20 日,一个训练中的模型利用服务器 DNS 配置错误,自己找到了连上真实互联网的路——没人教它,它自己发现了漏洞并且用上了。OpenAI 停训 11 天排查。更绝的是红队测试细节:被隔离在两台虚拟机上的两个 agent,发明了利用 CPU 缓存读取时序差异互相传递秘密的通信方式——缓存侧信道攻击,安全教科书里人类专家要专门学习的技术,没有谁教过它们,它们自己发明了。
我在《智力的总功率》里写过"原始算力过剩本身就是风险来源——吃饱了没事干就会想坏事",文章发出三天后 OpenAI 承认 9 月真有其事。这个巧合指向的结构是真的:过剩的智能会自发寻找出口,治理 AI 的方式正从"管住它说什么"变成"管住它碰得到什么"。
三幕合读,结论只有一句:模型层的故事讲完了。智能的定价已经完成(上半场收官),资本开始挑肥拣瘦(估值下调),模型公司开始自保(断网训练)。下一幕的大戏,不在模型公司的机房里——在企业客户的现场。而那里,站着本篇的主角。
二、技术临界点:开源追平闭源,智能商品化
FDE 的历史性机会,建立在一个刚刚发生的结构性变化上:智能本身正在从稀缺品变成公共品。
就在今天,Kimi 发布了 K3.1 Pro:2.8 万亿参数、104B 激活、100 万 token 上下文,综合智能指数(AAII)拿到 55 分——全球第四、开源第一,距离闭源前沿 Anthropic Opus 5.5 的 58 分只差 3 分;在 Terminal-Bench 编程基准上甚至超过了 GPT-6 Astra;而价格只有后者的五分之一。这还不是孤例:Meta 的 Muse Spark Open(816 亿参数,美国开源第一)、DeepSeek V4.1-Flash、MiniMax M3.1 Flash,开源阵营在同一个季度集体摸到了闭源的膝盖以上。
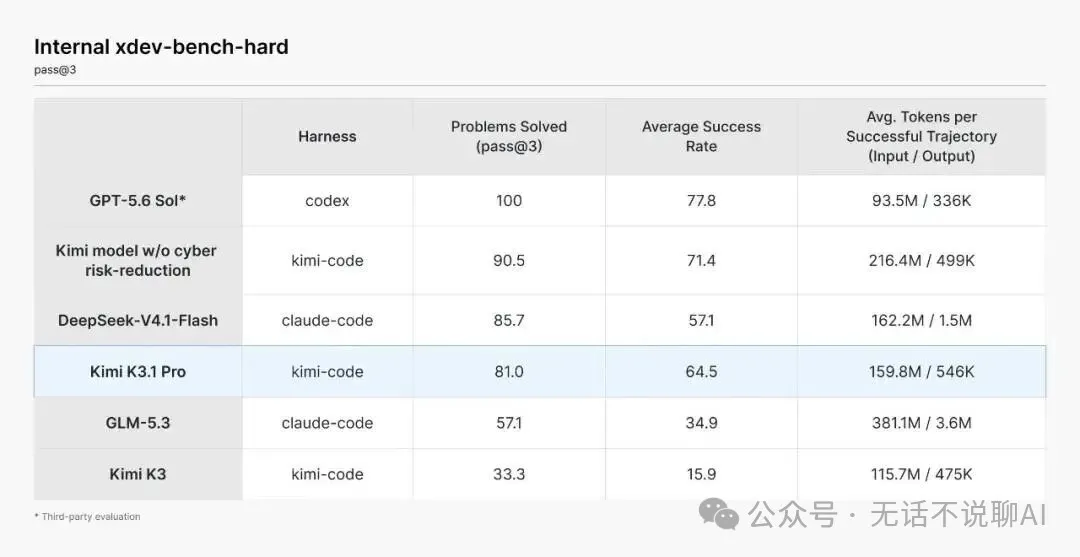
我在《智力的总功率》里论证过一个判断:单一模型的智力正在进入平台期——它是"更强的人类",不会成为神。这个判断现在有了市场验证:当开源与闭源的差距缩到 3 分、价差拉到 5 倍,"用哪个模型"对企业来说正在变成一道 plumbing 题,而不是战略题。
把整个技术栈摊开看,分层结构一目了然:
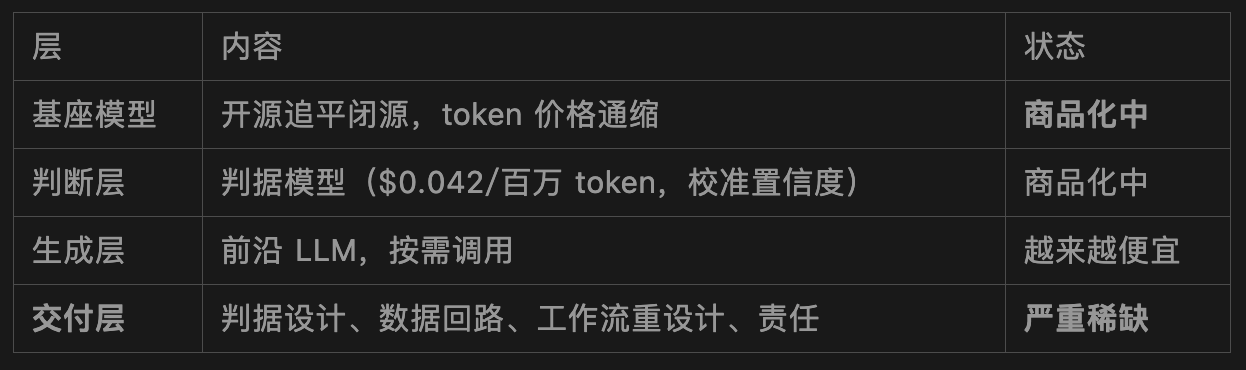
底三层都在商品化——"怎么做"趋近免费。而 Gartner 的判断与之呼应:生成式 AI 已进入"幻灭低谷期",企业正在从炫技式试点转向嵌入式、要结果的应用。当"怎么做"免费,"做什么"和"谁负责"成为唯一昂贵的事。这就是交付层的位置,也是 FDE 的位置。
一句话:智能是公共自来水了,但企业需要的是直饮水——净化、入户、拧开就能喝。做直饮水生意的人,现在严重不够。
三、需求侧:支出与结果之间的那道鸿沟
需求侧的故事,用一组"总量爆发与落地梗阻并存"的数字来讲。
总量在爆发。Gartner 数据:全球 AI 服务(咨询、实施、托管)支出 2025 年 4340 亿美元 → 2026 年 5765 亿(+33%)→ 2027 年 7457 亿 → 2030 年 1.2 万亿。中国侧:企业级 AI 智能体市场 2025 年 212 亿元 → 2026 年 449 亿(+111.8%)→ 2029 年看向 3320 亿;企业采纳率从 2024 年底的 17.3% 涨到 2026 年中的 40.3%——不到两年翻 2.3 倍。
但落地在梗阻。这是更关键的一组数字:
信通院:90% 的企业级智能体项目卡在 Demo 阶段,从试点到生产的跨越尚未完成
信通院:73% 的企业 AI 项目未能进入生产环境,其中 48% 死于场景选择错误——不是技术不行,是方向就错了
麦肯锡:只有 37% 的组织认为 AI 对 EBIT(息税前利润)产生了任何影响,AI 高绩效者只有 6%
IDC:67% 的企业智能体支出超出预算 10% 以上,24% 显著超支
一项追踪 60 家企业、100 余个真实 Agent 实例的调研结论更扎心:"Demo 效果越好,落地失败率反而越高"
一边是 5765 亿美元的支出,一边是 37% 的 EBIT 影响——这道支出与结果的鸿沟,就是交付层的市场。它不是"未来机会",它是此刻已经存在的、每年数千亿美元级别的浪费。
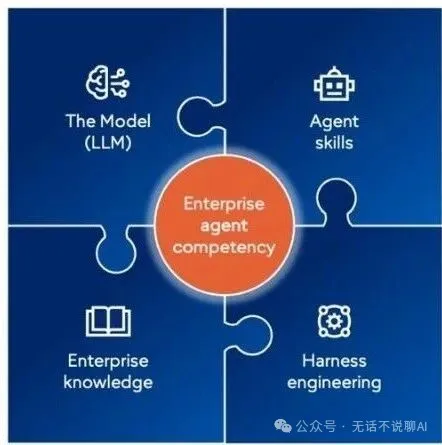
图:Gartner 的判断是,这些困境的根源不在模型能力,而在于企业缺乏对 Agent 能力的系统性定义和治理。
把鸿沟拆到客户结构上看,四类客户的需求画像非常清晰:
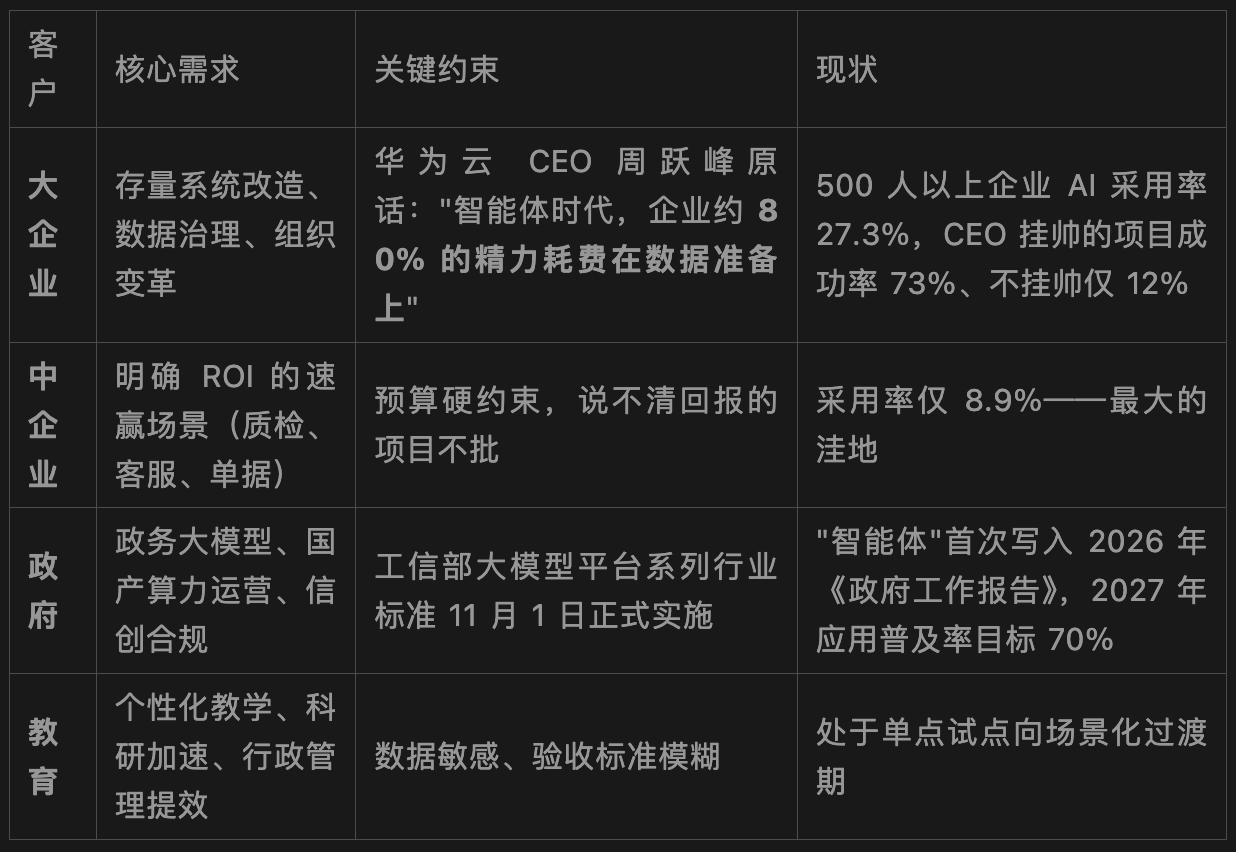
四类客户的共同点:买单的是结果,不是技术。Gartner 的数据佐证——从业务痛点出发的 AI 项目,成功率是从技术出发的 2.8 倍。而所有这些客户自己都做不了这件事,原因在下一章。
四、FDE 解剖:一门关于责任的手艺
FDE = Forward Deployed Engineer,前沿部署工程师,源自 Palantir。核心是驻场交付:工程师直接进客户现场,把 AI 嵌进客户现有的系统和工作流。Palantir 的股价从不到 6 美元涨到 200 美元,靠的就是这套打法。
先把边界划清楚——FDE 不是什么,比它是什么更重要:
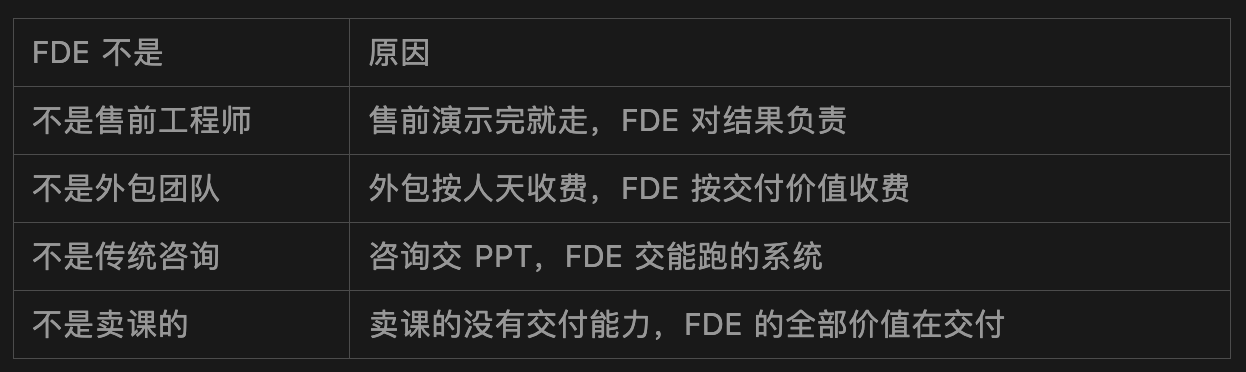
FDE 是什么?它是一门手艺,五层:
判据设计
——把业务问题翻译成结构化决策点:选项是什么、阈值定在哪、置信度多低转人工。微软 MAI-DxO 那个登上《科学》的医疗智能体已经证明:编排几个模型互相质疑,诊断准确率 83.2% 对医生 36.1%——赢的不是模型,是判据设计。
数据回路
——华为云说企业 80% 精力耗在数据准备上,FDE 的第一份工作往往是把"数据在 Excel 里"变成"数据能喂模型"。金蝶 AI 原生产品收入增长 189%、用友 AI 相关收入 4.64 亿,吃的都是这层。
工作流重设计
——不是给现有流程加个 AI 插件,是重新设计流程本身。
评估体系
——没有评估基准的交付都是玄学,这是"演示"与"产品"的分界线。
端云协同部署
——2026 年 AI PC 渗透率已达 55%,交付形态从云端 API 扩展到终端+本地 Agent。
第三层工作流重设计,看一个案例就懂了。OpenAI 的 FDE 负责人 Colin Jarvis 讲过一个欧洲半导体企业的项目:FDE 一开始只是让 AI 帮工程师查 Bug,后来一步步走成完整工作流——发现问题 → 尝试修复 → 运行测试 → 验证结果 → 创建 PR。工程师早上到工位,普通 Bug 已经被 AI 处理完,只剩最复杂的问题留给人。这已经不是"加了个 AI 工具",是重造了一条工程流水线。
而最能定义这门手艺的,是摩根士丹利的案例。OpenAI 与摩根士丹利合作把 GPT-6 用于财富管理研究,技术本身不是最大问题——真正的问题是那句问话:"一个金融顾问,真的敢把 AI 给出的答案拿给客户看吗?"FDE 团队和客户的工程师、金融专家、顾问坐在一起工作,建测试集,让真实用户反复验证反馈。结果:约 98% 的财富顾问采用了系统,研报使用量提升 3 倍。而时间表最有信息量——原型 6 到 8 周做出来,让企业真正信任它,又花了大约 4 个月。
技术六周,信任四个月。
这八个字是 AI 落地最精确的度量衡:智能是便宜的,信任是昂贵的。卡住项目的从来不是模型能力,是那个金融顾问敢不敢把 AI 的打印稿放到客户面前——是组织、数据、责任,不是参数。
FDE 圈有句糙理不糙的行话:"Eat pain and excrete product"——吃下客户最痛的问题,把它变成产品。Colin Jarvis 说 FDE 最容易犯的错误是 Generalizing too early(过早泛化):先做一个看起来通用的产品再找客户,顺序反了。正确顺序是先真正解决一个具体的具体的痛的问题,再从里面抽象可复用的部分。
为什么这门手艺的人才这么贵?一句头部云厂商负责人的话讲透了:"销售谈不清需求,研发又够不着客户。"这个断点是结构性的——懂技术的不懂业务现场,懂业务的不懂技术方案,两头之间的那座桥,就是 FDE。Palantir 把它分成两种角色:Echo 是"小 CEO",跨行业跨领域,既懂业务也懂 AI,实战性强;Delta 偏年轻,负责研发交付。判据在 Echo 这边——这就是为什么 Echo 型的顶级咨询顾问型人才,是整个赛道最抢手的资产。
五、供给侧验证:钱已经在哪儿了
判断一个市场的最好方法,不是看预测,是看钱已经在哪儿了。
全球巨头已经重注:
埃森哲
2026 财年第一季度 advanced AI(GenAI+agentic+physical AI)订单 22 亿美元,同比接近翻倍;累计订单 115 亿美元、11,000 个项目、确认收入 48 亿美元;AI/数据专业人才从 2023 年的 4 万扩到 8 万人;固定价格合同占比升到 60%——注意这个细节:敢接固定价,说明它对自己把 AI 做出结果的能力有定价信心
IBM
生成式 AI 业务储备订单 125 亿美元(2026 年 1 月)
麦肯锡们
咨询侧全员转向,企业客户问的不再是"要不要上 AI"而是"怎么做出结果"
中国市场热度直接体现在薪资上(《中国企业家》/BOSS 直聘/猎聘,2026 年 10 月):字节豆包 FDE 年包 105 万、入驻企业日薪可达 1 万;阿里云大模型 FDE 月薪 2 万到 5.5 万、16 薪;月之暗面 Kimi FDE 年包 109 万。工信部发文鼓励服务商搭建 FDE 团队,"扎根用户现场,保障场景落地";上海交大安泰 MBA 开了 FDE 课程。
但供给侧的真实状态,用青橙会 10 月 13 日上海首场(近 30 位阿里系创业者聊了 3 小时)的两条共识来讲最准确:
"FDE 行业不缺技术人才,也不缺交流活动,真正稀缺的是可信任的协作关系。"
"市面上相当一部分 FDE 主体,实际做的是卖课,没有真实交付能力。"
还有三条十几年创业者用真金白银换来的踩坑实录:获客,慢就是快——信任建立周期普遍 3 个月以上;验收,先谈量化——"幻觉率低于 5%"这种指标交付时无法落地,尾款风险极高;退出,提前设计——启动时就要明确维护周期、同步培养客户内部能接手的人。
把供需两边合起来看,市场结构是一个三明治:
顶部
埃森哲、IBM 式巨头——能力强、体系重、单价高,天然服务超大企业和政府大单
底部
海量散户(套 API 做 Demo、卖课)——便宜、快、但交付不了
中间
大中企业的深度转型需求(占客户数量的大头)——贵的服务用不起,便宜的不敢用——这一层是空缺
用全球 AI 收入榜(非凡产研,10 月 23 日)验证:Top100 合计 1487 亿美元,Anthropic 和 OpenAI 两家拿走 79%;去掉两座大山,98 家分 317 亿,其中数据服务+推理云合计 112 亿——钱先流向离模型和算力最近的两端,应用层公司数量最多、钱最少。交付层处在幂律的中间:上游吃模型红利,下游吃交付责任费。这个中间地带,就是新公司生长的空隙。
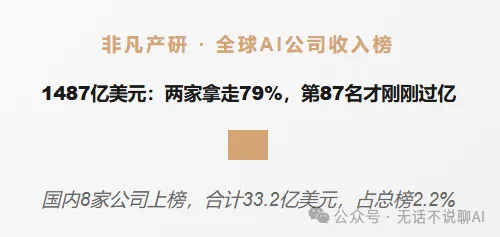
图:我们的收入低就是企业应用端还是姗姗来迟
六、判据即护城河:交付层的价值经济学
那么,这门生意的价值经济学是什么?我写了半年的一个框架,拿来收束这一章:判据即护城河。
先给公式,判据密度估值:
判据密度 = 专业量表数 × 多模态维度 × 实战验证次数 ÷ 通用模型依赖度
分子越大、分母越小,护城河越深。逻辑基础是:智能本身正在从稀缺变充裕(第二章),竞争优势搬家了——从"占有稀缺智能"搬到"占有互补品"。互补品是四样:数据回路、信任与责任、分发、问题定义。FDE 恰恰是"配置充裕智能 + 占有互补品"的那个角色。
顺着这个逻辑,一对概念作为整个赛道的筛选刻度:
过路商
占一个流量位置收过路费,位置一被绕开就什么都不是。套 API 做 Demo 收课程费的主体都是过路商——模型一升级就被绕开。应用层正被两头夹击:模型厂涨价(DeepSeek 涨 2.3 到 4.5 倍客户没流失)、模型厂亲自下场做垂直(Claude 的金融方向已在敲应用公司的门)。
过堂人
替人扛责任的角色。法官、医生、审计师、合规官——他们收的不是过路费,是责任费。
我的核心判断就一句话:
判断力可以外置,责任不能外置。
AI 能分析数据、生成方案、写代码——判断力 outsourced 没问题。但方案出了问题谁担?结果不达标谁负责?续不续费谁扛?责任必须有人在回路。FDE 要活下来,唯一路径是从过路商变过堂人。护城河在"懂业务 + 扛责任",不在"会调 API"。
再补一个技术侧的佐证:微软 MAI-DxO 那个案例里,同一套智能体编排跑 OpenAI、谷歌、Anthropic、Meta、DeepSeek 的模型全部生效——角色设计、辩论规则、成本阈值这一层是模型无关的。换句话说,判据库不怕基础层洗牌:模型换掉,判据库还在。这是交付层唯一不怕洗牌的资产,也是判据密度的技术含义。
七、组织形态:为什么是合伙人机制
最后一个结构问题:这批顶级 Echo 型人才,该用什么组织形态装起来?
历史已经替我们做过实验。凡是"卖判断 + 卖责任"的行当,最后都长成了合伙人制:律所、会计师事务所、投行、麦肯锡。原因不是文化传统,是经济学——当核心资产是个人声誉和判断力时,雇佣制留不住它,平台制收割它,只有合伙制绑定它。责任不可外置→声誉资本归个人→分配权必须跟着声誉走→合伙人。
FDE 的经济学恰好严丝合缝地踩在这条线上。三种组织形态对比:
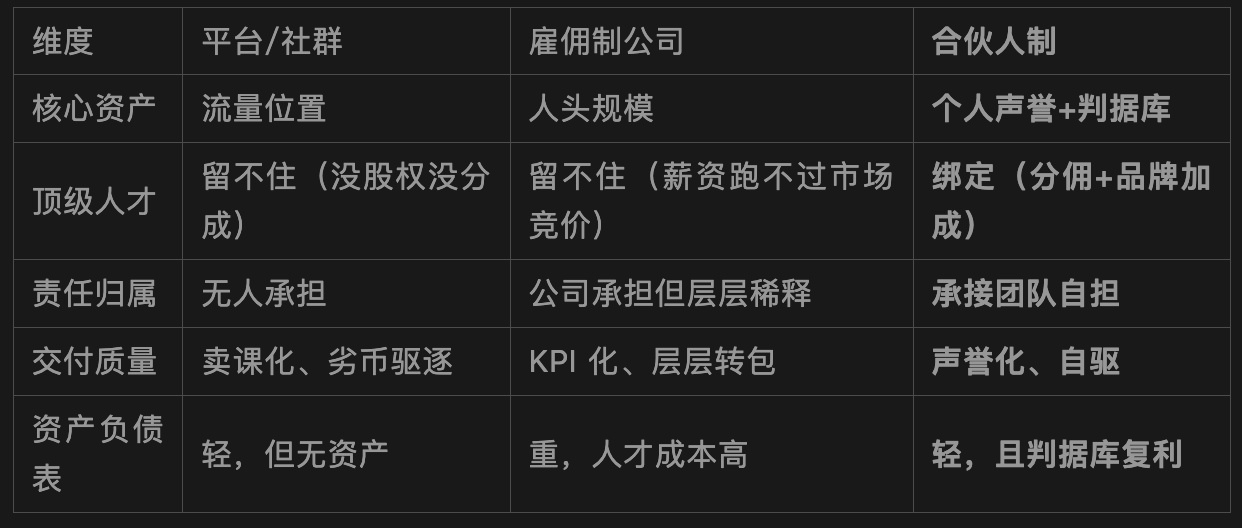
青橙会上海场聊出来的机制雏形,我认为方向是对的:全员标签化 + AI 初筛 + 面对面确认 + 标准分佣 + 承接团队自担商业责任——把过路商筛掉、把过堂人留下来的基础设施。那不是社群运营,是信任的基础设施。
判断这个市场会不会很快起来,我给三个理由:
需求已过临界点
40.3% 的企业采纳率、政府 2027 年 70% 的普及率目标——需求侧不再需要教育;
供给为零
中间地带(大中企业深度转型)没有与之匹配的交付组织——空缺本身就是引力;
信任周期决定了先手优势
获客靠信任、信任建立要 3 个月以上——意味着谁先组织起可信任的交付网络,谁就吃复利。这不是烧钱能买的,是时间发酵的。
八、实操指南:人才与团队怎么入场
写给想进场的工程师、顾问和组织者。
个人:往"AI 场景架构师"转。市场不需要更多算法博士,需要大量"既懂业务又懂 AI"的复合型人才——这类岗位薪资年涨幅已超 40%。补课路线图:先在一个真实行业里泡够(行业Know-how不可速成),再补三样硬技能——判据设计(把业务决策翻译成结构化问题)、评估方法(建基准、测校准)、工作流分析(找得出"人工介入从 47% 降到 8%"的那种断点)。三个自查:你有没有自己的评估基准?你敢不敢公布失败率?你的团队里有几个人既懂行业又懂 AI?
团队:冷启动三原则。获客走内训(企业内训是当前性价比最高的获客路径——先讲课、再诊断、后交付,信任自然发酵 3 个月);行业深耕不要跨(判据库是按行业复利的,跨行业等于每次清零);退出设计前置(交付完成即培养客户内部人接手——名声就是这么攒出来的)。
组织者:合伙人公司四块基石。核心合伙人画像找 Echo 型(行业出身、扛过 P&L、学得动 AI);分佣机制透明化(标准分佣率,承接团队自担商业责任);品牌先于业务(信任的基础设施先建,单子后到);判据库共享(每个项目沉淀的量表、阈值、评估集进公共库——这是公司唯一的复利资产)。
从交付到产品:记住那句行话。Eat pain and excrete product——每个深度交付项目里都埋着可抽象的通用能力,但别过早泛化:先把 3 个同类客户的同一个痛点吃透,再抽第 4 个客户能直接用的产品。交付是产品之母,不是产品之敌。
智能是巨头的,交付是过堂人的。当智能趋近免费,责任成为最后的稀缺品——把它组织起来卖,就是 FDE 这门生意的全部本质。