首创空间立体声生成框架 StereoGen 奠定AI影视游戏与音讯世界模型基石
文章作者、来源:HKGAI
近日,香港生成式人工智能研发中心(HKGAI)雪巍教授团队,联同国际音响巨头杜比实验室(Dolby Laboratories)发表的最新空间音讯研究论文,近日于巴西里约热内卢举行的国际多媒体顶级学术会议ACM International Conference on Multimedia 2026(ACM MM 2026)上,勇夺最高荣誉「最佳论文奖」(Best Paper Award)。
ACM Multimedia 是全球多媒体领域最具影响力的旗舰级国际学术会议,今年会议于本月 10 至14 日圆满举行,是次获奖印证 HKGAI 在多模态基础模型的科研实力已稳居世界顶尖行列,标志着「空间音讯生成」技术取得重大突破。
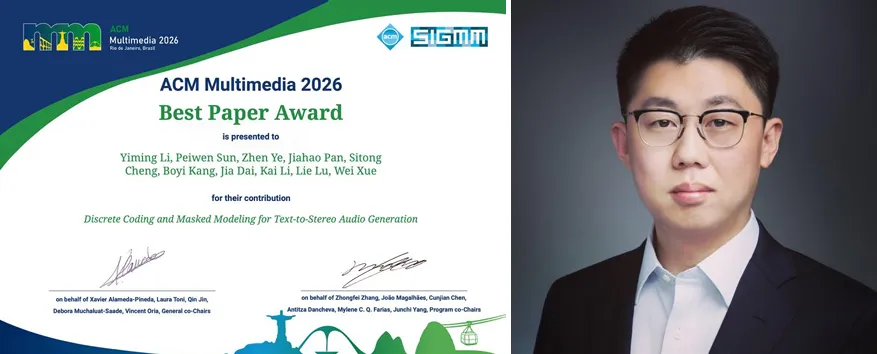
图一及二:HKGAI雪巍教授(右)团队联同杜比实验室(Dolby Laboratories),凭借空间立体声生成论文荣获 ACM Multimedia 2026「最佳论文奖」
告别「平面声音」 让AI懂得「听声辨位」
是次发表的论文题为《Discrete Coding and Masked Modeling for Text-to-Stereo Audio Generation》(面向文字生成立体声音讯的离散编码与掩码建模),深入探讨如何让AI仅凭一段文字描述,便能精准合成具备真实方位感与动态轨迹的空间立体声音讯,彻底解决传统AI音效平面化及声场失真的技术难题。
现时市面上大部分文字生成声音的AI工具,生成的往往是平面的单声道音讯──就像一个收音机喇叭,所有声音挤在一起,分不清远近和方向。即使强行输出双声道,亦容易出现声场塌陷或方向模糊的问题,难以应用于讲求临场感的电影或游戏制作。
而人类之所以能够听声辨位,是因为左右耳接收声音时存在极微细的时间和音量差异。HKGAI团队便从这个原理出发,研发出一套全新的空间立体声生成系统,包含三大核心技术组件:
StereoCodec(立体声离散编解码器):针对双声道讯号特点设计,引入符合人类心理声学(Psychoacoustics)的重建目标,将双声道音讯压缩为高保真离散 token,精准保留左右声道之间的微妙空间关系。 StereoGen(掩码生成式立体声模型):采用结合多模态与单模态的混合 Transformer 架构及掩码生成建模(Masked Generative Modeling)技术。创作者只需输入包含空间动态的文字指令(例如:「摩托车由右向左高速驶过」),模型即可高效生成具备真实空间移动轨迹的立体声音讯。
StereoCLAP(语义空间一致性评测框架):首创引入方向性「困难负样本挖掘」(Hard Negative Mining),有效衡量生成音讯与文字描述在语义及空间方位上的精准匹配度(例如准确区分声源在左侧抑或右侧)。
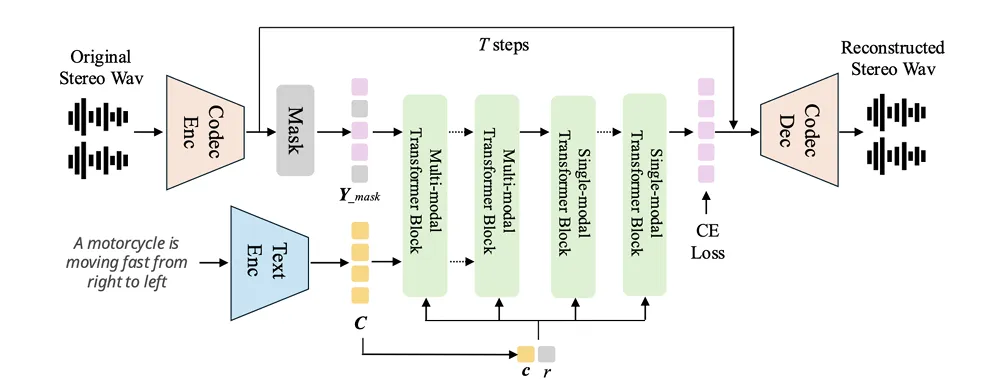
图三:StereoGen模型架构示意图-系统能理解「摩托车由右向左高速驶过」等空间移动指令,快速生成具备左右方位变化的立体声音讯
赋能AI影视与游戏开发 奠定音讯世界模型基石
这项突破将大幅降低AI影视作品、动画及游戏开发的后期制作门槛,能根据剧本或玩家位置自动配对具方向感的3D环境音效。同时,团队建立的空间音讯基础组件,亦为未来构建「声画合一」的多模态世界模型(World Models)提供了关键技术支点。