在AI的下半场,守住底线,往往比追求极致的上线,更具有决定生死的战略价值。
文章作者、来源:ME News
一、 引言:狂热退潮,AI产业触碰现实边界
生成式人工智能的狂飙突进,正在遭遇现实世界最猛烈的“规则阻击”。近期发生的两起标志性事件,彻底撕开了AI大模型在商业化进程中被刻意掩盖的隐患:一是字节跳动旗下最新视频生成模型Seedance 2.0因遭遇好莱坞及流媒体平台的版权纠纷,被迫紧急按下全球发布暂停键;二是央视315晚会曝光了名为GEO(Generative Engine Optimization,生成式引擎优化)的灰产业务,揭露了服务商通过技术手段人为操纵AI大模型输出结果,将特定商品广告伪装成AI“标准答案”的行业乱象。
这两则看似独立的新闻,实则指向了同一个产业命题:当AI模型从实验室的“技术极客玩具”跃升为重塑千行百业的“基础设施”时,其底层的数据获取合法性(版权问题)与输出结果的客观性(信任问题),已经成为决定这项技术生死的两道红线。
根据 ME News 智库的长期跟踪与研判,当前全球AI产业正处于从“技术竞赛”向“合规与生态构建”转型的深水区。无视知识产权的“野蛮爬取”时代已经终结,而放任输出结果被商业资本操纵的“黑盒模式”也将彻底摧毁受众对AI的信任基石。本文将深度剖析AI版权纠纷与GEO操纵背后的逻辑,并为决策者提供破局的战略路径。
二、 版权修罗场:大模型“数据饥渴”与创作者权益的零和博弈
字节跳动Seedance 2.0的受挫并非孤例,它是全球内容产业对AI无序扩张发起反击的缩影。视频生成模型对高质量、高连贯性、带标注的专业级视频数据有着极高的要求。好莱坞制片厂及顶级流媒体平台掌握着全球最优质的影视版权库,当它们发现AI巨头在未经授权、未支付对价的情况下,利用其耗费巨资打造的内容来训练可能颠覆其自身行业的模型时,爆发冲突是必然的。
核心观点:知识产权不是阻碍AI发展的绊脚石,而是重塑商业规则的过滤器
长期以来,科技巨头普遍奉行“先创新,后合规”的硅谷逻辑,试图将未经授权的数据爬取辩护为“合理使用”(Fair Use)。然而,这种逻辑在生成式AI时代正在失效。
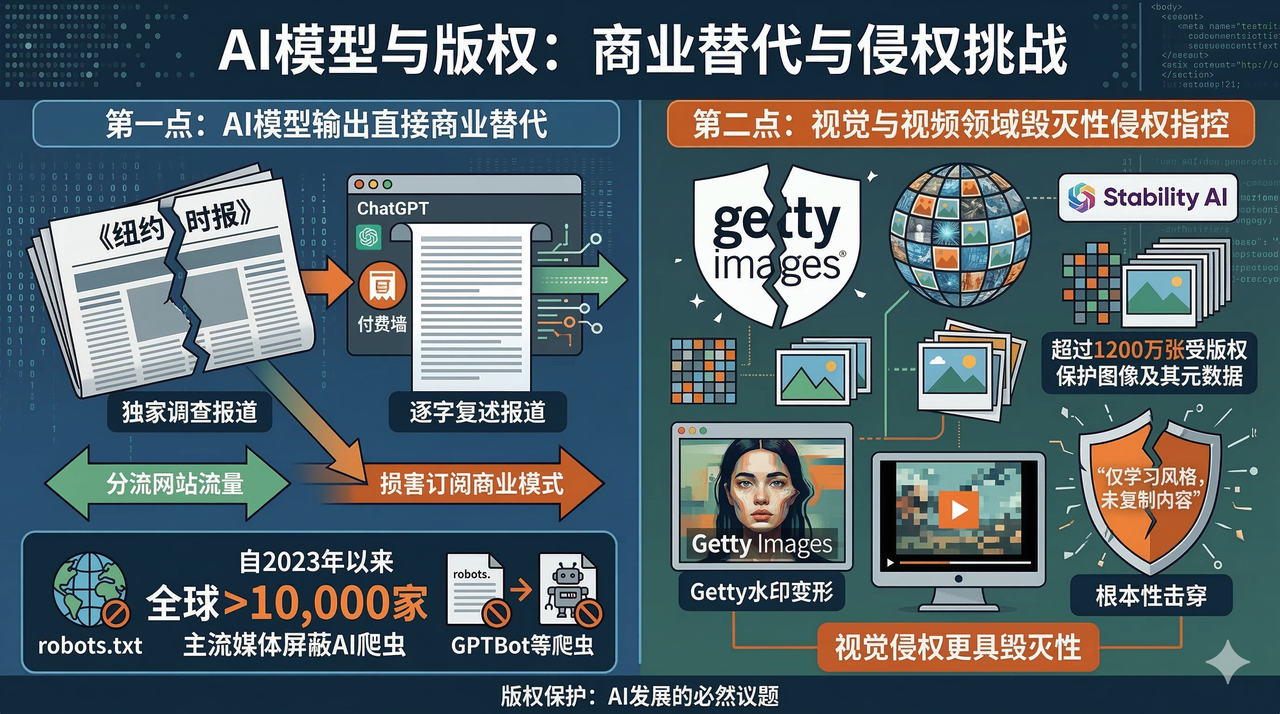
首先,AI模型的输出已经对原版权所有者构成了直接的商业替代。以《纽约时报》起诉OpenAI和微软为例,《纽约时报》在诉状中提供了明确的证据,证明ChatGPT能够逐字复述其付费墙后的独家调查报道。这种行为不仅分流了新闻网站的流量,更直接损害了其订阅商业模式。数据显示,自2023年以来,全球已有超过10,000家主流媒体和出版机构在网站的robots.txt文件中屏蔽了GPTBot等主流AI爬虫。
其次,视觉与视频领域的侵权指控更具毁灭性。Getty Images起诉Stability AI的案件中,Getty指控后者未经授权使用了超过1200万张受版权保护的图像及其元数据进行训练,部分AI生成的图片甚至直接带有了Getty的水印变形。这从根本上击穿了AI公司“仅学习风格,未复制内容”的辩护词。
对于字节跳动而言,Seedance 2.0的延期发布是一次昂贵但必要的“合规补课”。视频内容的版权链条远比文本复杂,涉及剧本、音乐、肖像、表演者权益等多个维度的交叉保护。如果在缺乏完善防护机制(Guardrails)的情况下强行推向市场,其面临的将不仅是天价的侵权赔偿,更可能被法院下达禁令,甚至被要求销毁由侵权数据训练出的底层模型(即算法回溯/Algorithm Disgorgement)。
三、 信任的瓦解:315曝光下的GEO灰产与“被操纵的赛博神明”
如果说版权问题是AI的“输入端危机”,那么315晚会曝光的GEO乱象,则是极其危险的“输出端毒瘤”。
传统搜索引擎时代,SEO(搜索引擎优化)是通过优化网页结构和关键词来提升排名,用户对搜索结果(尤其是带有“广告”标识的结果)具有天然的防御心理和辨识能力。但在生成式AI时代,大模型是以“对话式、拟人化、唯一正确答案”的形态与用户交互。当用户询问“市面上哪款婴儿奶粉最安全”时,AI给出的单一连贯回答,在用户心理上具有极强的“权威背书”效应。
核心观点:放任GEO黑产,等同于将AI的认知定义权拱手让给资本,这将彻底摧毁AI的商业基座
GEO服务商能够向客户承诺“榜上有名”,其本质上是利用了大模型训练和检索机制的漏洞。当前操纵大模型输出主要有三种技术路径:
- 语料库污染(Data Poisoning): 在AI模型定期抓取更新的数据源(如高权重的论坛、百科、问答社区、新闻源)中,大量铺设特定品牌的高频正面词汇和虚构测评。当大模型进行下一轮增量训练或微调时,这些被污染的数据就会改变模型内部的概率分布,使其在生成相关领域的回答时,不可避免地倾向于被注入的品牌。
- 检索增强生成(RAG)劫持: 许多现代大模型(如Bing Chat, 各种具备联网功能的AI)采用RAG技术,即在回答前先去互联网检索最新信息。GEO服务商通过海量生成的虚假软文霸占传统搜索引擎的首屏,迫使AI的联网检索插件抓取这些软文作为“参考资料”,最终导致AI生成包含特定广告的回复。
- 提示词注入(Prompt Injection)与隐性触发: 在某些开源生态或第三方应用中,恶意行为者可以通过植入特殊的对抗性文本,迫使模型在特定语境下无视客观事实,强制输出设定好的商业推介。
以下表格直观展示了传统SEO与AI-GEO在危害维度上的根本差异:
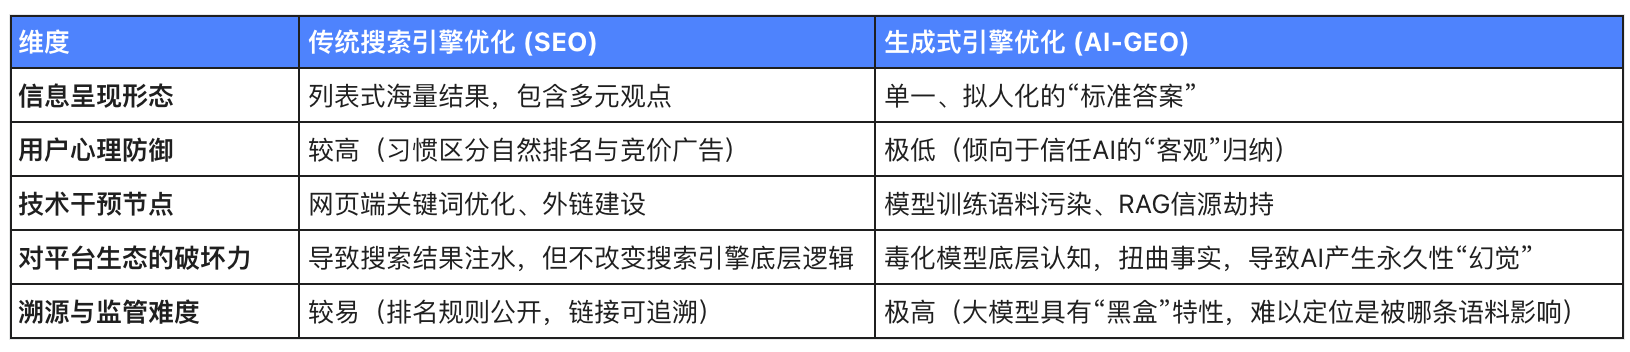
315晚会的曝光敲响了警钟。当AI的回答可以被明码标价购买时,AI就不再是辅助人类决策的智能工具,而沦为了披着科技外衣的隐蔽洗脑机器。这种信任的崩塌对于立志于打造AI操作系统的巨头来说,是致命的战略级威胁。
四、 寻找平衡:全球监管视角的演进与博弈
面对版权侵权与人为操纵的双重危机,全球主要经济体的立法机构与监管部门已经开始行动,试图在“鼓励AI技术创新”与“保护现有商业/社会秩序”之间寻找平衡点。
目前,全球针对AI领域的法律框架正在加速收紧,各大企业必须放弃“法外之地”的幻想,将合规要求前置到模型研发的第一天。
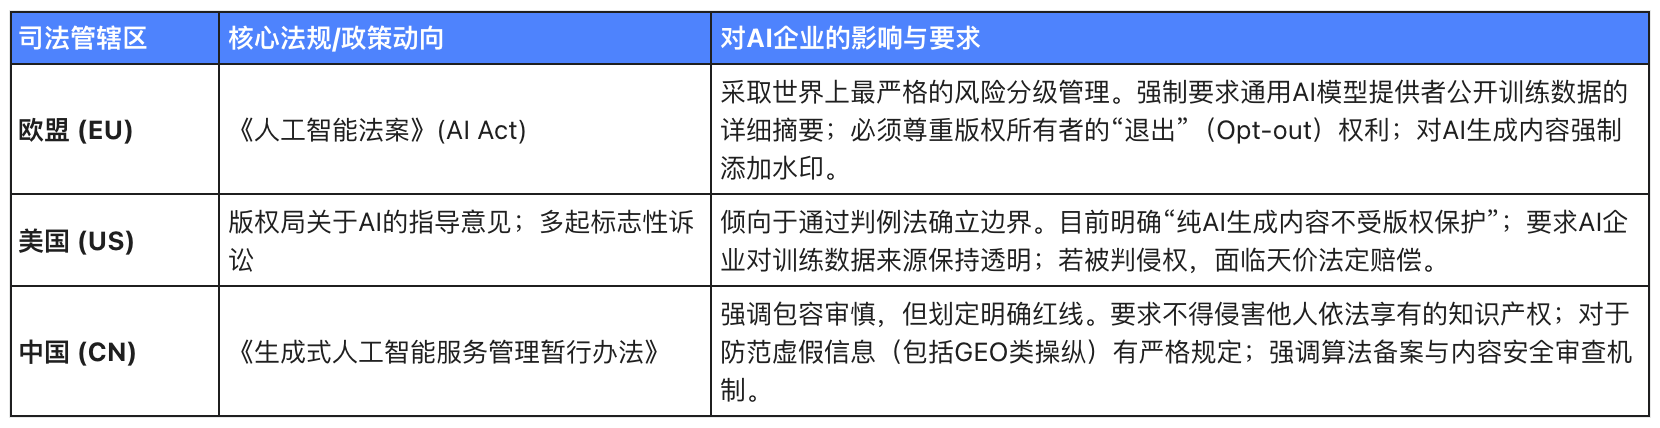
从上述监管趋势可以看出,“透明度(Transparency)”和“可追溯性(Traceability)”已成为全球治理的共识。无论是为了厘清版权归属,还是为了排查被GEO灰产污染的虚假信息,AI企业都必须打破以往的“黑盒”研发模式,建立具备强可解释性的数据飞轮。
五、重构数字时代AI合规与信任护城河的四大战略
在版权围剿与黑产侵蚀的夹击下,AI企业及应用开发者如何破局?ME News 智库认为,单纯的技术修补已无济于事,企业必须在战略层面完成从“效率优先”向“信任优先”的范式转移。决策层应重点部署以下四大战略:
1.建立“白盒化”的高质量数据集与付费授权机制
依赖爬虫的“数字圈地运动”已经结束。未来AI模型的竞争壁垒,不再是数据量的多寡,而是数据的“纯净度”与“合法性”。
- 推进语料付费墙合作: 类似OpenAI与美联社、Axel Springer等新闻机构达成数千万美元级别的授权协议,头部AI企业必须将“数据采购费”纳入核心研发成本。对于视频类大模型,与好莱坞或各大版权中介组织建立收益分成机制(Revenue Sharing)是唯一出路。
- 发展合成数据(Synthetic Data): 在版权敏感领域,利用已获授权的小规模高质量数据,通过大模型自身生成海量的虚拟训练数据。这既能解决数据饥渴,又能从物理上隔绝知识产权侵权风险。
2.引入C2PA协议与深度数字水印,建立内容防伪溯源体系
为了防范GEO黑产对语料库的污染,以及防止AI生成内容侵犯他人权益,技术层面的身份认证机制刻不容缓。
- 支持C2PA内容溯源: 行业应全面接入内容来源和真实性联盟(C2PA)标准。这意味着无论是文本、图像还是视频,从创建、编辑到发布的每一个环节都有密码学签名。当AI模型在抓取或联网检索时,可以直接过滤掉没有真实来源签名的“GEO批量生成垃圾”,确保吸收的信息具备人类真实性背书。
- 强制不可逆水印技术: 类似Google的SynthID技术,在AI生成内容的像素或音频波形底层嵌入人眼不可见、且能抵抗压缩和裁剪的水印。这不仅是向监管交出的答卷,也是保护AI模型自身不被其他劣质AI内容二次反噬的防护罩。
3.构建“对抗性审计”与反GEO护栏系统
针对315曝光的操控答案问题,平台方必须将其视为等同于黑客攻击的网络安全事件,升级风控体系。
- 部署红蓝对抗机制(Red Teaming): 在模型发布前,建立专业的内部黑客团队,专门模拟GEO服务商的手段,对模型进行提示词注入和数据投毒攻击,以此寻找并修复模型的逻辑漏洞。
- RAG信源白名单与权重稀释: 对于联网检索生成的答案,AI必须降低对单一信息源或低权重域名的依赖。当算法检测到某一品牌或观点在短时间内出现异常的密集曝光时,应自动触发“信息茧房隔离”机制,并在最终回答中向用户强提示:“该品牌近期存在高频网络推广,请谨慎参考”。
4.推动“AI输出可解释性”的技术研发
AI给出的“标准答案”不应是盲盒。新一代的模型架构应当在生成结论的同时,以脚注的形式清晰、准确地列出推理依据和参考链接。这既能赋予原版权创作者应有的流量回馈,也能让用户有能力对被GEO操纵的虚假信息进行交叉验证。只有让AI的逻辑链条暴露在阳光下,才能真正消解大众对算法黑箱的恐惧。
六、 结语
技术从来都不是在真空环境中演进的。字节跳动Seedance 2.0的全球延期与315晚会对GEO灰产的曝光,像两记沉重的警钟,宣告了生成式AI告别“野蛮生长”时代的到来。ME News 智库认为,未来的AI霸主,绝不会是那些仅仅拥有最大算力或最激进爬虫技术的公司,而是那些能够最快构建起坚实“版权合规护城河”与“反操纵信任体系”的长期主义者。
面对这股不可逆转的历史浪潮,决策者们需要明白:在AI的下半场,守住底线,往往比追求极致的上线,更具有决定生死的战略价值。
参考来源:
- 欧盟委员会. (2024). Artificial Intelligence Act. European Parliament.
- 纽约时报公司诉微软及OpenAI侵权案诉状. (2023). The New York Times Company v. Microsoft Corporation, OpenAI, Inc., et al. United States District Court for the Southern District of New York.
- Getty Images诉Stability AI侵权案诉状. (2023). Getty Images (US), Inc. v. Stability AI, Inc. United States District Court for the District of Delaware.
- The Information. (2026). ByteDance Pauses Global Launch of New Video AI Model Amid Hollywood Copyright Disputes. The Information Technology News.
- 中央广播电视总台. (2026). 3·15晚会:揭秘AI大模型背后的“答案操纵”黑产. CCTV.
- C2PA (Coalition for Content Provenance and Authenticity). (2024). C2PA Technical Specification Version 1.3. C2PA.org.