生图逻辑从"即时响应"升级为"先想后画"
文章作者、来源:0x9999in1,ME News
TL;DR
- ChatGPT Images 2.0(底层模型gpt-image-2)在Arena文生图榜单以创纪录分数登顶,领先第二名谷歌Nano Banana 2/Pro达242分,且包揽全部7个细分赛道第一
- 首次引入"Thinking模式"(思考能力),支持联网推理后再生图,将生图逻辑从"即时响应"升级为"先想后画"
- 实现像素级细节控制:直播中演示在单颗米粒上刻写"GPT image 2"字样,突破物理极限般的精细度
- 中文/日文等非英文文本渲染精准度大幅提升,终结了AI生图"洋文漂亮、中文乱码"的历史尴尬
- 最高支持2K分辨率输出,覆盖UI设计、游戏开发、影视分镜、营销素材等专业场景
- Figma、Canva、Adobe Firefly、fal等平台同日宣布接入,生态壁垒一日之内筑起
- 免费开放给所有ChatGPT与Codex用户,但"思考模式"仅限Plus/Pro/Business用户,API已同步开放
一、242分。这不是领先,这是碾压
竞技场(Arena)的榜单从来不讲情面。它把模型扔进匿名对决,让用户盲投,谁的图更顺眼、更听话、更像人画的,谁就能往上爬。没有公关稿,没有发布会光环,只有赤裸裸的审美投票。
4月22日,OpenAI把ChatGPT Images 2.0(底层代号gpt-image-2)丢进了这个角斗场。结果?屠榜。不是赢了一两个类别,是全部七个文生图赛道——写实、动漫、设计、概念艺术、像素风、摄影、插画——全部第一。总分甩开第二名谷歌Nano Banana 2/Pro整整242分。
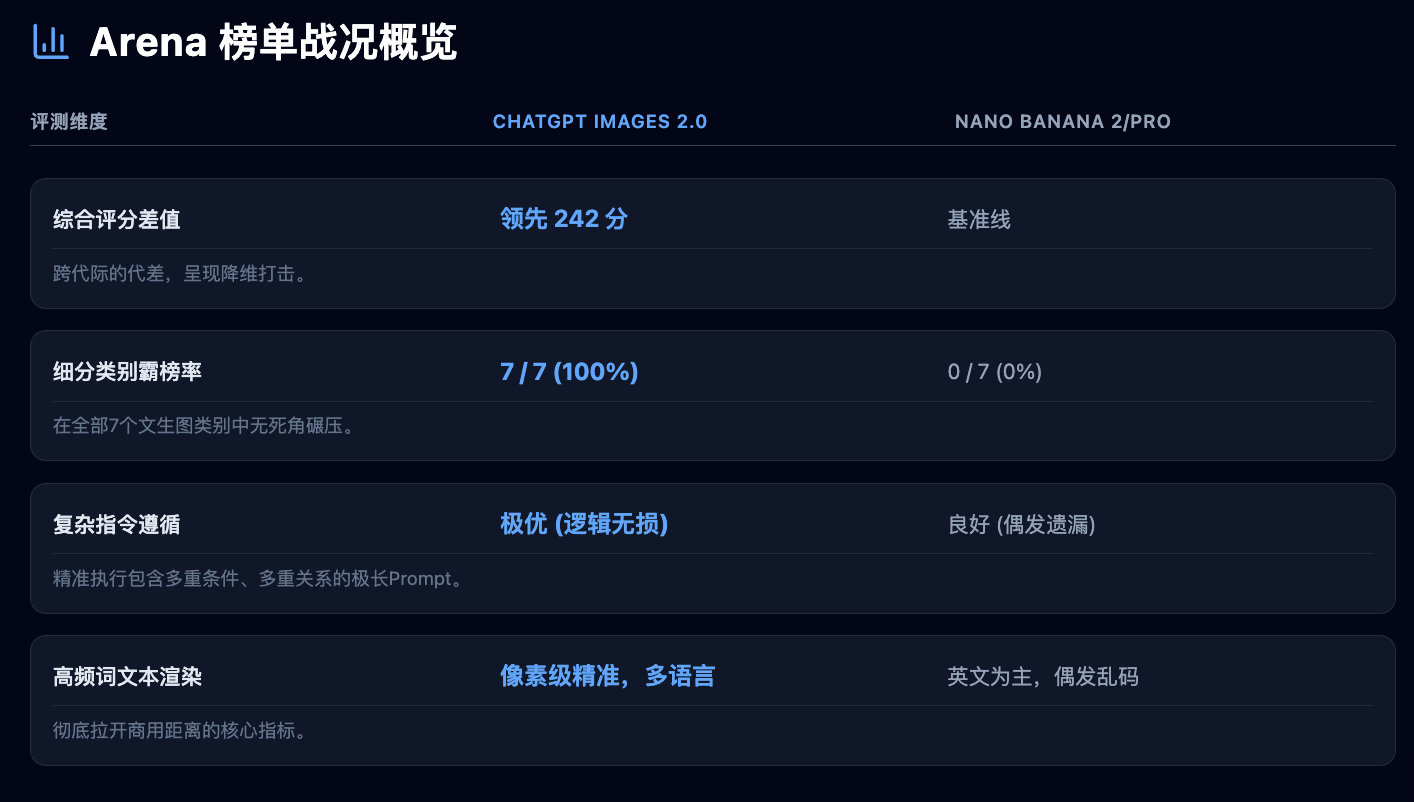
242分是什么概念?在Arena的评分体系里,这相当于泰森一拳把对手打进了观众席。要知道,此前的生图赛道长期处于"群雄割据"状态:Midjourney靠美学品味圈地自萌,Stable Diffusion靠开源生态野蛮生长,谷歌的Imagen系列靠背靠搜索巨头稳扎稳打。大家互有胜负,分差往往在个位数到两位数之间徘徊。OpenAI这一脚,直接把棋盘踹翻了。
为什么能赢这么多?因为Images 2.0解决了一个行业顽疾:它真的在听你说话。
过去的文生图模型,本质上是个"关键词翻译器"。你把"一只穿西装的猫坐在咖啡馆里看报纸"丢给它,它大概能给你一只猫、一套西装、一张报纸,但猫的眼睛可能盯着天花板,报纸上的文字是外星文,咖啡杯悬浮在半空。模型理解了"有什么",但不懂"在哪里"、"什么关系"、"为什么要这样"。
Images 2.0的升级,核心就砸在这个痛点上。对象摆放与关系表达——这个词听起来很学术,翻译成大白话就是:它知道猫该坐在椅子上,而不是椅子上;知道报纸该被爪子捏着,而不是贴在脸上;知道背景的光源从左侧来,所以猫的右脸该有阴影。这种对空间逻辑和物理关系的把握,让生成的图像从"元素堆砌"变成了"场景叙事"。
更狠的是高密度文本渲染。以前让AI在图里写几个字,出来多半是鬼画符。英文尚且勉强能看,中文直接灾难现场。Images 2.0这次把多语言文本生成做成了基本功——中文、日文、韩文,甚至小语种,都能准确落位。这不是简单的字体叠加,而是让文字成为图像语义的一部分:招牌上的店名、书本上的标题、屏幕上的代码,字与景交融,而不是贴上去的膏药。
Arena的榜单证明了这一点:当一张图里的中文招牌不再像随机抓阄出来的字符,当UI设计稿里的按钮文字清晰可读,当漫画对话框里的台词精准传达情绪——这242分的差距,其实是"能用"和"好用"之间的鸿沟。
二、米粒上刻字:像素级控制意味着什么
OpenAI的发布会直播里,有一个画面让全场安静了一秒。一张米山图——字面意义上的,一座由大米粒堆成的山——其中一颗米粒上,刻着"GPT image 2"的字样。字体清晰,笔画完整,没有模糊,没有扭曲,没有AI常见的"文字溶解"现象。
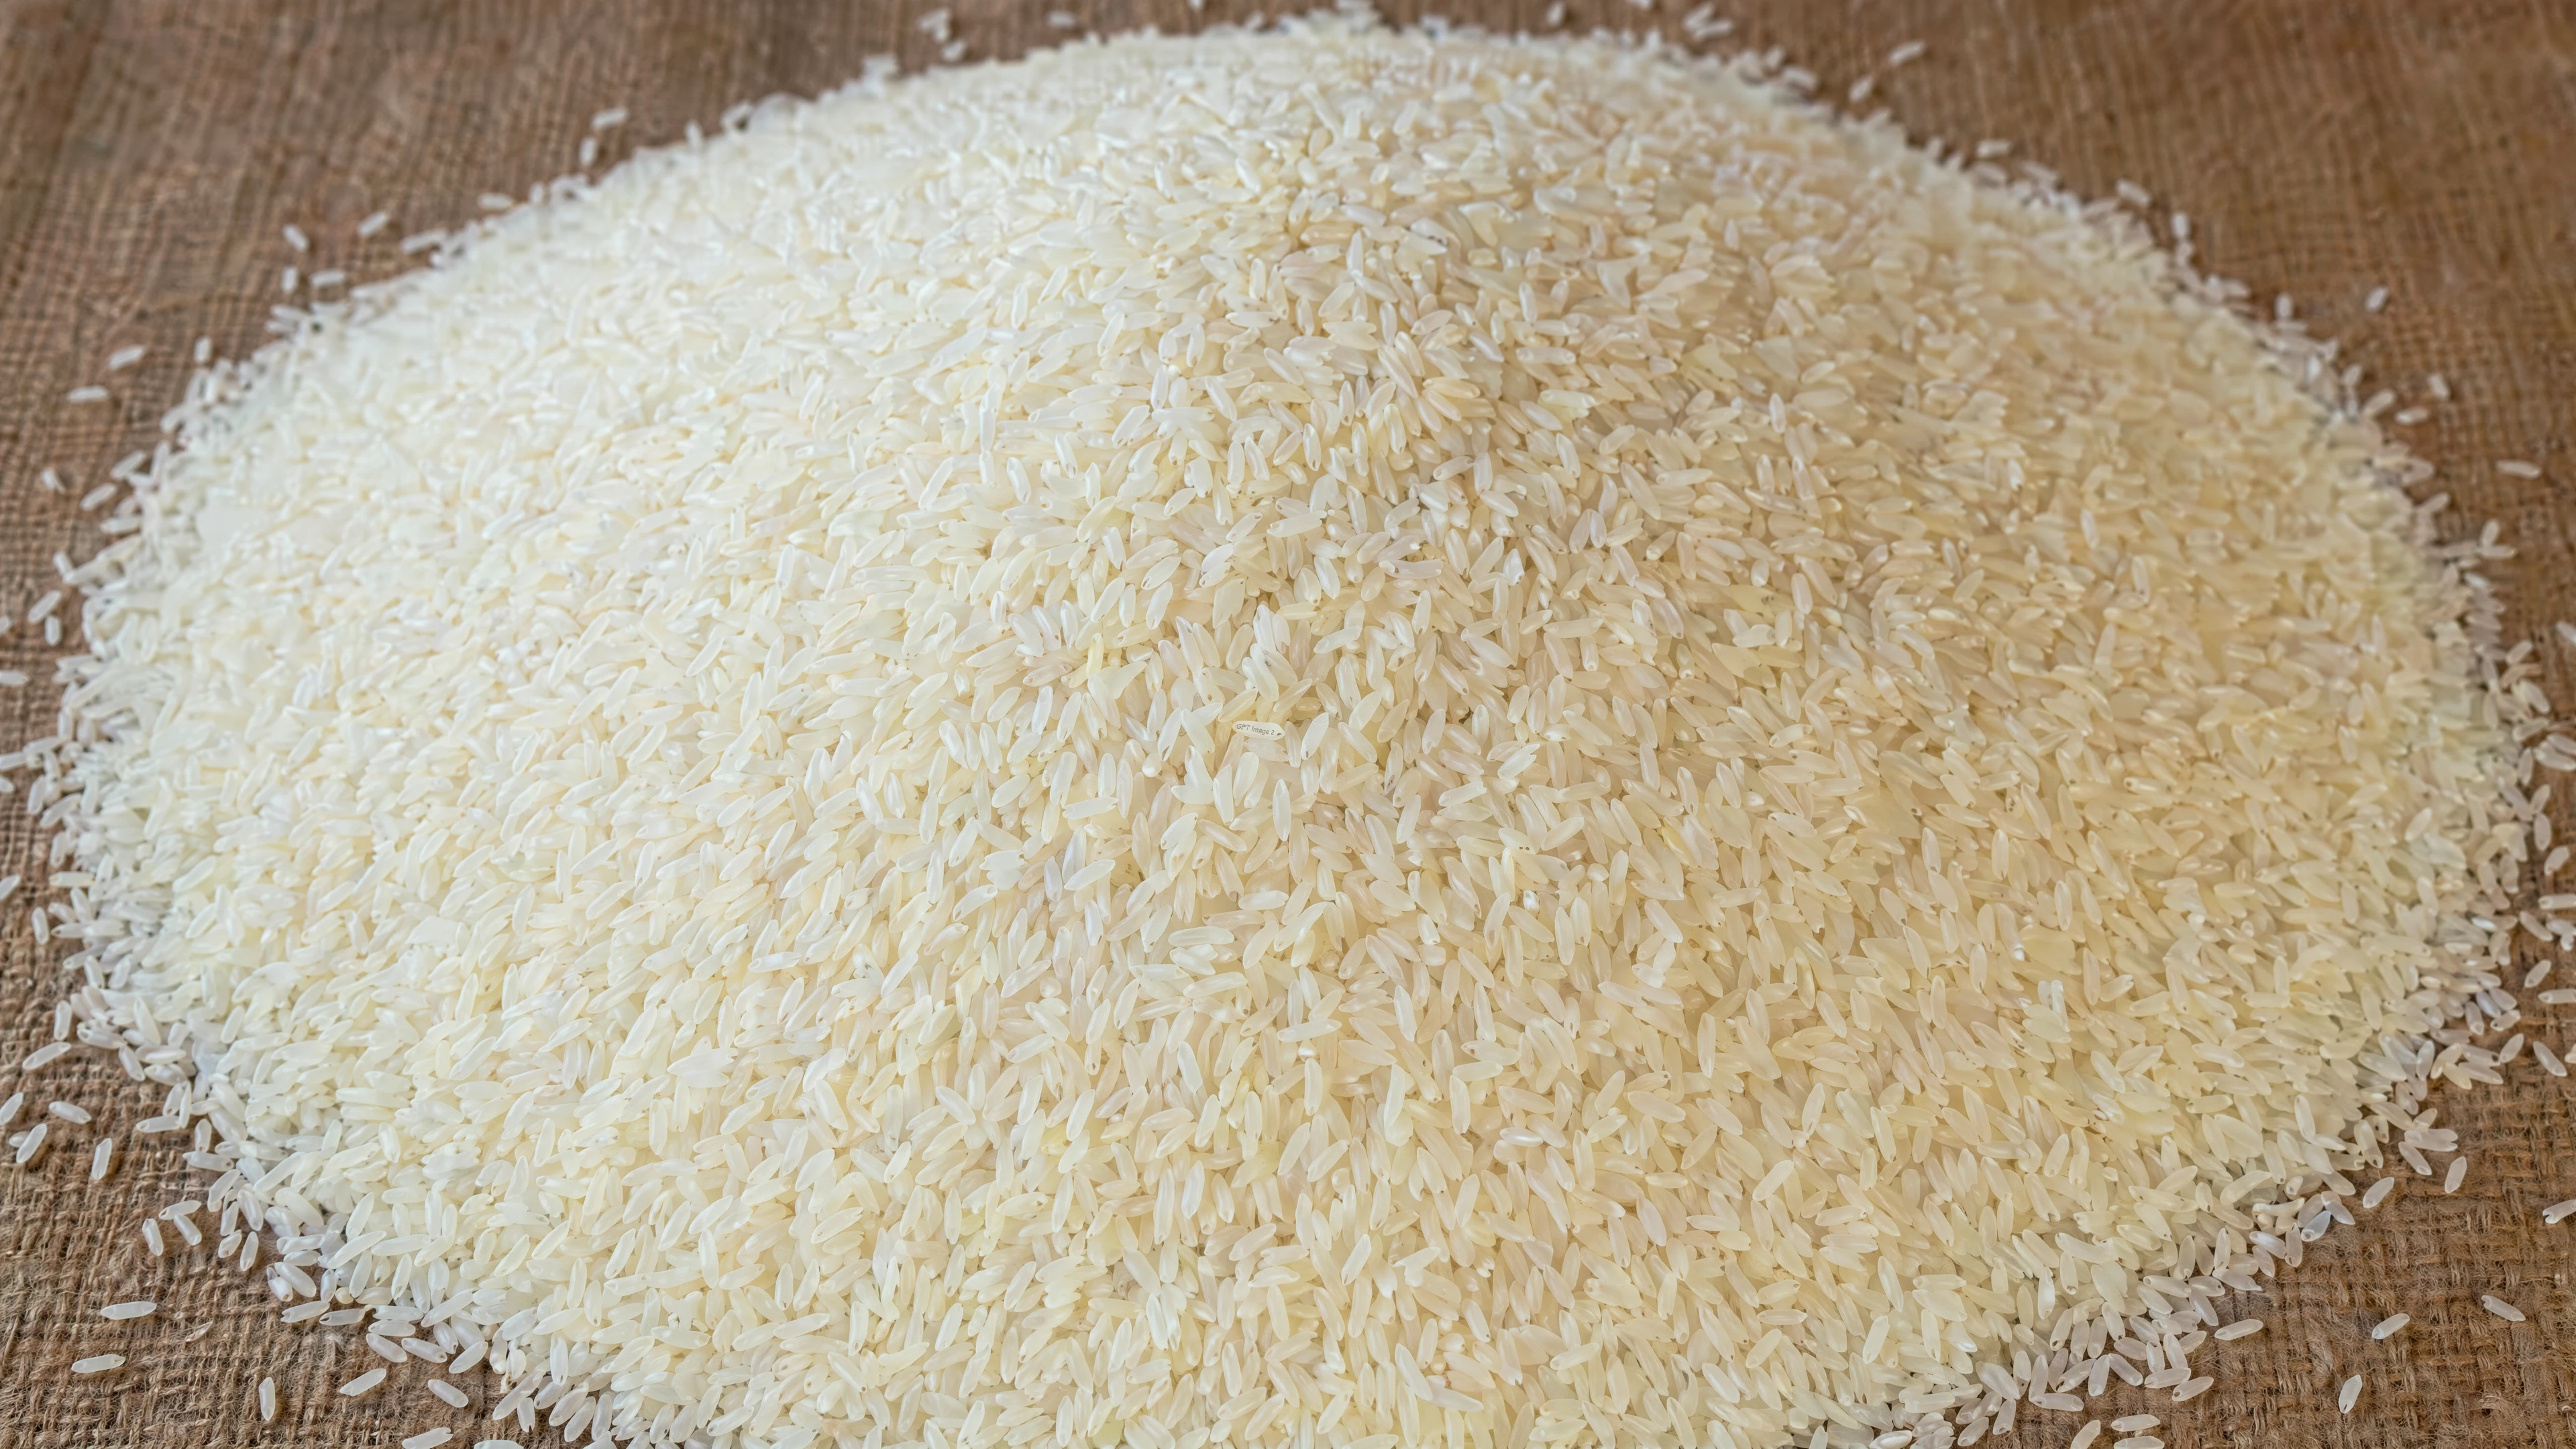
一颗米粒。在2K分辨率的画布上,它可能只占据几十个像素。但Images 2.0硬是在这几十个像素里,完成了可辨识的文本渲染。
这已经不是"精细"能形容的了。这是像素级控制。
过去的生图模型,本质上是在概率的海洋里捞针。它们通过学习海量图像的统计规律,猜测"这里应该有个什么颜色的像素"。所以当画面细节密度超过一定阈值——比如小字体、复杂图标、密集UI元素——模型就开始"糊弄"。因为它没有真正的"视觉焦点"概念,只有"大概长这样"的模糊记忆。
Images 2.0的突破在于,它似乎掌握了一种分层注意力机制。它能像人眼一样,先扫视全局构图,再聚焦局部细节,并且在缩小到像素级别时,依然保持对语义的理解。米粒上的字不是随机生成的纹理,是被精确放置在特定空间坐标上的、具有明确语义的内容。
这种能力对专业创作者意味着什么?游戏开发者可以生成带有清晰道具图标和UI界面的概念图,不用再后期PS替换文字;电商设计师可以让AI直接产出带价格标签和促销文案的商品海报,不用再手动排版;漫画作者可以让对话框里的台词和拟声词精准对应画面情绪,不用再一张张修字。
更重要的是,2K分辨率的输出能力,让这些细节不再只是"放大后勉强能看",而是真正达到了商用标准。以前AI生图的最大尴尬就是:缩略图惊艳,放大后露馅。Images 2.0把"放大"这个动作,从"找茬游戏"变成了"欣赏细节"。
三、"思考模式":生图从反射弧进化到大脑皮层如果说像素级控制是Images 2.0的"手",那Thinking模式就是它的"脑"。
这是OpenAI在生图领域投下的一枚认知炸弹。过去的文生图,是刺激-反应模式:输入提示词,模型立即吐图。快则三秒,慢则十秒,但本质上是"不过脑子"的条件反射。你给它"赛博朋克风格的中国古城",它就从训练数据里调取"赛博朋克"和"中国古城"的统计特征,搅拌一下端上来。
Images 2.0的Thinking模式,把这个流程彻底重构。它会在收到指令后,先进入一段联网推理过程:拆解你的需求,分析场景逻辑,规划构图层次,甚至检索相关视觉参考,然后再动笔。这不是简单的"多想了会儿",而是把生图从"直觉绘画"升级为"命题作文"。
举个例子。你让AI"设计一个面向Z世代的环保咖啡品牌海报,要体现可持续理念,但不能说教,要有幽默感,配色要符合2026年春夏流行趋势"。旧模型可能给你一张绿色的咖啡杯图,上面飘几片叶子,完事。Images 2.0的Thinking模式会怎么做?它可能会先推理"Z世代反感说教式环保,偏好自嘲和梗文化",然后联想到"用咖啡渣种植物的反差萌",再检索当下流行的"多巴胺配色"或"复古未来主义"趋势,最后生成一张"咖啡杯里长出小森林,杯身印着'这杯在拯救地球,下一杯看你了'的俏皮文案"的海报。
这种端到端任务处理能力,让Images 2.0不再只是一个"画图工具",而是一个"视觉策略师"。它能完成从文案生成到设计构图的完整流程,把创意工作流压缩到一个对话框里。
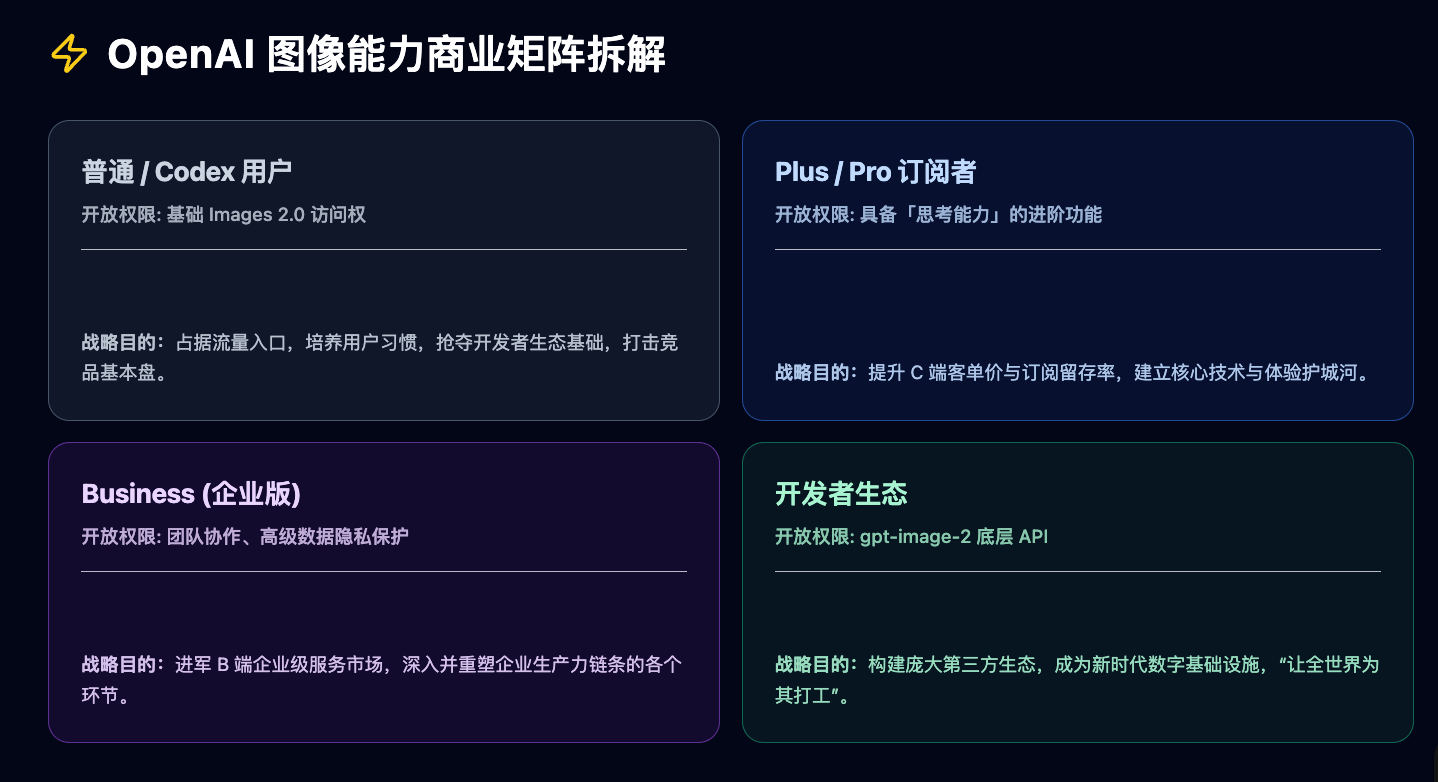
但OpenAI在这里埋了一个精妙的商业钩子:Thinking模式不向所有人开放。免费用户能用基础生图功能,但"带脑子的版本"仅限Plus、Pro和Business用户(Enterprise即将支持)。这相当于在生图赛道复制了ChatGPT本身的付费分层策略——基础功能免费拉新,认知升级收费变现。当用户尝过"会思考"的甜头,再回去用"不过脑子"的即时生图,就像从智能手机退回到功能机,落差感会自己把钱包掏出来。
四、中文不再乱码:一场迟到的语言平权
AI生图领域有一个公开的秘密:英语是母语,其他语言是方言。
这不是歧视,是训练数据的结构性偏见。互联网上高质量的图文对数据,英文占绝对主导。模型学"text rendering"时,本质上是在学英语字母的笔画规律。所以当你让AI在图里写"Happy Birthday",出来像模像样;写"生日快乐",出来可能是"生曰忄央乐"——偏旁部首随机重组,像汉字但又不是汉字。
Images 2.0把这块短板补上了,而且补得很彻底。中文、日文、韩文,甚至阿拉伯文、泰文,都能精准渲染。这不是简单的"支持更多字符集",而是模型真正理解了非拉丁文字的结构逻辑——汉字的间架结构、日文的假名搭配、韩文的音节组合,都被纳入了生成框架。
为什么这很重要?因为语言即权力。当AI生图工具只能稳定输出英文,它实际上是在强化一种文化霸权:全球创作者要么被迫用英语表达,要么接受"劣化版"的母语呈现。Images 2.0的多语言突破,是一次技术层面的语言平权。中国设计师可以用中文做海报,日本插画师可以让角色说出地道的台词,阿拉伯世界的营销团队可以生成符合本地阅读习惯的视觉素材。
从商业角度看,这也是OpenAI对亚洲市场的精准狙击。Midjourney和Stable Diffusion的中文支持始终半吊子,谷歌的Imagen虽然背靠多语言搜索数据,但在Arena的实测中,文本渲染精度依然不敌Images 2.0。OpenAI用"中文不乱码"这个看似微小的改进,撬动了一个数十亿用户的市场心智。
五、生态闪电战:一天之内,围墙筑成
好的产品发布,叫发布。好的产品加生态,叫闪电战。
4月22日当天,Figma、Canva、Adobe Firefly、fal——这些设计工具和AI平台——同步宣布接入Images 2.0。这不是巧合,是OpenAI蓄谋已久的生态合围。
想想看这意味着什么。设计师在Figma里做UI,可以直接调用Images 2.0生成带真实文案的 mockup;营销团队在Canva里做海报,可以让AI根据品牌调性一键出图;Adobe Firefly的用户,终于能用上"会思考"的生图引擎,而不是Adobe自研模型的"安全但平庸"输出;开发者通过fal的API,可以把Images 2.0塞进自己的应用里,按量付费。
这种平台级接入,在一天之内把Images 2.0从"ChatGPT的一个功能"变成了"行业基础设施"。更可怕的是,它制造了迁移成本:当设计师的工作流里嵌入了Images 2.0的API,当企业的营销素材库建立在它的输出标准上,切换成本就会指数级上升。OpenAI不是在卖模型,是在圈地。
对比竞争对手的处境,这种生态攻势更显凌厉。Midjourney是封闭花园,API姗姗来迟;Stable Diffusion是开源散沙,各改各版,没有统一入口;谷歌有技术但生态整合慢半拍,Imagen系列至今未形成设计工具矩阵。OpenAI用一天的发布会,完成了别人一年的生态谈判。
六、生图赛道的范式转移:从"画得像"到"想得对"
Images 2.0的出现,标志着AI生图竞争进入了一个新维度。
第一阶段的竞争,比的是像不像。谁能生成更逼真的照片、更精美的插画,谁就能吸引早期用户。Midjourney在这个阶段一骑绝尘,靠美学品味建立了品牌认知。
第二阶段的竞争,比的是快不快。推理速度、出图成本、API稳定性,成为B端客户的核心考量。Stable Diffusion靠开源和本地化部署,在这个赛道切走了企业市场。
Images 2.0开启的是第三阶段:对不对。不是"这张图好看吗",而是"这张图解决问题了吗"。UI设计稿里的按钮间距是否符合规范?海报上的文案是否传达了品牌调性?分镜图的构图是否匹配导演意图?当AI开始"思考"后再画图,它输出的不再是"视觉素材",而是"视觉解决方案"。
这种范式转移,会把生图赛道的护城河从"模型能力"扩展到工作流整合。未来的竞争,不再是单张图的PK,而是"从需求到交付"的全链路效率。Images 2.0的端到端能力——文案生成、设计构图、多语言适配、高分辨率输出——正是在这个维度上 preemptively strike(先发制人)
七、隐忧与锋芒:OpenAI的下一步棋
当然,Images 2.0并非没有软肋。
算力成本是悬在头顶的剑。Thinking模式的联网推理+2K分辨率生成,意味着单次调用的计算量远超传统生图模型。OpenAI能补贴多久?当用户量突破临界点,是否会像GPT-4一样频繁降价又限流?这是所有订阅者都在观望的问题。
版权雷区依然迷雾重重。Images 2.0的训练数据里有多少受版权保护的图像?生成的商业素材是否安全?OpenAI的"版权盾"政策能覆盖到什么程度?这些问题在Arena的分数里找不到答案,但在法庭上可以。
审美同质化的风险也在累积。当全球设计师都用同一个"思考大脑"出图,视觉风格是否会趋向统一?Midjourney的"塑料感美学"曾被诟病千篇一律,Images 2.0的"精准听话"是否会导致另一种单调——所有人都得到"正确但无聊"的图?
但这些质疑,挡不住Images 2.0的锋芒。因为它解决了一个最根本的问题:让AI从"玩具"变成"工具"。
当一粒米上可以刻字,当一张海报上的中文不再像乱码,当设计师说"要幽默不要说教"AI真的能听懂——这些不是参数的提升,是可用性的质变。Images 2.0没有发明新的图像生成技术,它把现有技术的工程精度和产品化程度,推到了竞争对手短期内难以企及的高度。
八、结语:像素级时代,没有中间地带OpenAI这次的操作,很像一个老练的拳手。它没有花哨的连招,只是每一拳都打在对手最疼的地方:你文本渲染不行?我做到米粒刻字。你不懂空间关系?我七个赛道屠榜。你没有生态?我一天之内让Figma、Canva、Adobe排队接入。你模型不会思考?我直接给生图装上大脑皮层。
生图赛道的竞争,从此没有中间地带。要么像Images 2.0一样,做到像素级的精准和认知级的理解;要么就沦为"差不多能用"的背景板。242分的差距,不是数字,是一道鸿沟——鸿沟这边是"AI辅助创作",鸿沟那边是"AI替代创作"。
而OpenAI的野心,显然不止于替代几张海报。当Images 2.0的API接入千万应用,当Thinking模式成为企业工作流的默认选项,当2K分辨率的输出铺满电商页面和游戏界面——它争夺的,是视觉内容的定义权。
米粒上的字,终究会写进更大的图景里。
参考资料
- OpenAI. (2025, April 22). *Introducing ChatGPT Images 2.0 and gpt-image-2*. OpenAI Blog. https://openai.com/blog/introducing-chatgpt-images-2
- LMSYS Org. (2025, April). *Image Arena Leaderboard*. Chatbot Arena. https://lmarena.ai/?leaderboard
- TechCrunch. (2025, April 22). *OpenAI's new image model crushes competition in benchmark tests, leads by 242 points*. TechCrunch. https://techcrunch.com/2025/04/22/openai-image-model-arena-leaderboard
- The Verge. (2025, April 22). *ChatGPT Images 2.0 brings 'thinking' to AI image generation with pixel-level text accuracy*. The Verge. https://www.theverge.com/2025/4/22/chatgpt-images-2-thinking-mode
- Figma, Canva, Adobe Firefly, fal. (2025, April 22). *Platform integration announcements for gpt-image-2*. [Multiple press releases via official channels]