文章主要介绍了不同AI大语言模型在处理中文及其他非英语语言时的“价格差异”或“成本歧视”问题,其核心在于模型“分词器”(Tokenizer)的设计。
文章作者、来源:AI吹哨兵
一个AI研究员做了一个测试
把一篇文章翻译成9种语言,喂进六家模型的分词器
以英文token数为基准,看各语言消耗多少
中文结果出来了,Claude是六家里最贵的:
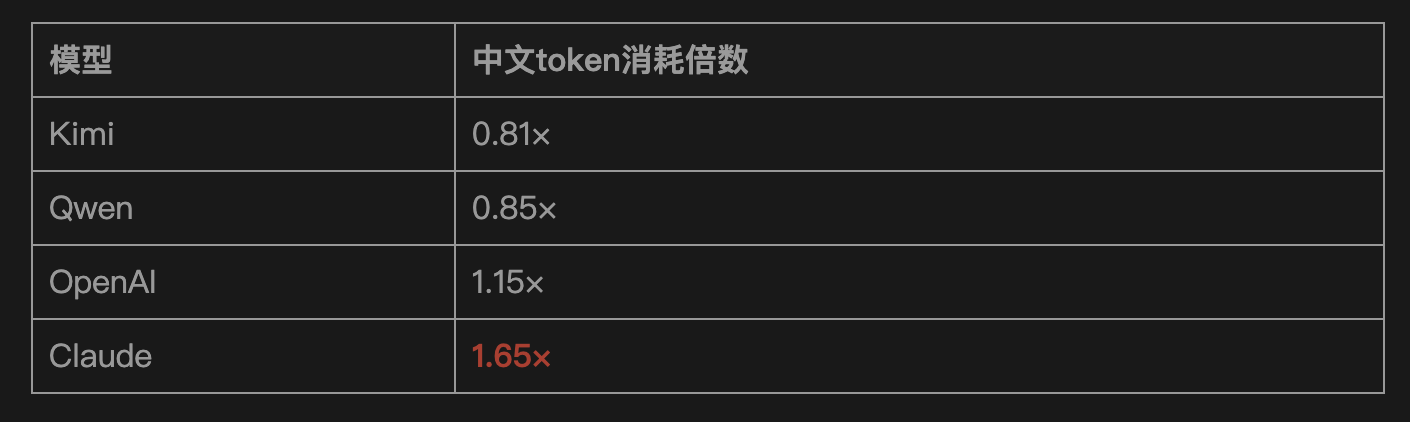
Kimi比英文还省,Claude却多花65%成本
同一段中文,Kimi只用0.81倍token,Claude要用1.65倍
差距不是来自模型能力,是来自AI设计的分词器
Kimi和Qwen的分词器针对中文做过优化,一个汉字对应更少的token
Claude的分词器以英文为核心设计,中文字符被切得更碎,更加消耗token
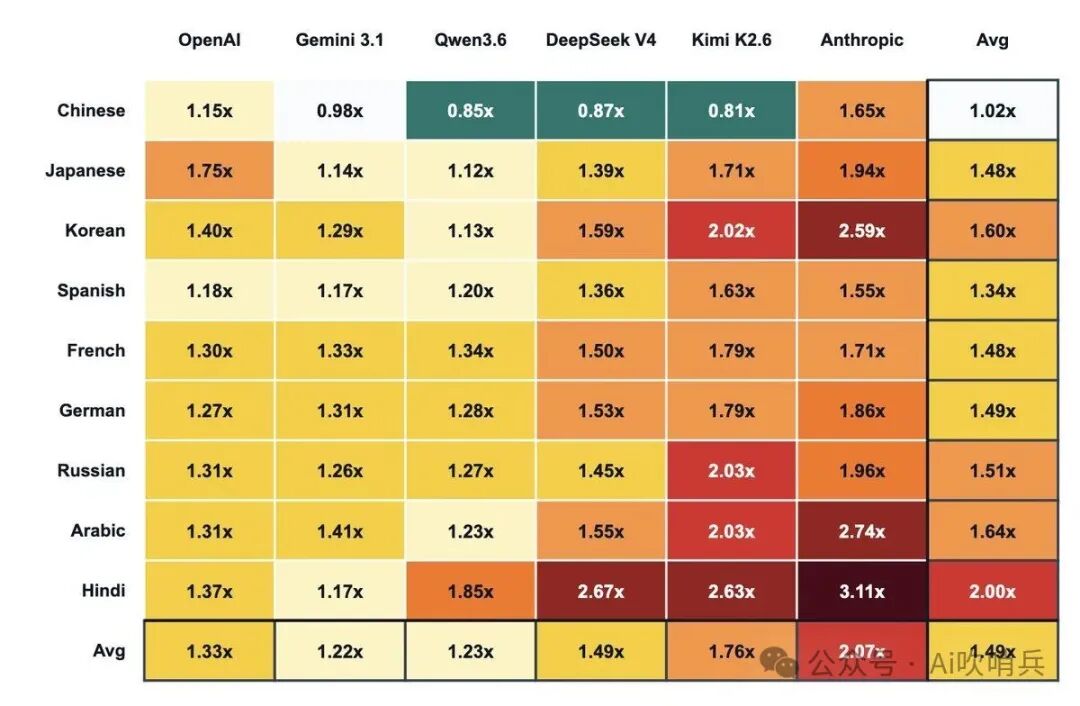
中文还不是最惨的
同一批测试,印地语和阿拉伯语的数据:
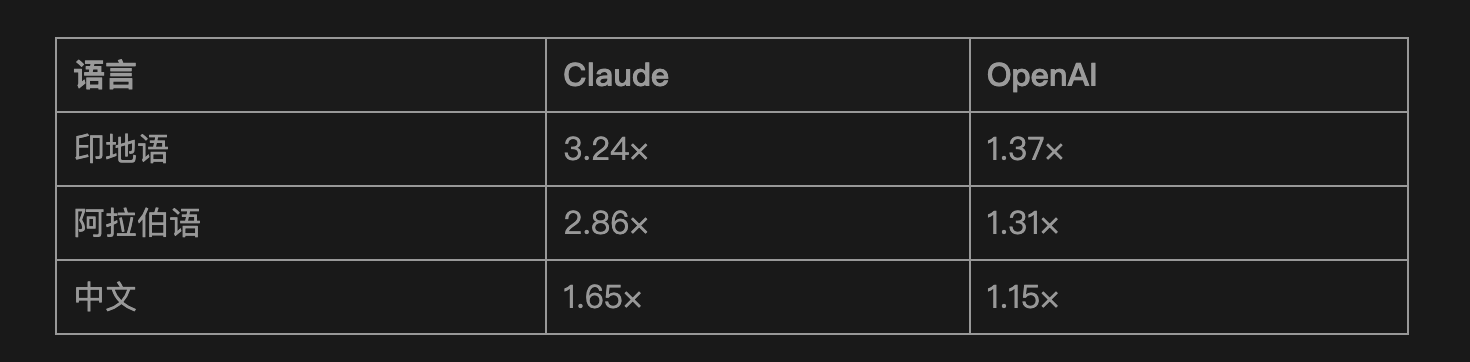 印地语有超过6亿母语使用者,每次调用Claude都在多付3倍以上的钱
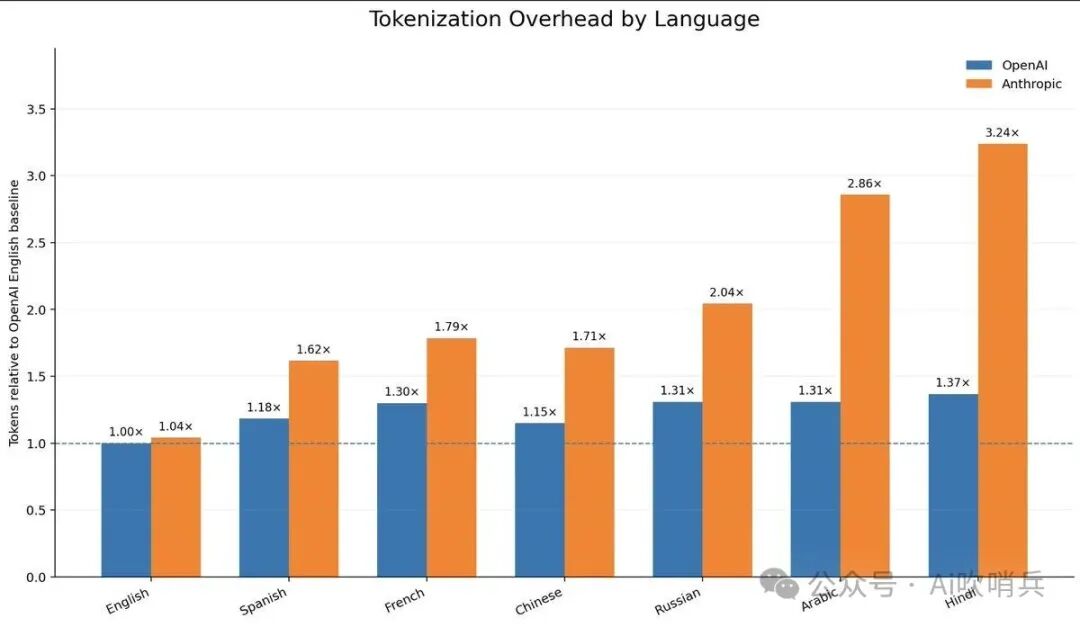
用Claude做中文产品,成本直接受影响
以一个每天处理10万字中文内容的应用为例:
• 用OpenAI:按1.15倍计费
• 用Claude:按1.65倍计费
• 差距:同等预算下,Claude能处理的内容量少30%
长文档分析、批量翻译、中文客服系统
凡是中文调用量大的场景,这个差距都会被放大
不过Anthropic目前没有公开回应这个问题