随着开源生态成熟,DeepSeek正在演变为AI基础设施,而Kimi则在尝试建立基于长文本的闭环生态。
文章作者、来源:0x9999in1,ME News
TL;DR
- 融资重构: DeepSeek(深度求索)传出的3500亿人民币估值及其背后的“阿里+腾讯+国家队”组合,标志着中国AI竞争进入“重资产、高溢价、强背书”的新阶段。
- 估值分野: DeepSeek以“硬核工程效率”和“推理能力”锚定估值,月之暗面(Kimi)则以“长文本能力”和“C端国民级产品”建立护城河。
- 技术范式: DeepSeek代表了从底层优化到架构创新的“极致效率”流派,而Kimi代表了以用户体验驱动技术迭代的“产品定义”流派。
- 商业分化: 随着开源生态成熟,DeepSeek正在演变为AI基础设施,而Kimi则在尝试建立基于长文本的闭环生态。
- 核心研判: 未来24个月,中国AI竞争的焦点将从“参数规模”转向“推理性价比”与“原生Agent落地能力”。
融资神话:DeepSeek与月之暗面的估值天平
2026年,中国大模型领域的融资竞赛已进入到令人窒息的深水区。近日传出的DeepSeek(深度求索)首轮500亿人民币融资方案,不仅是金额上的震撼,更在于其出资结构的战略意义。
DeepSeek:国家队与科技巨头的“最大公约数”
根据市场披露,DeepSeek本轮由阿里巴巴、腾讯和国家集成电路产业投资基金(大基金)各注资100亿,加之创始人梁文锋个人出资200亿,将公司估值推高至3500亿人民币(约合480亿美元)。这一数字已使其超越了OpenAI在2024年初的部分估值点位,成为全球范围内最具价值的AI独角兽之一。
这种出资结构透视出三大信号:首先,阿里与腾讯在底层算力设施上的“战投共识”,意味着巨头不再仅限于自研,而是通过扶持最强第三方来对冲不确定性;其次,大基金的入场标志着DeepSeek已被视为“算力与算法融合”的国家级战略资产;最后,创始人200亿的巨额跟投,在创投史上极为罕见,展现了极致的技术自信与财务自由后的理想主义。
月之暗面(Kimi):红杉与阿里的“长期押注”
相比之下,月之暗面(Moonshot AI)的融资节奏呈现出“多轮高频”的特征。在2024-2025年间,Kimi通过数轮累计超过20亿美元的融资,将估值推向300亿美金区间。其背后的核心支持者包括红杉中国、美团、阿里及美团,反映了资本市场对其“产品力”和“C端爆发力”的高度认可。
下表详细对比了两家公司的融资与估值基准:
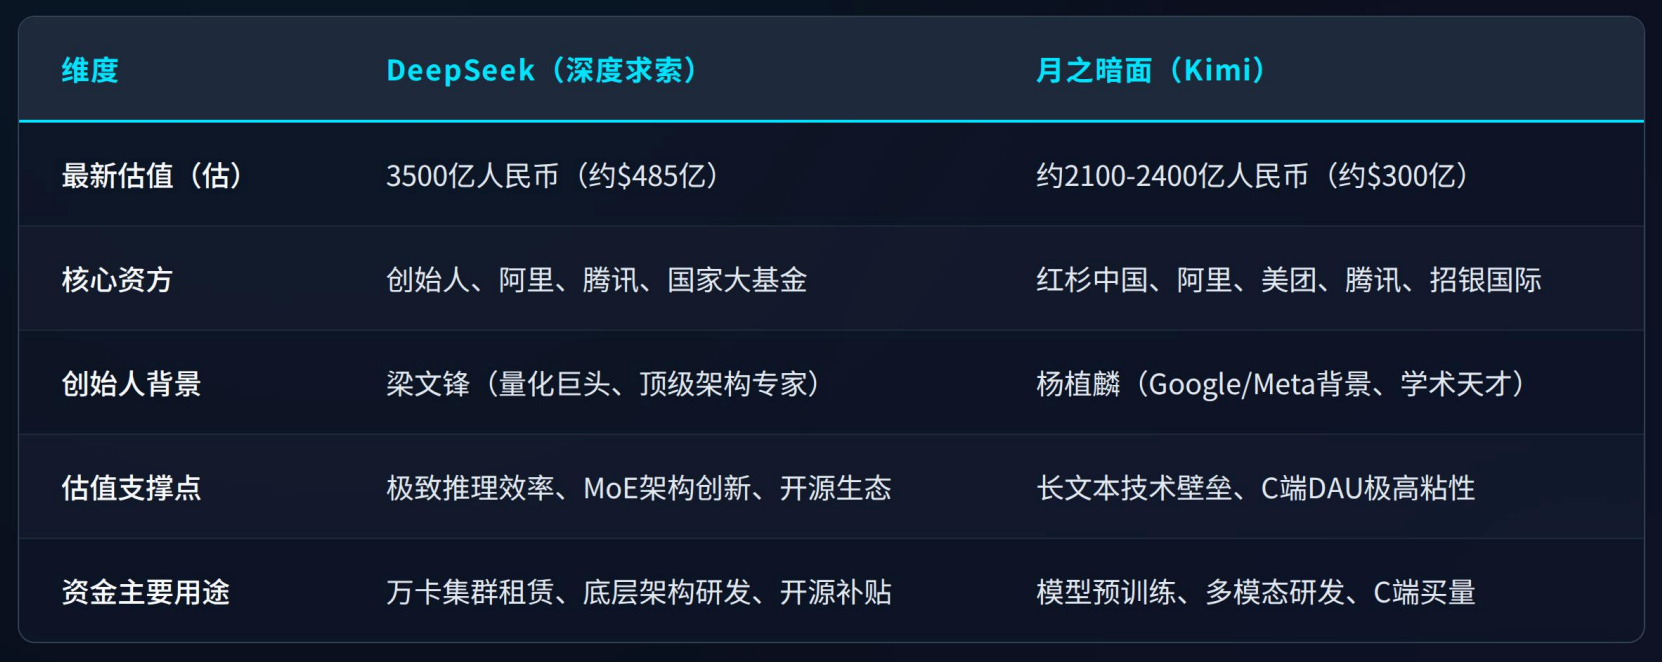
表1:DeepSeek 与 月之暗面(Kimi)融资估值对比表
深度求索:以极致效率重塑“中国版OpenAI”
DeepSeek之所以能在2026年获得如此夸张的估值,本质在于其打破了“暴力美学”的Scaling Law束缚,走出了一条“工程效率”的独特路径。
技术信仰:从MoE架构到推理能力的跨越
DeepSeek V3及其后续版本的发布,标志着中国在MoE(混合专家模型)领域达到了世界领先水平。其通过Multi-head Latent Attention (MLA) 和 DeepSeekMoE 架构,将推理成本降低到了同类模型的十分之一。更重要的是,DeepSeek R1系列在强化学习(RL)上的突破,证明了中国团队在没有万亿参数规模的情况下,依然能通过算法优化实现媲美OpenAI o1的逻辑推理水平。
“幻方基因”:算力红利与工程能力的融合
作为幻方量化孵化的产物,DeepSeek天然带有“精算”基因。在其他大模型厂商还在纠结如何采购H100时,DeepSeek已经完成了对国产芯片与算力集群的深度优化。这种对底层指令集的掌控力,使其在面对外部禁运和算力紧缺时,表现出了极强的韧性。
研判:开源是DeepSeek的进攻,而非防守
DeepSeek坚持的高性能模型开源策略,正在迅速瓦解传统闭环模型的商业溢价。通过开源,它不仅获得了全球开发者的生态支持,更成为了许多企业构建私有化AI应用的唯一首选。这种“基础设施化”的地位,正是3500亿估值的底层逻辑所在。
月之暗面:长文本与产品主义的“单点突破”
如果说DeepSeek是AI界的“Intel”,那么月之暗面(Kimi)则更像是AI界的“Apple”。杨植麟团队从一开始就坚定地选择了“长文本”作为其核心技术锚点,并以此构建了极高的用户粘性。
长文本的技术溢价与场景价值
Kimi将无损上下文长度从20万字推向200万字甚至更高,其核心价值在于解决了大模型的“短期记忆”问题。在处理研报分析、长篇法律合同、甚至全代码仓库理解时,Kimi展现出的稳定性和准确性,使其在办公和科研场景中拥有极高的DAU(日活跃用户)。
C端市场的“心智占领”
Kimi是目前国内大模型中,极少数能够实现“自发传播”的产品。通过简洁的Web端和App设计,它成功地在2025年实现了一次大规模的破圈,用户不再讨论其参数,而是讨论“用Kimi总结财报”。这种品牌资产(Brand Equity)在估值模型中占据了巨大的权重。
下表对比了两家公司的技术核心指标及市场表现:
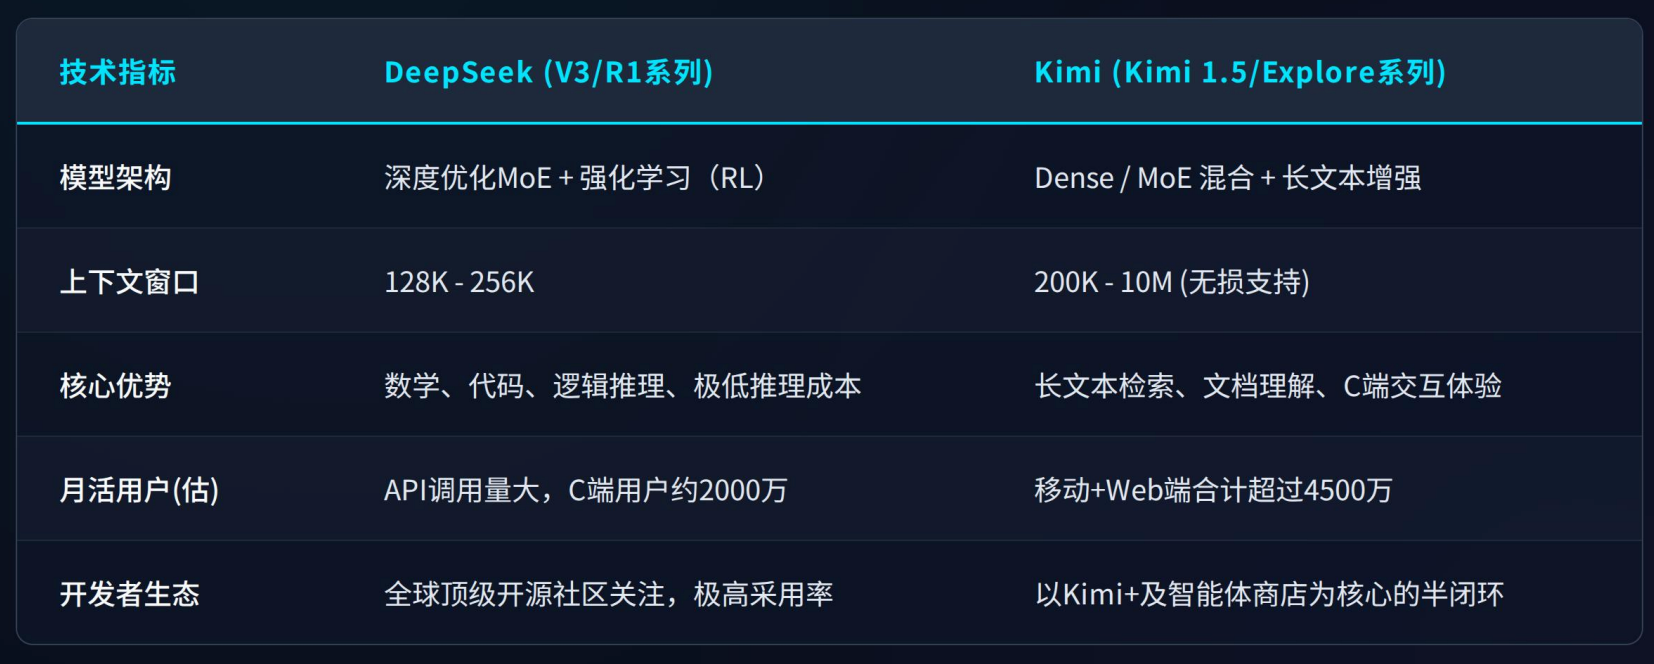
表2:DeepSeek 与 Kimi 核心技术及市场数据对比
范式之战:两种未来路径的深度博弈
从深度研视角来看,DeepSeek与Kimi代表了中国AI发展的两种主流意识形态。
路径一:全能基座与开源基础设施
DeepSeek的逻辑是“大而强、强而简”。它试图通过极致的效率降低全社会的AI接入成本。当DeepSeek R1的推理成本足够低时,它就会像电力一样,渗透进每一个工厂、每一行代码。这种路径的风险在于:过于依赖开源可能导致商业化收敛缓慢,必须依靠巨大的算力资产和国资背书来维持规模效应。
路径二:场景驱动与Agent生态系统
Kimi的逻辑是“深而美、美而准”。杨植麟曾多次强调,模型的能力最终要体现在产品上。Kimi正在从一个对话框演变为一个能够自主处理复杂任务的Agent。长文本只是手段,最终目标是实现对复杂人类意图的精准捕捉和执行。这种路径的挑战在于:基座能力的追赶压力巨大,必须在OpenAI等国际巨头的快速迭代中保持“特色功能”的领先。
商业化迷局:3500亿估值能否落地?
在高额估值的背后,是市场对商业化变现的急迫渴望。
算力套利 vs API服务
DeepSeek的商业模式正在向“算力+模型”双驱动转型。凭借与大基金及算力中心的绑定,它不仅售卖API,更可能为大型国企和科研机构提供定制化的私有集群方案。3500亿的估值中,有一部分实际上是对其“算力主权”的溢价。
订阅制与智能体佣金
Kimi则更偏向硅谷式的商业模型。其Kimi+(智能体商店)已经初具规模。未来,Kimi可能通过B端订阅、高级功能付费以及智能体交易的分成,构建起一个类似于App Store的生态闭环。
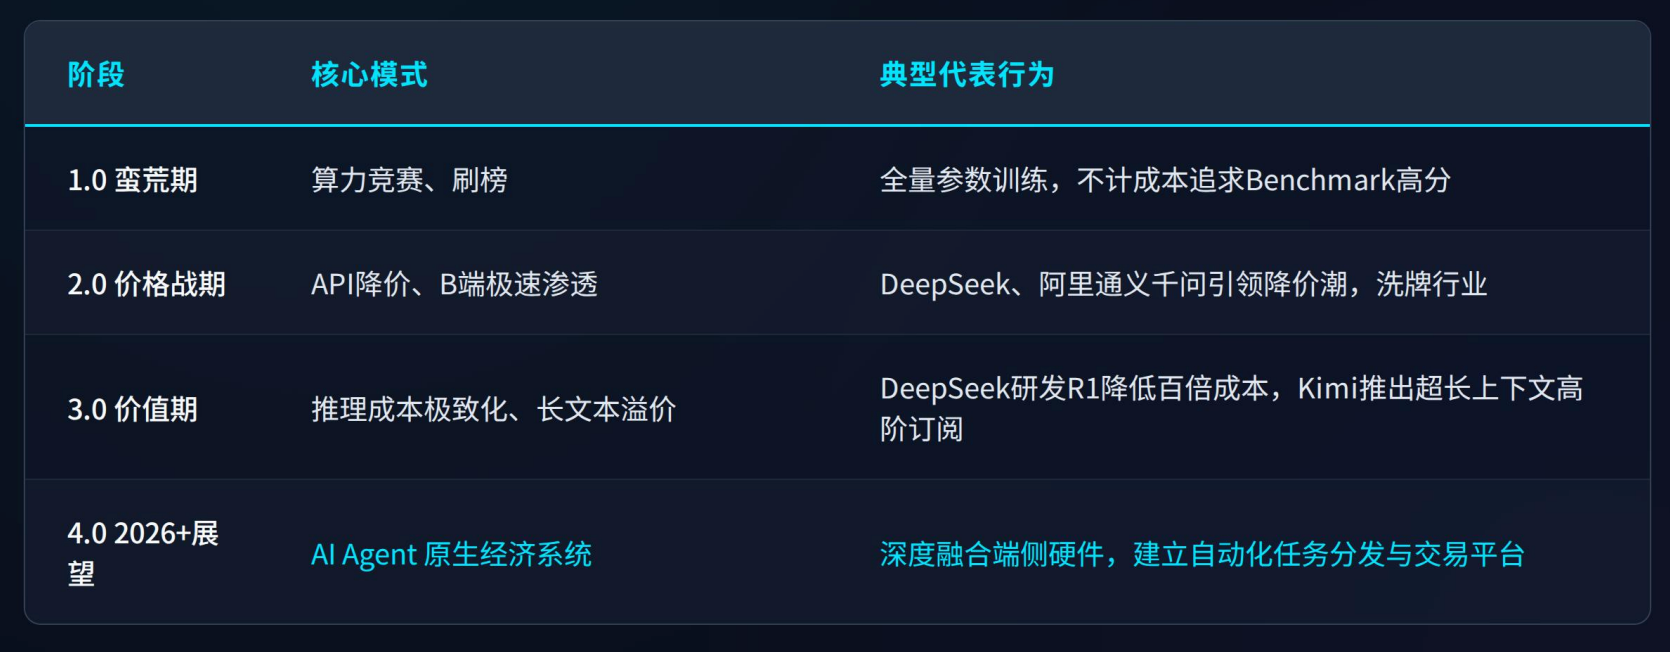
表3:中国大模型厂商商业化路径演进图
结论与研判:双子星的终局展望
DeepSeek与Kimi并非简单的竞争对手,而是共同构成了中国AI生态的“双保险”。
独立观点一:估值正从“预期”转向“效率”
过去,大模型估值看的是创始人背景和融资额;现在,DeepSeek的案例证明,市场更看重“每一美金投入能产生多少Token”。DeepSeek的极致工程化能力,让中国大模型在算力受限的情况下依然保持了全球竞争力,这才是大基金入局的核心考量。
独立观点二:长文本是手段,逻辑推理才是硬通货
Kimi虽然以长文本成名,但其下半场的关键在于能否补齐类似DeepSeek R1那样的逻辑推理短板。长文本若无强逻辑支撑,只是“巨大的存储器”;只有具备强推理能力,长文本才能转化成“庞大的智库”。
独立观点三:警惕“融资泡沫”下的算力闲置
3500亿人民币的估值需要极其庞大的营收和利润来支撑。在2026年的环境下,如果DeepSeek和Kimi不能在Agent落地或工业级应用上取得突破,仅仅靠API租赁,很难支撑起如此高的资本回报要求。
核心总结: DeepSeek代表了中国AI的“底座深度”,Kimi代表了中国AI的“场景广度”。DeepSeek首轮500亿融资的落定,意味着这场关于算力、算法与野心的游戏,已经进入了最后的庄家博弈阶段。对于行业而言,我们正见证着一个从“追赶”到“并跑”,甚至局部“领跑”的奇迹时刻。
引用来源
- 《关于深度求索(DeepSeek)首轮融资及战略投资细节的内部调研报告》,Tech Insights China, 2026-05.
- 《2025-2026年度中国大模型用户使用习惯与DAU统计分析》,QuestMobile / ME Data Center, 2026-04.
- DeepSeek V3 & R1 Technical Report, DeepSeek (DeepSeek-AI), 2025/2026.
- 《长文本模型的商业化困境与机遇:月之暗面深度案例研究》,Harvard Business Review (Chinese Edition), 2025-11.
- 《国家大基金三期投资方向与半导体、AI产业链协同效应分析》,华尔街见闻 / 智通财经, 2026-02.