AI把"交出数据"这个动作,从一个被动的、被盗取的、令人厌恶的过程,变成了一个主动的、有即时回报的、社交化的日常行为。
文章作者、来源:0x9999in1,ME News
TL;DR
- 五年前人们因APP窃取通讯录、泄露手机号而愤怒;现在却主动把身份证、简历、医疗记录喂给AI,情绪平静得可怕。
- 隐私宽容度确实在提高,但本质不是"不在乎了",而是一场成本收益计算——AI给的即时回报太大,大到用户愿意假装看不见风险。
- 推动这一转变的核心力量有三个:交互形态变了(对话式信任)、反馈速度变了(秒级满足)、替代方案消失了(不用就出局)。
- 监管并未跟上这种集体心理转向。中国《生成式人工智能服务管理暂行办法》、欧盟AI Act落地后,执法粒度仍然粗糙。
- 真正危险的不是"我知道我在交出隐私",而是"我根本不知道我交出了什么"——多模态AI时代,数据采集的颗粒度已经远超用户认知。
- 隐私宽容度的提升是一个渐进的、有条件的、可逆的过程,不是单向滑坡。
五年前:愤怒是标配
2019到2021年那段时间,隐私新闻是这样的——
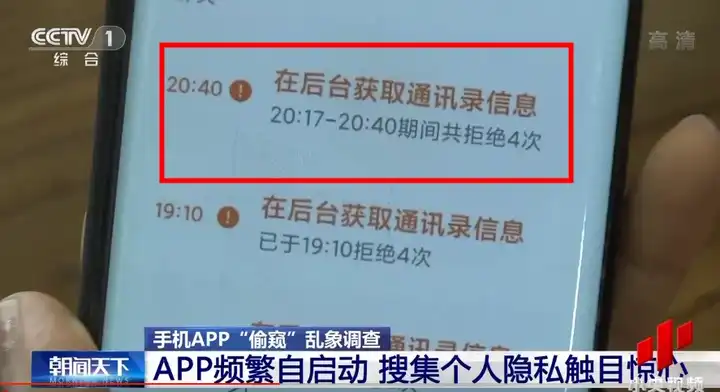
某头部社交APP被工信部通报,因为后台频繁读取用户相册。某外卖平台被曝根据手机型号搞大数据杀熟,iPhone用户看到的配送费比安卓贵2块。某房产信息平台把注册手机号批量倒卖给中介,用户刚填完一个楼盘咨询表,三分钟内接到五个不同区域的销售电话。
那时候的舆论反应?炸裂。微博热搜动辄上亿阅读。央视315点名。工信部一轮又一轮地下架整改通报。人们在评论区骂得很具体:"凭什么读我剪贴板?""我就下了个天气APP,你要我通讯录权限干什么?"
愤怒是真实的。不信任也是真实的。
2021年《个人信息保护法》正式实施,算是那个时代集体情绪的制度性结果。
回头看,那是一个人们对隐私有"朴素领地意识"的年代——我的手机号是我的,我的住址是我的,我的消费记录是我的。你偷,我就骂。逻辑简单,态度清晰。
现在:投喂是日常
快进到2025、2026年。
打开豆包,把一份带有真实姓名、教育经历、工作履历的简历粘贴进去:"帮我润色一下,投外企用。"
打开ChatGPT,上传一张身份证照片:"帮我把这个变成高清扫描件,正反面分开。"
打开Kimi,丢进一份体检报告:"帮我解读一下,哪些指标有问题?"
打开Grok,贴一段和前任的聊天记录:"帮我分析一下他是什么意思。"
停一下。想想这些动作。
五年前,一个APP偷偷读你通讯录,你想举报它。现在,你主动把身份证、简历、病历、情感隐私、甚至财务数据喂给一个你根本不了解其后端架构的AI模型。
而且你做这些事的时候,情绪是什么?
不是紧张。不是犹豫。是期待。是"快点给我结果"。
这就是变化。巨大的、结构性的变化。
为什么会这样?不是人变傻了
先排除一个懒解释:人变麻木了。
不对。2024年底Clearview AI在欧洲被重罚,相关新闻下的评论依然是愤怒的。2025年初某国产大模型被曝将用户对话数据用于训练且未明确告知,社交媒体反弹很快,该公司两天内发了致歉声明。
人们并没有对隐私完全钝感。他们只是在一种新的框架里重新计算了。
第一推力:对话式交互制造了虚假亲密
过去的数据采集是"背着你干的"。APP在后台偷偷上传通讯录,这个动作你看不见、不知情、没参与。被发现之后,自然觉得被侵犯。
但AI不一样。你跟它说话。它回应你。它叫你"亲"或者礼貌地说"好的,我来帮你处理"。这是一个对话。对话天然构建信任。
心理学里有个概念叫"自我披露的互惠性"——当你感到对方在回应你,你就倾向于透露更多。AI完美模拟了这个机制,虽然"回应"的那一方根本不是人。
你以为你在和一个助手合作。实际上你在对一个数据库敞开自己。但因为体验像"聊天",警觉就松弛了。
第二推力:即时回报太强
以前隐私泄露的模式是这样的:你付出数据→中间有黑产倒卖→最终你接到骚扰电话。付出和惩罚之间有时间差,付出和回报之间几乎没有正向联系。所以本能反应是拒绝。
现在的模式反过来了:你付出数据→AI秒级返回一份漂亮的简历/一张修好的证件照/一个清晰的诊断解读。付出和回报之间几乎零延迟,而潜在风险则被推到了未来某个不确定的节点。
这是经典的"双曲贴现"——人类天然对眼前的确定收益赋予过高权重,对未来的不确定损失严重低估。AI把这个认知偏差利用到了极致。不是故意的,是结构性的。
第三推力:不用就出局
2026年的职场、学业、日常生活中,AI已经是基础设施。
你不用AI改简历,隔壁工位用了,他的简历比你精致三倍。你不用AI处理证件照,线下快照店也在用AI处理完再卖给你——你只是多花了30块钱让别人替你喂数据。你不用AI辅助写代码,项目进度就是比用的人慢。
当一个工具变成"不用就落后"的社会基础设施时,隐私选择就不再是纯个人偏好,而是一种带有社会压力的被迫行为。
你可以选择不用。但代价是可见的、即时的、不断累积的。
数据怎么说
Cisco在2024年底发布的《消费者隐私调查报告》显示:全球范围内,84%的受访者表示关心隐私,但只有46%的人表示会因为隐私顾虑而停止使用某项AI服务。也就是说,接近一半的人明确承认:"我在乎,但我不会因此放弃使用。"
国内的数据更有意思。中国信息通信研究院2025年3月发布的一项调研显示,在使用生成式AI的用户中,67%的人曾上传过含有个人敏感信息的内容(包括姓名、证件号、照片等),但其中仅有23%的人仔细阅读过该服务的隐私政策。
翻译一下:三分之二的人在裸奔,四分之三的裸奔者不知道自己裸到什么程度。
再看企业端。根据Salesforce 2025年发布的一项关于职场AI使用的调查,全球28%的受访职场人士承认曾将公司机密数据输入公共AI工具而未获得公司授权。三星早在2023年就发生过工程师将内部源代码粘贴进ChatGPT导致泄露的事件——这不是隐私宽容,这是隐私盲区。
案例:那些我们已经习以为常的事
案例一:AI证件照
2024至2025年,AI证件照应用在中国爆发式增长。妙鸭相机、海马体AI写真等产品用户量级达到千万。流程很简单:上传15-20张个人照片(含正脸、侧脸、不同角度),AI生成各类证件照和写真。
想想这意味着什么——你把自己的高清面部生物特征信息,以多角度、多光照条件的形式,交给了一个商业公司的服务器。这些数据是否被用于模型训练?保留多久?加密标准是什么?大多数用户从未问过。
这事放在2020年,舆论会爆。放在2025年,大家觉得这是"生活方式"。
案例二:AI简历与求职
2025至2026年,用大模型改简历已成为求职者标配行为。领英在2025年的一项调查中提到,其平台上超过半数的求职者使用过AI辅助生成或优化简历内容。智联招聘2025年报告也显示类似趋势。
这些简历包含什么?全名、联系方式、教育背景、工作单位、项目经历、甚至薪资期望。用户把完整职业画像一次性交给AI。这比任何招聘网站的结构化数据采集都要全面——因为简历是叙事性的,包含上下文,包含逻辑关系,包含个人意愿。
案例三:AI心理咨询与情感分析
2025年以来,各类AI情感陪伴产品激增。Character.ai的心理健康相关角色使用量巨大。国内的产品如"星野""筑梦岛"等也有大量用户倾诉心事。
用户在这些场景里透露的是什么?是情绪状态、是人际关系细节、是心理创伤、是对特定人的评价。这些信息的敏感度远超手机号和住址。
2024年底,Character.ai因一名美国青少年用户在与AI角色深度互动后自杀,遭到家属起诉。事件引发监管关注,但并没有导致此类产品用户量显著下降。
这说明什么?人们不是不知道风险。但情感需求太真实、太紧迫,而替代方案——真人心理咨询——太贵、太难预约、太多社会标签。
宽容度提高了,但有边界
说到这里,我的判断是:
是的,宽容度提高了。不是因为人们不在乎了,而是因为AI时代重新定义了"可接受的隐私交易"的门槛。
但这个宽容是有条件的。
条件一:用户需要感到"我是主动的"
人们能容忍主动交出去的数据,不能容忍被偷的数据。2025年某短视频平台被曝在用户不知情的情况下,利用麦克风权限采集环境音用于广告推荐。舆论反应?依然是愤怒的、剧烈的。
所以不是"隐私无所谓了"。是"我给的可以,你偷的不行"。主动权的感知是关键变量。
条件二:用户需要信任品牌
同样是上传身份证,交给微信、支付宝,和交给一个没听说过名字的小程序,用户的心理阈值完全不同。信任在这里是重要调节器。OpenAI、字节跳动、百度这些大品牌享受了"大到可以信任"的隐性背书——虽然"大"和"安全"之间并不存在因果关系。
条件三:数据类型有差异
用户对不同类型数据的敏感度排序依然存在。根据中国网络空间研究院2025年的调研数据,用户对以下数据的敏感度排序大致是:金融账户信息 > 身份证号 > 医疗记录 > 人脸数据 > 职业信息 > 兴趣偏好。
也就是说,人们愿意把简历给AI,但让AI绑定银行卡依然会犹豫很久。宽容度是分层的,不是一刀切的。
真正的风险:你不知道你交出了什么
我最担心的其实不是"用户主动给"的那部分。
最危险的是多模态AI时代,数据采集的维度远超用户认知。
你以为你只是上传了一段语音让AI转写。但语音里包含什么?语速、停顿模式、情绪波动、环境噪音、口音特征。这些都是数据。
你以为你只是拍了一张照片让AI修图。但照片EXIF信息里有GPS坐标、设备型号、拍摄时间。背景里有你家的门牌号、你车的车牌、你桌上的药瓶标签。
你以为你只是让AI分析了一份PDF文档。但文档的元数据里有作者姓名、编辑历史、公司域名。
用户"主动交出"的是表层信息,但AI系统实际获得的是深层画像。用户以为自己做了一次小额支付,实际上写了一张空白支票。
这个认知差距——用户以为自己交了多少 vs 实际交了多少——才是这个时代最大的隐私陷阱。
监管能跟上吗?
坦白讲,目前跟得磕磕绊绊。
中国这边,2023年8月生效的《生成式人工智能服务管理暂行办法》要求服务提供者不得非法留存能够识别用户身份的输入信息,不得将输入信息用于训练模型(除非取得用户同意)。方向对,但执行粒度粗。用户同意的方式是什么?一个弹窗、一个默认勾选的复选框?这跟十年前APP隐私协议的套路有什么本质区别?
欧盟那边,AI Act已于2025年开始分阶段实施,将高风险AI系统的数据治理纳入强监管,要求训练数据的可追溯性。方向也对,但面对OpenAI、Google这种全球化运营的公司,跨境执法成本极高。
美国?依然没有联邦层面的统一隐私法律。各州各搞各的。加州CCPA算领先,但对生成式AI的约束条款仍在补充中。
总结:监管在跑,但比技术落地慢至少两到三年。而用户行为变化比监管更快。这个三者之间的速度差,就是当前隐私风险的最大来源。
结语
人对隐私的宽容度变高了吗?
高了。但不是因为人变蠢了,也不是因为人不在乎了。
是因为AI把"交出数据"这个动作,从一个被动的、被盗取的、令人厌恶的过程,变成了一个主动的、有即时回报的、社交化的日常行为。
你没有丢掉隐私意识。你只是在一场你未必能看清全貌的交易里,接受了一个你觉得划算的价格。
至于这个价格将来会不会被证明太低?
这个问题的答案,可能要等到某一天,AI训练数据的真正去向被完整揭露的时候,才能知道。
到那时候,希望我们还有讨价还价的余地。
参考来源
- Cisco, 2024 Consumer Privacy Survey, December 2024.
- 中国信息通信研究院,《人工智能应用中的个人信息保护研究报告》,2025年3月。
- Salesforce, Trends in AI at Work Report, 2025.
- 国家互联网信息办公室,《生成式人工智能服务管理暂行办法》,2023年8月15日施行。
- European Parliament, Artificial Intelligence Act (EU AI Act), 正式通过于2024年,2025年起分阶段实施。
- Reuters, "Character.AI sued after teen's death linked to chatbot interactions," October 2024.
- Samsung, internal memo on restricting ChatGPT use after source code leak, reported by Bloomberg, May 2023.
- 中国网络空间研究院,《中国互联网用户数据安全感知调查》,2025年。