真正的分水岭不是"中国vs美国",而是"开放科学vs封闭科学"。
文章作者、来源:0x9999in1,ME News
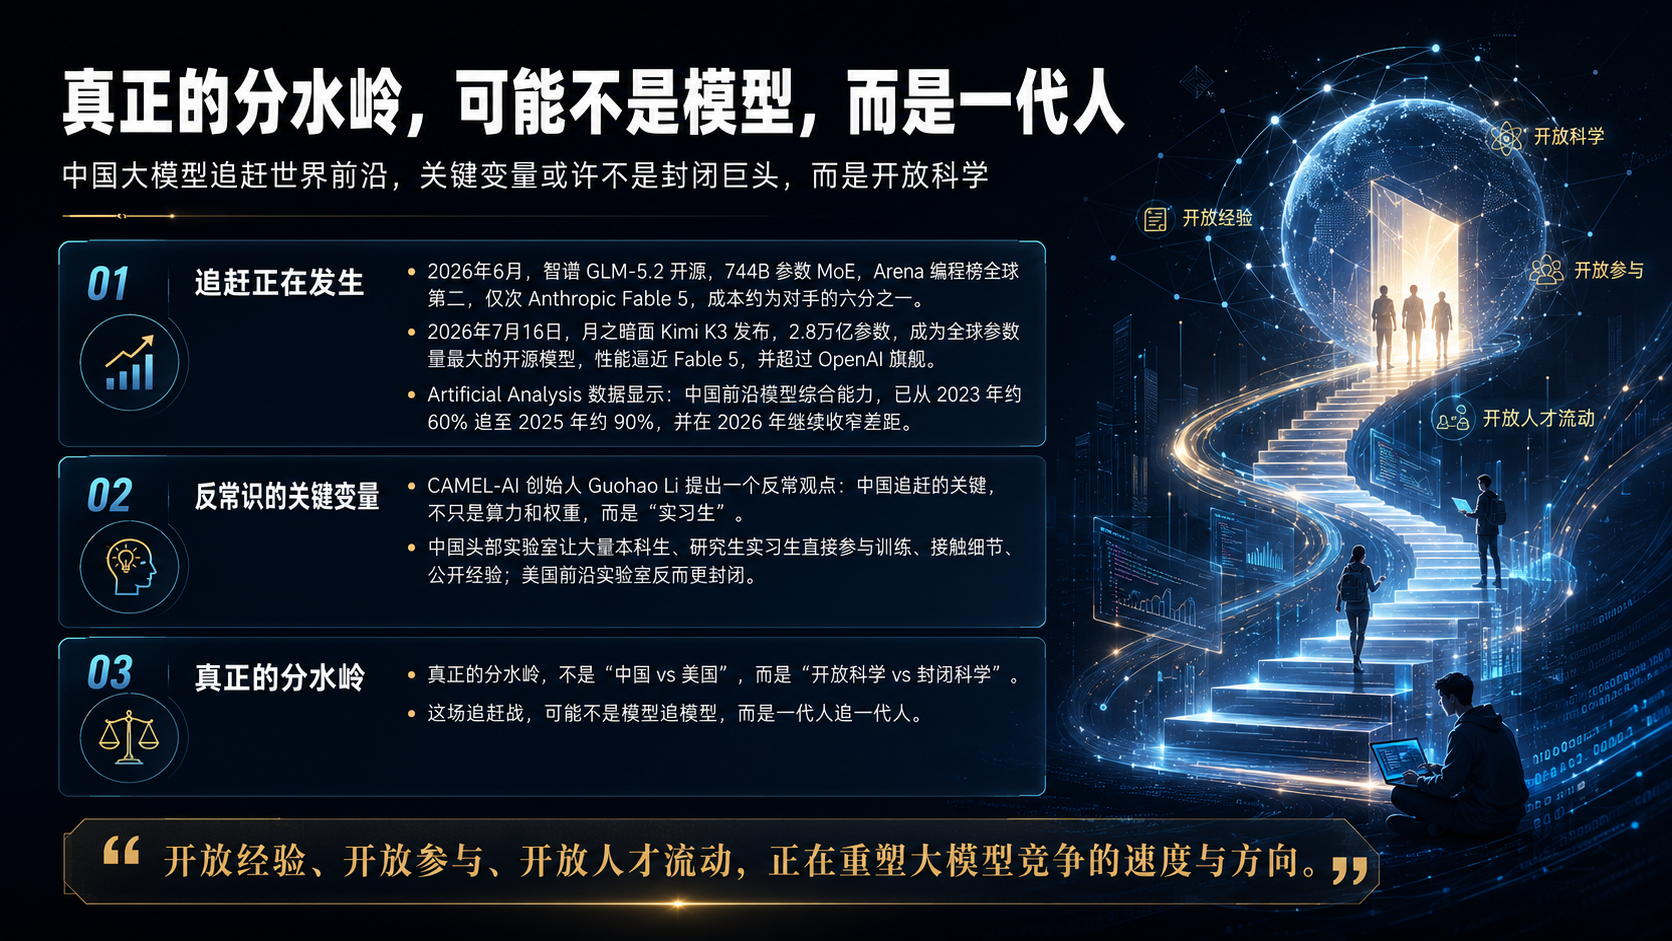
TL;DR
- 2026年6月,智谱GLM-5.2开源,744B参数MoE,Arena编程榜全球第二,仅次Anthropic Fable 5,成本约为对手的六分之一。
- 2026年7月16日,月之暗面Kimi K3发布,2.8万亿参数,成为全球参数量最大的开源模型,性能逼近Fable 5、超过OpenAI旗舰。
- Artificial Analysis数据:中国前沿模型综合能力已从2023年约60%追到2025年约90%,2026年继续收窄。
- CAMEL-AI创始人Guohao Li提出一个反常观点:中国追赶的关键,不只是算力和权重,而是"实习生"。
- 中国头部实验室大量本科生、研究生实习生直接参与训练,接触细节、公开经验;美国前沿实验室反而更封闭。
- 真正的分水岭不是"中国vs美国",而是"开放科学vs封闭科学"。
- 这场追赶战,可能不是模型追模型,而是一代人追一代人。
一、一个反常的解释
先看两个数字。
一个是744B,智谱GLM-5.2的总参数。一个是2.8万亿,月之暗面Kimi K3的总参数。
两个模型,一个6月,一个7月,前后不到五周。都开源,都是MoE,都把成本压到了美国旗舰的几分之一。GLM-5.2在Code Arena编程榜上拿到全球第二,商用可用模型第一;Kimi K3被《纽约时报》中文网直接放上标题——"美中AI差距进一步缩小"。
硅谷再一次坐不住了。
于是问题来了。中国实验室凭什么?
标准答案有很多。算力管制下的极致工程优化。开源社区的正反馈。DeepSeek点燃的估值和融资通道。国家意志的加码。这些都对。但都不新。
真正让人愣一下的,是CAMEL-AI创始人Guohao Li最近扔出来的那句话——
"中国懂得如何训练LLM的人才数量,比美国多100倍,而且还在不断增长。"
他给出的理由不是"我们更聪明",也不是"我们更卷",而是一个几乎没人正儿八经拿出来讨论的东西:
实习生。
二、实习生是怎么把模型训出来的
Guohao Li的观察很具体。
他见过太多中国实验室的实习生。本科、研究生,很多人对模型训练的细节理解得比你想象中深。更关键的是——他们愿意讲、愿意写、愿意开源。
这不是一个孤例。翻一下知乎,阶跃星辰基模团队的公开分享里,作者直接写了:负责模型指标评测的六人小组,"大部分是Intern同学"。这是头部实验室,做的是基座模型的评测判分,说白了,是训练监控的最后一道闸门。
这类岗位在美国前沿实验室会给谁?
答案是:多数根本不给。
OpenAI、Anthropic、xAI这一层,几乎不招本科实习生,研究实习生名额也极其稀缺。斯坦福、伯克利的博士生要抢一个能"训练适当规模模型"的机会,难度不亚于抢一次A轮融资的Term Sheet。核心的训练配方——数据配比、退火策略、RL细节、评测口径——被牢牢锁在少数几十号人手里。
而中国这边,情况反过来。
智谱、月之暗面、DeepSeek、阶跃、MiniMax、面壁、零一,这些公司的招聘页面常年挂着"研究实习生",甚至"本科生实习"。清华KEG、上海AI Lab、北大、交大的学生,能真刀真枪进到千亿模型的训练pipeline里。7月15日智谱和清华KEG联合发布的SAO算法,直接用在了GLM-5.2的生产训练管线里——这种校企合作不是挂个名,是学生真的写代码、跑实验、看loss曲线。
一个模型训练岗位,在美国是"稀缺资源",在中国是"实习机会"。
这就是Guohao Li说的"100倍"从哪儿来。
三、"开放"这两个字,被误读了很多年
一说到中国AI的开源,大家条件反射会想到"开放权重"。
Llama、Qwen、DeepSeek、GLM、Kimi,一个比一个大方,权重全放Hugging Face,MIT或Apache 2.0协议。GLM-5.2 744B放上去,Kimi K3 2.8万亿参数计划7月27日放出权重,直接刷新"全球最大开源模型"的纪录。
但权重开源只是表层。
真正让追赶加速的,是知识流动的开放。
去看这两年中国团队发的技术报告。DeepSeek V3的53页paper把MoE负载均衡、FP8混合精度训练、多token预测讲得清清楚楚;Kimi K2的技术报告把MuonClip优化器摊开;GLM-5.2的SAO异步强化学习算法,7月15日直接公开了单样本轨迹如何超越GRPO的完整逻辑。
对比一下美国这边。GPT-5.5的technical report有多厚?Claude Opus 4.8的训练细节公开了多少?Fable 5发布时给了几页paper?
大家心里都有数。
于是形成了一个非常有意思的不对称:
中国实验室在开源社区里"教别人训模型",美国实验室在闭源产品里"卖能力"。
一个是把配方摊在桌上,一个是把配方焊在锅里。
短期看,闭源守住了商业护城河。长期看,开放的一方在批量制造"下一代能训模型的人"。
四、为什么这件事被长期低估
因为它不像算力、不像资本、不像政策,没法做成一张漂亮的PPT。
你没法说"中国有多少张H100等效算力",也没法说"中国AI融了多少亿美金"。你只能说——中国有更多能上手训千亿模型的年轻人。
这个变量很难量化。但它会在两三年后变成压倒性的势能。
想想2016年前后的DeepMind和FAIR。那时候他们大量招实习生,AlphaGo、Transformer、BERT背后那批人,很多是从实习一路做上来的。整个深度学习圈的知识扩散,就是靠那几年的开放氛围撑起来的。
到了大模型时代,剧本变了。前沿实验室开始"闭关"。而中国实验室,无意中接过了那个开放的接力棒。
Artificial Analysis的数据可以佐证这一点:2023年,中国前沿大模型的综合能力约为美国顶尖模型的60%;到2025年,这个数字已经上升到90%。2026年6月GLM-5.2把Arena编程榜的差距压到不足1分,7月Kimi K3把开源规模拉到2.8万亿。
问一句:这种追赶速度,纯靠算力和资本堆得出来吗?
堆不出来。
美国对华芯片管制从2022年10月开始,到2026年已经将近四年,H100、H200、B200一波一波卡。中国实验室的算力总量,仍然远不及美国头部几家的总和。但模型差距在缩小,而不是扩大。
差在哪里被补上了?
差在人。差在那群愿意分享、愿意上手、愿意把训练细节写成博客的年轻人。
五、为什么美国的"封闭"也是理性选择
必须承认,美国前沿实验室的封闭,不是傲慢,是算计。
一个GPT-5.5级别模型的训练成本,据业内估计在数亿美元量级。Anthropic最新一轮融资估值1700亿美元,OpenAI超过5000亿美元。这些钱要向LP交代,要向股东交代。核心配方一旦扩散,就是几亿美元打水漂。
所以他们只能锁。锁配方,锁人,锁数据来源,锁评测方法。招进来的人签严格NDA,离职有竞业,博士生实习都得走层层审批。
从公司治理角度,无可指摘。
但代价是:整个美国AI人才池,正在被少数几家公司"漏斗化"。
真正能训前沿模型的人,全被吸进OpenAI、Anthropic、Google DeepMind、xAI、Meta这五六家。斯坦福、伯克利、MIT的博士生想接触,只能等实习。等不到,就去做应用层、做AI Infra、做垂直Agent。
十年后回头看,这可能是美国AI最大的一处结构性风险。
六、Kimi K3和GLM-5.2的深层信号
回到这两个模型本身。
Kimi K3的2.8万亿参数不是单纯"堆大"。它用KDA架构,原生多模态,100万token上下文,默认开启思考。月之暗面的招聘页面上,长期挂着"预训练实习生"、"RL实习生"、"评测实习生"。这些岗位不是打杂,是能碰到2.8万亿参数训练管线的岗位。
GLM-5.2背后的SAO算法,是智谱和清华KEG实验室联合发的。7月15日的公告里,唐杰明确点了合作单位。清华KEG实验室每年输出的硕士、博士,几乎无缝进入智谱的训练团队。这种"学校—公司"之间几乎没有壁垒的通道,在美国顶级实验室里已经很难看到。
DeepSeek更极端。梁文锋公开说过,团队里很多人是应届生、实习生。R1、V3的核心贡献者名单里,大量年轻面孔。
这三家的共同点是什么?
它们不把"训模型"当成秘密。它们把"训模型"当成一门可以教、可以练、可以传的手艺。
七、这件事对未来意味着什么
有三个判断。
判断一:中国开源模型的迭代速度会继续快于美国闭源模型。
因为参与训练的人在指数级增长。一个能训千亿模型的博士生,一年能带出三到五个能训百亿模型的师弟。开源社区的正反馈把这个乘数继续放大。
判断二:美国前沿实验室会被迫在"守配方"和"抢人才"之间做痛苦选择。
Meta已经开始动摇——Llama系列的开源策略反复。Google DeepMind的Gemma、Gemma 2也在往开放的方向挪。OpenAI在2025年破例发布了gpt-oss。这些不是慈善,是它们感受到了人才漏斗的压力。
判断三:真正的护城河,正在从"模型本身"转移到"训模型的人 + 用模型的场景"。
模型会越来越同质化。3T参数不会是终点,5T、10T都在路上。但能持续训出好模型的组织能力,以及能把模型嵌进业务的场景理解,才是下一阶段的稀缺品。
这两样东西,都需要大量的人。不是几百个天才,是几万个能上手的年轻工程师。
八、最后说几句
Guohao Li那段话最扎心的一句,其实不是"100倍",而是这一句——
"这不是中国或美国的问题。这是开放科学与封闭科学的问题。"
把它翻译成人话就是:AI的下半场,比拼的不是哪个国家的哪家公司锁得更严,而是哪个生态能让更多普通的年轻人有机会真正上手。
中国这一轮的"追赶红利",本质上是一次意外的开放红利。是被算力管制逼出来的开放,是被商业压力挤出来的开放,是被年轻人推着走的开放。
它不高尚,也不永久。哪天中国实验室融资到位、估值起来、也想学硅谷把门关上,这个红利就会消失。
所以真正值得记住的,不是GLM-5.2的744B,也不是Kimi K3的2.8万亿。
是那群还没毕业、就在跑千亿参数训练脚本的年轻人。
是他们在Hugging Face上发的第一个模型,在GitHub上提的第一个PR,在知乎上写的第一篇训练心得。
追赶从来不是模型追模型的事。
追赶是一代人追一代人的事。
而这一代年轻人,恰好被放在了一张相对开放的牌桌上。
牌桌能开多久,没人知道。
但至少现在,牌还在他们手里。
引用来源:
- 新华网:《中国企业发布全球最大规模的开源模型Kimi K3》,2026年7月17日
- 澎湃新闻《10%公司》:《2.8万亿!全球参数最大开源模型Kimi K3发布》,2026年7月
- 纽约时报中文网:《月之暗面Kimi K3问世,美中AI差距进一步缩小》,2026年7月20日
- 阿里云开发者社区:《智谱旗舰级大模型GLM 5.2深度实战》,2026年6月
- HappyRock:《智谱GLM-5.2·SAO异步强化学习算法:单样本轨迹超越GRPO》,2026年7月16日
- RFI:《中国AI模型GLM-5.2低成本挑战美国巨头》,2026年7月2日
- 36氪:《智谱破万亿,中国大模型终结「平替」叙事》(引Artificial Analysis与斯坦福AI Index数据),2026年
- Guohao Li(CAMEL-AI创始人)公开言论及个人主页 ghli.org、X账号 @guohao_li 相关帖子,2026年7月