语言模型 → 思维链 → Agent → 持续学习 → 自我迭代奇点 → 具身智能。
文章作者、来源:0x9999in1,ME News
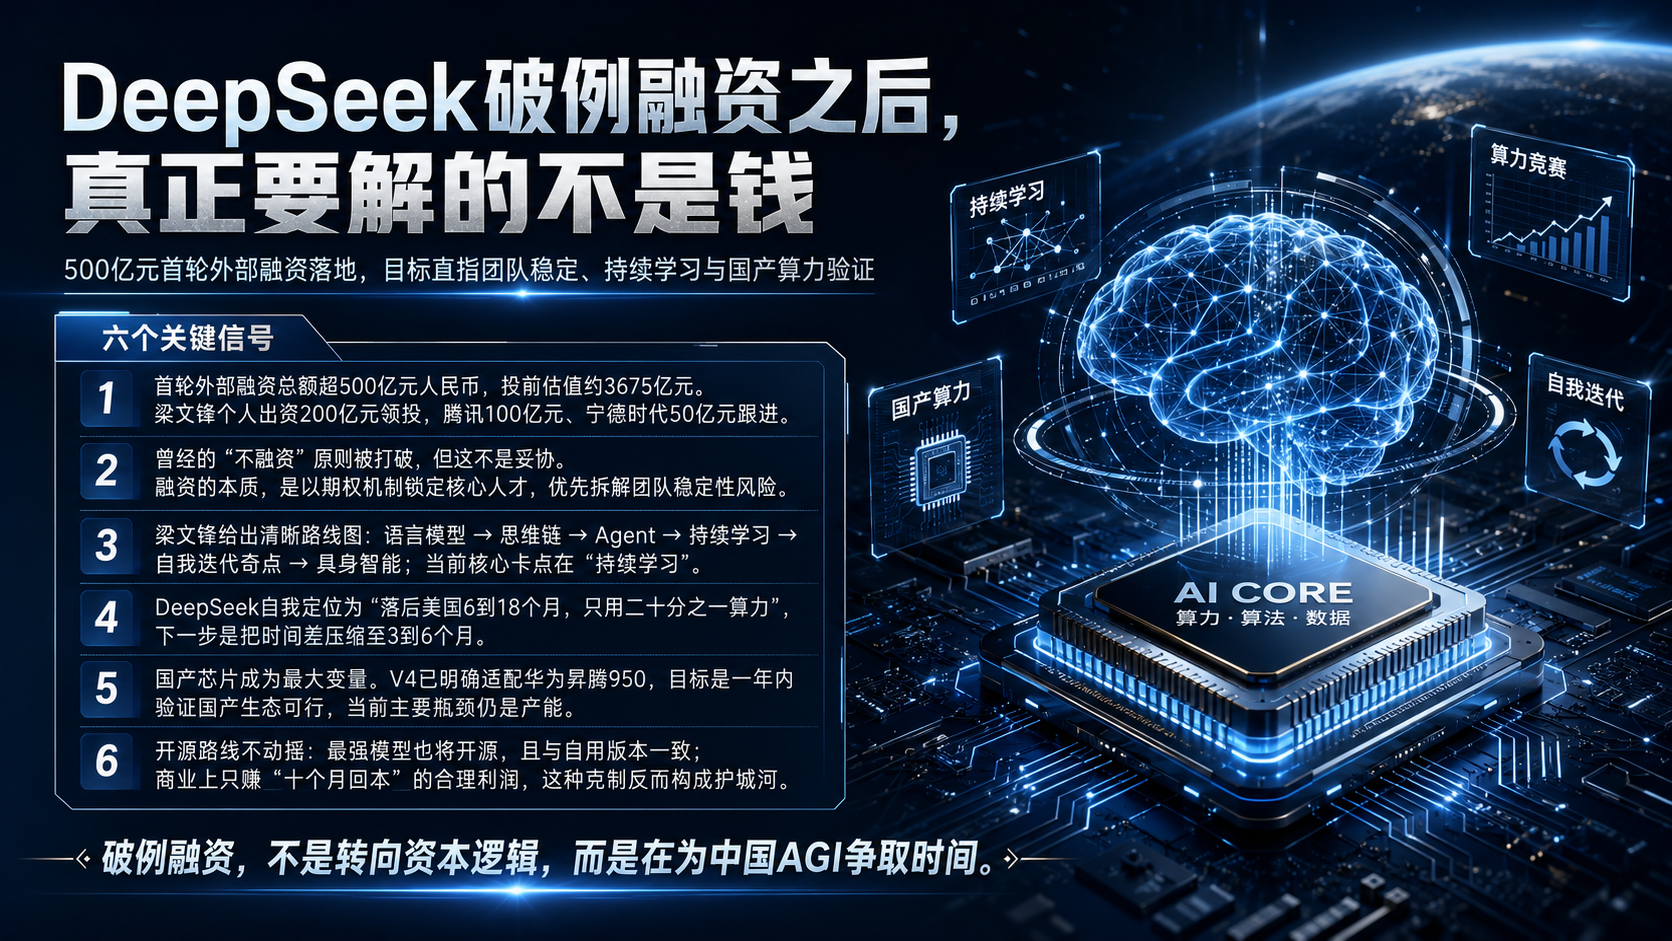
TL;DR
- DeepSeek 完成成立以来首轮外部融资,总额超 500 亿元人民币,投前估值约 3675 亿元(约 543 亿美元),梁文锋个人出资 200 亿元领投,腾讯 100 亿、宁德时代 50 亿跟进。曾经的「不融资」原则,破了。
- 但这不是妥协,是解题。梁文锋把「团队稳定性」称为唯一不可退让的核心利益,融资的本质是用期权锁人,把最大的风险一次性拆掉。
- 他给出了一张罕见清晰的路线图:语言模型 → 思维链 → Agent → 持续学习 → 自我迭代奇点 → 具身智能。当前卡在「持续学习」这一级。
- 算力仍是命门。DeepSeek 的自我定位是「落后美国 6 到 18 个月,只用二十分之一算力」,下一步目标是把时间差压到 3 到 6 个月。
- 国产芯片是最大的变量。V4 已明确适配华为昇腾 950,梁文锋赌「一年内证明国产生态没问题」,唯一瓶颈是产能。
- 开源不动摇,最强模型也开源,且与自用版本完全一致。商业上只赚「十个月回本」的合理利润。这套克制,反而是它的护城河。
DeepSeek 松口了。
三年不融资、不上市、不商业化。这是梁文锋亲口立过的规矩。如今规矩破了一半:首轮外部融资落地,超 500 亿元,投前估值 3675 亿元。梁文锋自己掏了 200 亿。
外界第一反应是什么?是「他终于向资本低头了」。
真的吗?
读完这份近 4 小时、118 条的梁文峰交流实录,得出的判断恰恰相反。这不是低头,这是一个极度克制的人,在用最不情愿的方式,去锁住他唯一在乎的东西。
融资不是转向,是把最大的风险一次拆掉
先看牌桌。梁文锋个人出资 200 亿,是绝对的最大单一出资方,牢牢控股。腾讯 100 亿,宁德时代体系 50 亿,网易、京东、IDG 各 30 亿,国家人工智能产业投资基金 10 亿。
这份名单不是随便凑的。梁文锋自己说了,融资对象是「精心挑选」的,标准只有一个:利益最一致、对我们最没有敌意、最希望我们做成的。
腾讯给云和流量,宁德时代给能源和产业场景,国家队给背书。没有一个纯财务投机者。这是一份「战略盟友清单」,不是「募资清单」。
那为什么要融?
答案藏在他反复强调的一句话里:「我们最大的核心利益是保持团队的稳定性,甚至可以认为是唯一的核心利益。」
他把这件事说得毫不掩饰。团队稳定,是他眼里最大的风险,也是最大的软肋。硅谷大厂开出一个亿美金年薪挖人的时代,一家没上市、员工手里期权无法变现的公司,凭什么留住那批最老、最核心的研究员?
融资之后,他自己给出了答案:「这个风险随着近期这次融资,得到了比较大的解除。因为大家拿到的期权金额还是比较大的。」
看懂了吗?这轮融资的第一目的,不是买卡,不是扩张,是给核心团队一次真金白银的兑现。是把「人会不会跑」这个悬在头顶的问题,一次性按下去。
钱不是问题,卡是问题,人心才是最贵的资源。梁文锋想得很透。
那张路线图,才是这次交流会真正的重头戏
如果说融资是新闻,那路线图才是内核。
梁文锋把 AGI 的演进描述成一段阶梯,每一级都不白走:
去年的阶梯,是思维链。今年的阶梯,是 Agent。而 Agent 之后,他反复咬住一个词——持续学习。
他的逻辑链条锋利得像手术刀。AI 现在能替代员工吗?不能。为什么?因为它不能像新人那样「到公司学两个月就上手」。可一旦它具备持续学习的能力呢?他说:「那就可以替代天下的人了。」
再往上,是奇点。当模型能持续学习,它就能自己开发下一版自己。AI 加速 AI。到那时增长不再是线性的。
最后才是具身智能——走进现实世界,做家务,养老。
这套顺序值得玩味。市场上最火的视频生成、世界模型,梁文锋直接判了「不在主线上」。他说得很直白:视频生成在商业上是好生意,但「跟智能没有什么关系,我们不会因为它是好商业而去做它」。
这是一种什么样的定力?
当整个行业都在追逐能立刻变现、能博眼球的多模态炫技时,DeepSeek 说,我只做智能主线上的事。这不是清高,这是聚焦——聚焦到「要做的事情很少,所以不需要加班」。
有意思的是,市场已经在替这套判断投票。就在今年 7 月,DeepSeek V4 完成正式版发布。V4-Pro 走的是 1.6 万亿参数的稀疏专家架构,每 token 只激活约 490 亿;V4-Flash 更轻,2840 亿总参数、激活 130 亿。两者都带 100 万 token 超长上下文,MIT 协议全部开源。在 SWE-bench Verified 这个编程基准上,V4 刷出了 80.6% 的开源模型最高纪录。
主线聚焦,果然长出了果实。
「落后两年、只用二十分之一算力」,这句自嘲里全是野心
梁文锋对差距的判断,坦率得让人意外。
他说,DeepSeek 跟美国的差距主要在资源上,人上几乎没有差距——「就是同一批人,可能是中国人」。有些留国内,有些去了国外,并不是聪明的都出去了。
那差距到底在哪?他给了一个近乎公式化的表述:落后美国 6 到 18 个月,只用美国二十分之一的算力,把事情做出来。
这句话表面是认怂,骨子里是骄傲。二十分之一的算力,做出只落后一年多的效果——这本身就是一种恐怖的效率。
而他真正的野心,是接下来那句:「未来我们要把这个叙事改写,用它几分之一的算力,把时间差缩到 6 个月、3 个月。」
从「二十分之一算力、落后两年」,改写成「几分之一算力、只差三个月」。这才是 DeepSeek 后续发展道路的真正坐标。
为什么算力这么关键?他说得毫不含糊:「我们看到的所有区别,包括人才、模型能力、应用的区别,都可以认为是因为算力资源上的区别。」他信 Scaling,也承认阻止 Scaling 的唯一障碍就是没那么多卡。
那么问题来了——卡从哪来?
赌国产芯片,是这次交流会里最大胆的一笔
这是我认为整份实录中最有分量、也最需要时间验证的判断。
梁文锋对国产算力「比较乐观」。他甚至说了一句很重的话:「在国产算力这一点上,英伟达是在掘自己的坟墓。」
他的论据分三层。
第一层,CUDA 的护城河在快速瓦解。原因反而是 AI 本身——有了会写代码的 AI,重建生态比过去容易太多。
第二层,DeepSeek 已经在实操中「去英伟达生态」。他透露,V3 训练时虽然还用英伟达的卡,但已经几乎不用它的生态了,办法是先写一个叫 TileLang 的高级编译器,在此之上完成其余所有工作。
第三层,也是最关键的落点:华为。他判断华为的 950 超节点在性能和价格上可以「完全平替英伟达的 GB200、GB300」,并甩出那句已经传开的话——「四张华为卡顶一张英伟达的卡。」
这不是空谈。今年 4 月 V4 发布时就已明确适配华为昇腾 950。而 DeepSeek 公开表态过:预计 2026 年下半年昇腾 950 超节点批量上市后,V4-Pro 的单位 token 成本才有望大幅下调。梁文锋把唯一的问题归结为「产能不足」,硬件和生态「都没有问题」。
他甚至给了一个可被检验的时间表:「未来一年之内,我们能看到国产芯片的生态完全没有问题被验证。」
这是一句会被时间打脸、也可能被时间加冕的话。我更倾向于相信后者——因为在英伟达高端卡买不到的现实约束下,「所有人迫不得已都要去做国产」,需求会强行把生态催熟。约束逼出创新,这在 DeepSeek 身上已经上演过一次。
开源、定价、赚合理的钱:克制本身就是战略
回到那个最初的疑问:破了「不融资」的规矩,DeepSeek 会不会也顺势破掉「不商业化」的克制?
看数据,答案是不会。
开源,梁文锋态度斩钉截铁:会开源,最强的模型也会开源,而且开源版本和自己部署的版本完全一致,不会藏一手。他反问:闭源有什么好处?「字节的模型是闭源的,它有什么好处?我看不到。」
更关键的是他对开源与收入关系的判断——「开源对我们的商业模式没有任何影响。」因为哪怕把所有东西都给你,别人要用起来、还要把成本做到足够低,门槛依然极高。
定价上,他同样克制到近乎「反商业直觉」。DeepSeek 的 API 定价,目标只是「买一批设备回来,十个月收回成本」的合理利润。他坦承,若要利润最大化,价格应该定得更高,因为这个区间用户需求几乎没有弹性——价格翻倍,token 消耗也差不多。可他偏不。曾经一款模型定价偏高、团队不开心,他直接把价格砍到四分之一。
这份克制,落到今天的市场上是什么景象?V4 正式版走「峰谷定价」,高峰时段翻倍、平谷时段极低;而在开源模型阵营里,它把闭源旗舰的价格拉出了以「倍数」计的差距。有测算把这个价差形容为一个数量级到两个数量级之间。
梁文锋对此有一句总结,我认为是整场交流的题眼:
「拿得多的人,会被拿得少的人打败。你愿景是拿得多,你就先输了。」
这不是道德表演。这是他反复验证过的战略:克制能提高做成 AGI 的概率;越克制,越容易做成。
结语:一家不想当「下一个字节」的公司,要去哪儿
那么,DeepSeek 的后续道路,到底通向哪里?
把这 118 条拼起来,图景其实清楚。
它不做超级 App,不跟腾讯字节抢地盘。它明确要商业化——「政府不会给我一分钱」,最坏情况「全力卖 API,也够支撑一家上市公司」。当下的商业重心是通用 Agent,尤其是 Coding Agent,其他垂直 Agent 优先级更低。它甚至已经透露,若今年 B 端能有几亿美元收入、叠加 C 端用户,「公司离净利润已经不远了」。
而市场也在给它更远的想象。融资尘埃刚落,就已有关于 DeepSeek 最快明年在内地上市、估值继续攀升的传闻流出。曾经那个说「不上市」的人,正被资本一遍遍地追着「刷卡」。
但你要问梁文锋在乎这些吗?
我猜他不太在乎。因为他把话说死了:真正的目标,是让 AGI 帮他迭代下一版模型,有了具身之后就让机器人造下一版机器人。至于份额、暴利、市值——「AI 这个事情太大了,你随便分一点,利益就非常大」。
一个愿意拿得更少的人,一群自称「非常平凡」的人,用二十分之一的算力,追着世界最前沿只差一年多。
现在,他们拿到了 500 亿,锁住了人心,赌上了国产芯片,把时间表摊在了桌面上。
接下来的一年,就是验证期。国产生态到底行不行,持续学习能不能突破,「三个月」的叙事能不能立住——答案不在 PPT 里,在昇腾的产能爬坡里,在 V5 的训练日志里。
克制的人,往往笑到最后。这一次,我愿意等着看。
引用来源:
- 新浪财经:《DeepSeek 融资会议实录:梁文锋拆解下的大模型技术与商业逻辑》,2026 年 7 月 23 日
- 东方财富网:《DeepSeek 首轮融资落地,总额约 510 亿元,腾讯、宁德时代等参投》,2026 年 7 月
- 大河报·大河财立方:《梁文锋 4 小时投资会讲话流出:DeepSeek 为什么不做「更赚钱」的事》,2026 年 7 月
- 新浪财经(《财经》报道):《DeepSeek-V4 明确支持华为昇腾 950 芯片》,2026 年 4 月 24 日
- 财联社:《DeepSeek:预计下半年昇腾 950 超节点批量上市后 V4-Pro 使用成本有望大幅下调》,2026 年 7 月 23 日
- EET-China:《DeepSeek V4 引爆国产算力狂欢:华为昇腾 950 遭大厂「疯抢」》,2026 年 4 月
- meshlaunch:《DeepSeek V4 Full Release (July 2026): Pricing, Benchmarks & Migration》,2026 年 7 月 20 日
- n1n.ai Explore:《DeepSeek V4 GA and Open-Source: Analyzing the LLM Price Gap》,2026 年 7 月 21 日