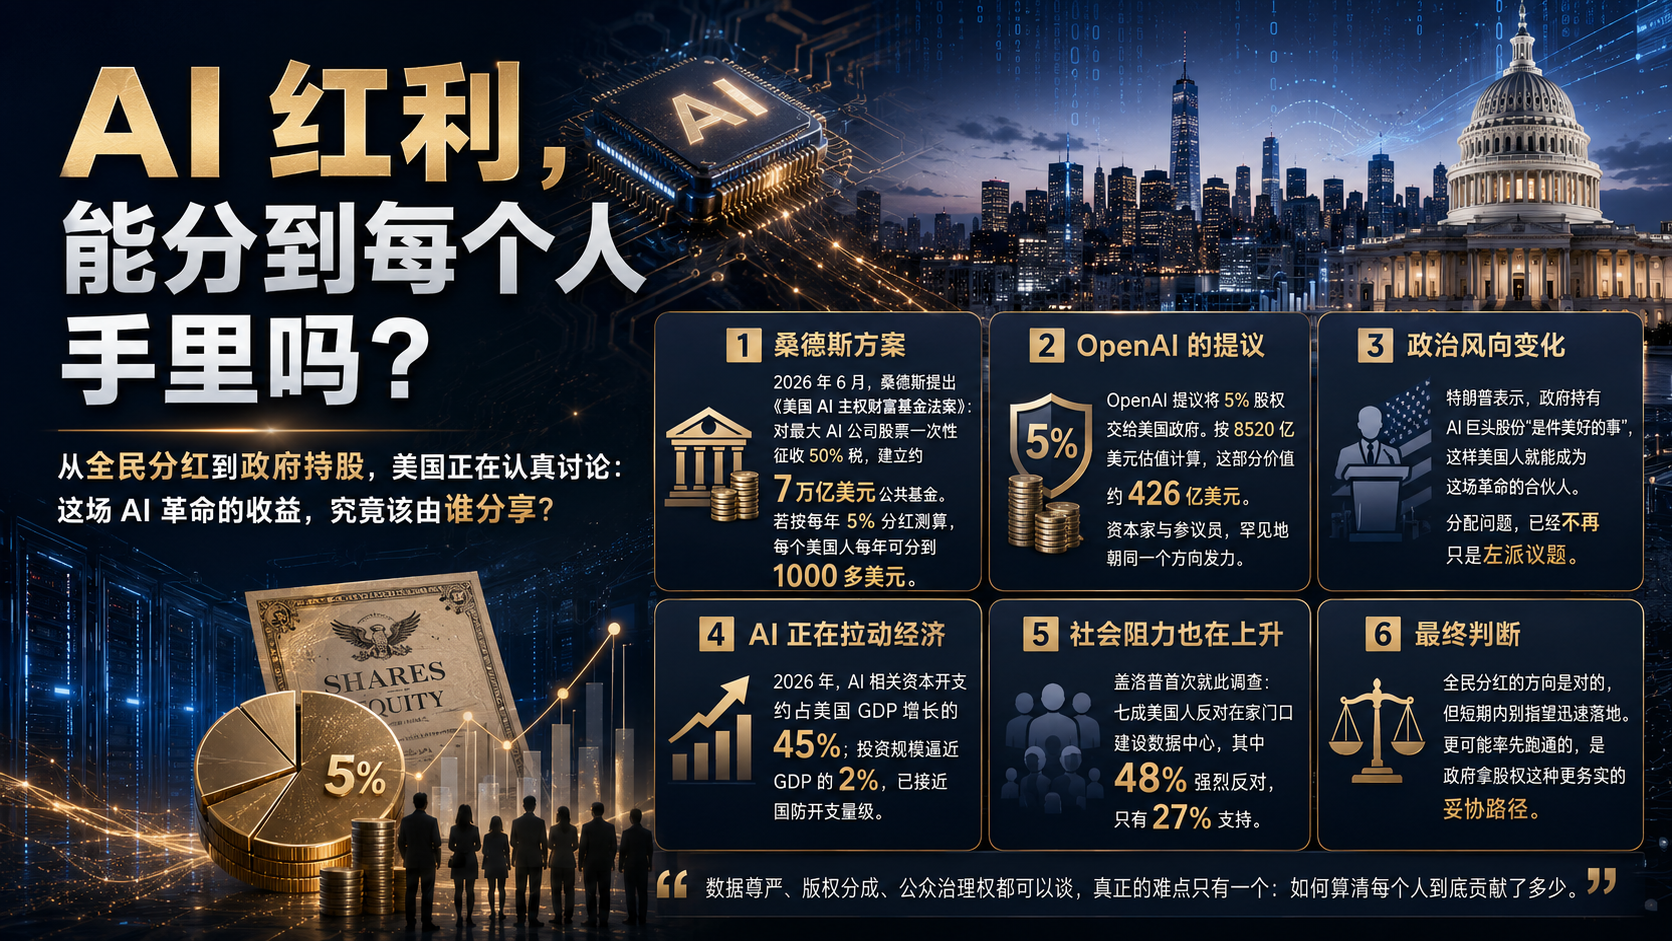
数据尊严、版权分成、公众治理权——路径很多,难点只有一个:怎么算清每个人到底贡献了多少。
文章作者、来源:0x9999in1,ME News
TL;DR
- 桑德斯 2026 年 6 月提出《美国 AI 主权财富基金法案》,主张对最大 AI 公司股票一次性征 50% 税,建一只估值约 7 万亿美元的公共基金,每年拿 5% 分红,给每个美国人发 1000 多美元。
- 奥尔特曼这边也在动作:OpenAI 提议把 5% 股权交给美国政府,按 8520 亿美元估值算,约 426 亿美元。资本家和参议员,罕见地朝同一个方向使劲。
- 特朗普说政府持股 AI 巨头「是件美好的事」,能让美国人「成为这场革命的合伙人」。分配问题已经不是左派专利。
- AI 正在真金白银地拉动经济:2026 年 AI 相关资本开支约占美国 GDP 增长的 45%,投资规模逼近 GDP 的 2%,接近国防开支量级。
- 代价也在扩散:盖洛普首次就此调查,七成美国人反对家门口建数据中心,48% 强烈反对,只有 27% 支持。
- 数据尊严、版权分成、公众治理权——路径很多,难点只有一个:怎么算清每个人到底贡献了多少。
- 我的判断:全民分红这条路,方向对,但别指望它明天落地;真正会先跑通的,是政府拿股权这种「务实的妥协」。
一座金山正在长出来,但门票只发给了少数人
先说一个不太浪漫的事实。
AI 不是概念了。它是钱。
2026 年,超大规模厂商的数据中心资本开支预期被上修到约 7400 亿美元。这个数字什么概念?AI 相关的资本形成,贡献了美国这一年 GDP 增长的大约 45%。有分析师算得更狠——2026 年第一季度,把数据中心建设剥离出去,全球最大经济体的增长几乎归零。
TS Lombard 的测算是,AI 与数据中心基础设施投资今年将占到美国 GDP 的约 2%。听着不多?那是接近国防开支的量级。一个新行业,几年时间,烧到了跟五角大楼一个体量。
钱是真的。增长也是真的。
问题来了:这座金山,是谁的?
答案让人心里不太舒服。它主要反映在几家科技公司飙升的市值里。股东笑了,高管笑了,早期投资人笑了。
那普通人呢?
普通人负责另一件事:承担成本。
你家后院的数据中心,没人想要
盖洛普做了一次调查。这是他们第一次问这个问题——因为全国各地的反对声实在太大,大到不问不行。
结果是:七成美国人反对在自己所在地区建 AI 数据中心。48% 是「强烈反对」。支持的只有 27%,其中「强烈支持」的,只有 7%。
七比一。这不是分歧,这是压倒性的拒绝。
另一份来自 Data for Progress 的民调更直接:63% 的选民支持暂停数据中心建设至少一年。民主党人、独立选民、共和党人——三边都过半。在今天这个撕裂到极致的美国,能让三党选民一起点头的事,屈指可数。
这说明什么?
说明老百姓不傻。他们看得清一笔账:数据中心要占地、要抢电、要抢水,电费可能被推高,噪音就在窗外。而模型训练出来的收益,去了硅谷,去了华尔街。
成本本地化,收益全球化。风险大家扛,红利少数人拿。
这种不对称,一旦被点破,就成了政治火药。
难怪它已经从技术议题,变成了科技政策和未来选举的议题之一。
桑德斯开了第一枪:公众该拥有一半
2026 年 6 月 18 日,伯尼·桑德斯递交了《美国 AI 主权财富基金法案》。
他的逻辑简单得像一句大白话:一个公共资源创造了财富,公众就该分。
具体怎么做?对最大的几家 AI 公司,一次性征收 50% 的股票税——注意,征的是股票,不是利润。这些股票存进一只主权财富基金。按当前估值,这只基金约值 7 万亿美元。先拿 5% 年度分红,就能给每个美国人直接发 1000 多美元。
他还设计了一个「民主 AI 独立委员会」来管这只基金,用投票权去否决那些伤害公众的决策。
桑德斯的原话很有画面感:AI 不是从马克·扎克伯格脑子里蹦出来的,也不是埃隆·马斯克想象出来的。它建立在全人类的集体知识、几千万人的创造性劳动之上。
这话对不对?
对。模型吃的是全人类的语料。你写的每一条帖子、每一段代码、每一篇文章,都可能成了它的养料。
那凭什么收益跟你一点关系没有?
这一枪,打中了要害。
但要我说实话——这只基金短期内很难变成法律。50% 的一次性股票税,在当下的国会,几乎不可能通过。它更像是一面旗帜,一个把问题摆上台面的姿态,而不是一份能马上执行的施工图。
方向,我认。落地,我存疑。
奇怪的一幕:资本家主动递上了 5%
真正有意思的,是另一边的动作。
桑德斯要「征」50%,而 OpenAI 自己「送」5%。
2026 年 7 月,据《金融时报》报道,OpenAI 提议把 5% 的股权交给美国政府。按 3 月那轮把估值推到 8520 亿美元的融资算,这 5% 约合 426 亿美元。
奥尔特曼的说法是:让公众对公司有财务上的利益,是分享 AI 上行收益的最好方式。
早在 4 月,OpenAI 就在一份叫《智能时代的产业政策》的文件里,提出建一只「公共财富基金」,让每个公民——包括那些手上没有任何金融资产的人——都能分到 AI 增长的一杯羹。
这个提议里还藏着一层野心:不只是 OpenAI,而是设想 Anthropic、谷歌、Meta 这些公司都通过一个政府主权基金,交出类似的 5% 股份。
你要问了:资本家为什么这么大方?
别天真。这不是慈善。
这是止痛药。华盛顿的压力越来越大——对模型的网络安全担忧、对来自中国的开源模型又强又便宜的焦虑、对财富过度集中的政治不满。主动交出 5%,是买平安,是换取善意,是给监管的怒火先浇一盆水。
特朗普那边也接得很顺。他说政府持股 AI 巨头「是件美好的事」,能让美国人「成为这场革命的合伙人」。他第二任期本来就干过这事——去年 8 月,联邦政府通过 89 亿美元投资,拿下了英特尔 10% 的股份。
所以你看到了一个荒诞又真实的画面:社会主义者桑德斯和总统特朗普,在「公众该分 AI 的钱」这件事上,居然站到了同一侧。
只是一个想要一半,一个觉得拿点就好。
数据尊严:钱该按贡献发,可贡献怎么算?
除了「拿股权」这条粗线条的路,还有更精细的思路。
微软的科学家杰伦·拉尼尔,多年前就提出了「数据尊严」(Data Dignity)。
核心一句话:谁贡献了训练数据,谁就该拿报酬。
你的照片、你的文字、你的声音,喂给了模型,模型因此变强、变值钱。那这份价值里,该有你的一份。
顺着这个思路,有研究者提出了类似音乐版权分成的机制:AI 公司拿出一部分利润,投进一个共享池,再按每个人的数据对模型性能的贡献大小来分配。
听起来很美。像不像流媒体给音乐人结算版税?
可这里有个绕不过去的坎。
音乐版税好算,因为一首歌就是一首歌,播放一次记一次。可 AI 模型呢?它吞下的是几百万、甚至几十亿个数据源。你写的一条推文,到底让 GPT 变强了万分之几?还是亿分之几?
没人算得清。
这不是技术细节,这是整个方案的命门。贡献无法精确度量,分配就无从谈起。共享池的钱,最后很可能变成一笔糊涂账——要么按人头平摊,那「尊严」就成了空话;要么由公司说了算,那又回到了少数人拍板的老路。
数据尊严的方向是对的。它提醒我们:AI 的价值有你的份。
但从「理念」到「支票」,中间隔着一道目前还跨不过去的鸿沟。
还有人想要的不是钱,是权力
RadicalxChange 基金会给出了第四种答案。
他们的想法更根本:与其纠结分多少钱,不如先争分配的话语权。
具体是通过一套新的法律权利体系,让公众组织能在 AI 企业面前,拥有获取股份、报酬和治理权的能力。
翻译成大白话:让公众不只是被动地领分红,而是能坐到桌子边,参与决定 AI 该往哪走。
这个思路,我觉得触及了更深的东西。
因为钱只是结果,权力才是源头。如果分配规则永远由那几家公司和几个亿万富翁定,那今天给你发 1000 美元,明天就能以「经营困难」为由收回去。
治理权,才是那把能锁住红利的锁。
当然,难度也最大。让一家市值上万亿的公司,主动让渡治理权给公众组织?这几乎是与资本的本能对着干。
我的判断:别等乌托邦,先接住能落地的那一部分
聊了这么多方案,我得给个态度。
全民主权基金,方向对,但太理想。桑德斯的 7 万亿,是一面旗,不是一张能兑现的支票。指望它明天进国会、后天发钱,不现实。
数据尊严和版权分成,理念动人,但卡在「算不清」这个死结上。技术不突破,它就永远停在 PPT 里。
公众治理权,最治本,也最难,是长期主义者的战场。
那什么会先跑通?
恰恰是那个看起来最不浪漫的——政府拿股权。
因为它对各方都「够用」。公司拿它换监管的善意,政治家拿它对选民交代,政府拿它握住一点筹码。它不完美,甚至有明显的问题:政府既当裁判又当股东,利益冲突怎么办?安全监管会不会因为「自己也是股东」而手软?
这些担忧都真实存在,专家已经在警告了。
但历史往往就是这样。理想主义提出问题,务实主义先落地一个不完美的答案。
所以我的预测是:未来一两年,你大概率看不到全民 AI 分红账户,但很可能看到某种形式的「政府持股 + 公共基金」框架,先立起来。
它不会让每个人都满意。它会被左派骂太少,被右派骂太多,被科技公司嫌太烦。
可这恰恰说明,它踩在了那个艰难的中间点上。
尾声:金山还在长,分配的战争才刚开始
回到最开始那个问题:谁该分走 AI 造出来的金山?
到今天,美国也没有答案。有的只是四条路、无数争论、和一场正在升温的政治博弈。
但有一件事是清楚的。
当 AI 贡献了近一半的 GDP 增长,当七成人反对它建在自家门口,当参议员和总统罕见地都开始谈「公众该分一份」——这个问题就再也回不去了。
它不会因为难,就消失。
金山每长高一寸,「凭什么」这三个字就更响一分。
技术的问题,工程师能解。分配的问题,只能靠社会自己吵出来、谈出来、投票投出来。
这场仗,才刚刚开打。
而普通人第一次意识到:原来自己不只是围观者。
那些被喂进模型的数据里,有你的一行字。
这一行字,值多少钱,该怎么分——
这一次,该轮到我们自己开口了。
参考来源
- Gallup, "Americans Oppose AI Data Centers in Their Area", 2026
- Data for Progress, "Voters Support a Data Center Moratorium", 2026 年 6 月
- Office of Senator Bernie Sanders, "Sanders Introduces Legislation to Create $7 Trillion AI Sovereign Wealth Fund", 2026 年 6 月 18 日
- CNBC, "OpenAI proposes 5% stake to Trump administration to ease Washington pressure: Report", 2026 年 7 月 2 日
- Financial Times, "OpenAI proposes handing US government a 5% stake", 2026 年 7 月
- Federal Reserve, "The AI Buildout and the Economy: Publicly Available Data to Assess AI's Impact", 2026 年 7 月 17 日
- Forbes, "AI Investment Will Hit 2% Of U.S. GDP This Year, Analyst Says", 2026 年 6 月 5 日
- OpenAI, "Industrial Policy for the Intelligence Age", 2026 年 4 月