2026 年 7 月 27 日,月之暗面把 Kimi K3 的完整权重传上 Hugging Face,2.8 万亿参数,成为迄今规模最大的开放权重模型,距 7 月 16 日 API 首发正好 11 天。
文章作者、来源:0x9999in1,ME News
TL;DR
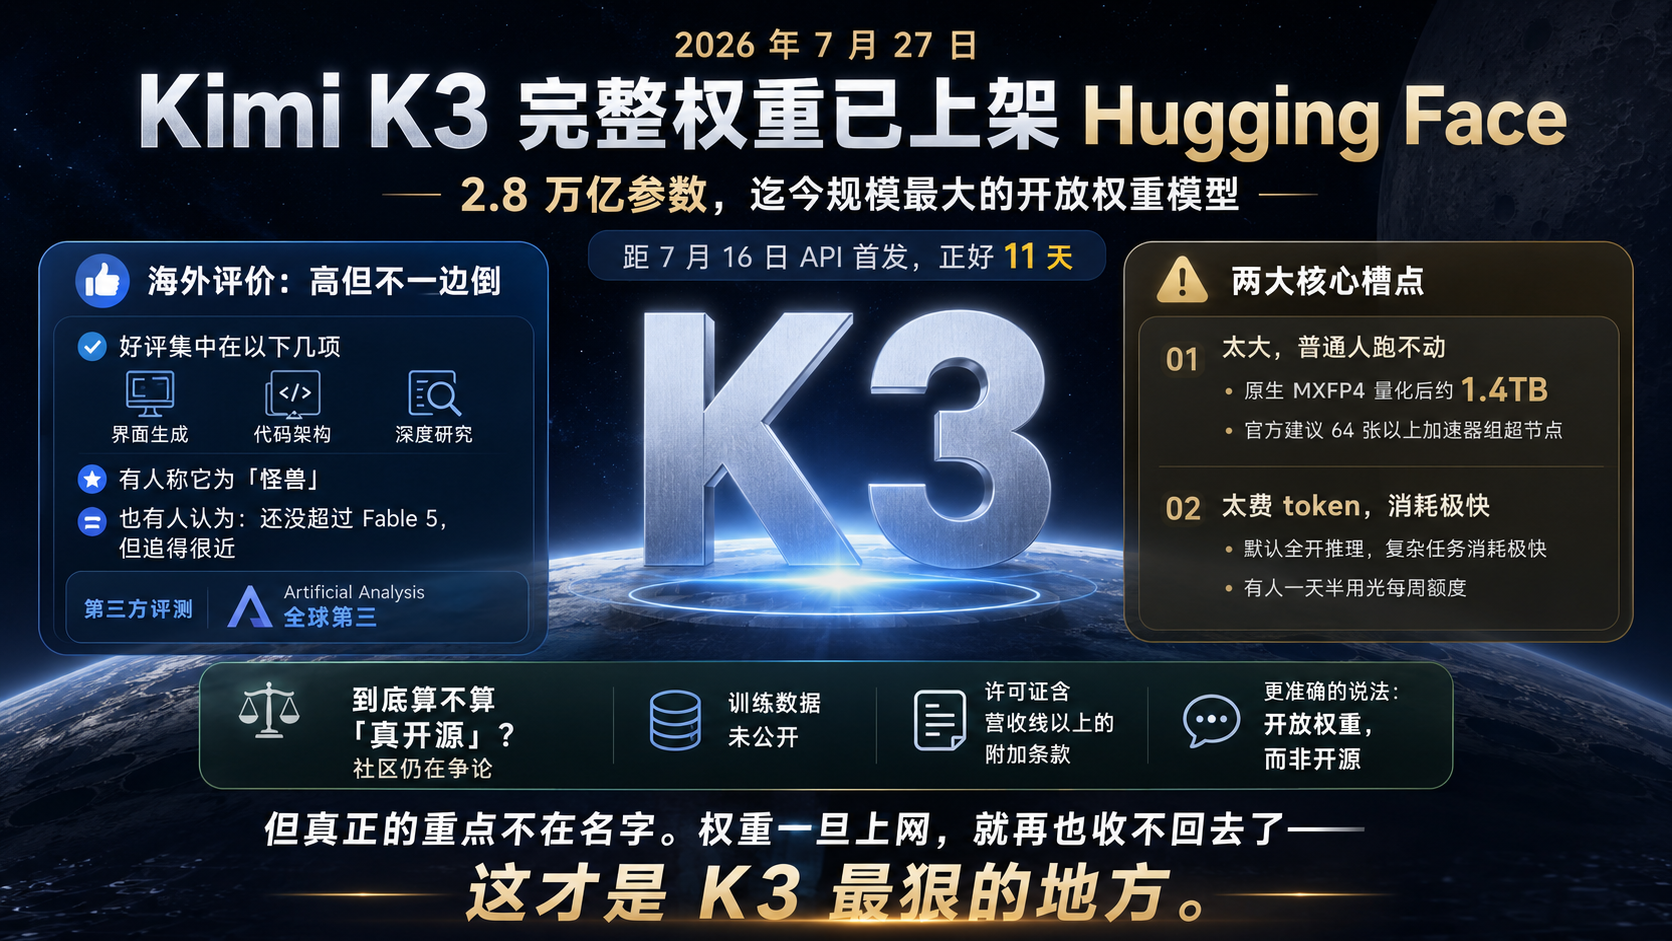
- 2026 年 7 月 27 日,月之暗面把 Kimi K3 的完整权重传上 Hugging Face,2.8 万亿参数,成为迄今规模最大的开放权重模型,距 7 月 16 日 API 首发正好 11 天。
- 海外社区评价高但不一边倒:夸的人叫它「怪兽」,界面生成、代码架构、深度研究是好评最集中的几项;也有人说它还没超过 Fable 5,但追得很近。第三方 Artificial Analysis 把它排到全球第三。
- 最大的槽点是「太大」:原生 MXFP4 量化后约 1.4TB,官方建议 64 张以上加速器组超节点,普通人根本跑不动。
- 第二个槽点是「太费 token」:默认全开推理,复杂任务消耗极快,有人一天半用光每周额度。
- 社区仍在吵它算不算真开源:训练数据没公开,许可证有营收线上的附加条款,更准确的说法是「开放权重」。
- 但真正的重点不在名字。权重一旦上网,就再也收不回去了——这才是 K3 最狠的地方。
一台谁都开不走的怪兽
先说结论。Kimi K3 是好东西,这点争议不大。
海外社区吵得热闹,但底色是认可。有人直接叫它「怪兽」,说它已经摸到了顶级闭源模型的门槛。好评最集中的地方很具体:界面生成、代码架构、深度研究。这三样,恰好是开发者每天真金白银在用的。
也有冷静的声音。有人说,它还没超过 Anthropic 的 Fable 5。这话不假。连月之暗面自己的发布材料都承认,K3 的整体性能仍落后于 Fable 5 和 GPT-5.6 Sol,用户体验也存在差距。第三方独立机构 Artificial Analysis 给出的智能指数是 57 分,全球第三,与 Claude Opus 4.8、GPT-5.5 同档。
但你换个角度看这个「第三」。
它把其他开源模型甩开了多少?GLM-5.2 是 51 分,DeepSeek V4 Pro 是 44 分。K3 在开源阵营里不是领先半个身位,是领先了一整个身段。前端编码那一战更出圈:在 Arena 采用人类盲测投票的 Frontend Code Arena 上,K3 上线当日拿到 1679 分登顶,相比上一代 K2.6 的第 18 名,直接跳了 17 位。
所以「追得很近」这个描述,本身就是重磅新闻。一个能下载、能改、能自己部署的模型,追到了闭源第一梯队的屁股后面。这在一年前,是没人敢想的画面。
那问题来了:既然这么强,为什么社区没有一边倒地欢呼?
因为绝大多数人,连让它跑起来的机会都没有。
摆在橱窗里的 F1
Reddit 上有个比喻传得很广——K3 像一台摆在橱窗里的 F1 赛车。性能确实炸裂,但普通人根本开不回家。
这话扎心,却是实话。
K3 是 2.8 万亿总参数、1040 亿激活参数的 MoE 巨兽,896 个专家里每个 token 激活 16 个。它天生就是 MXFP4 原生 4-bit 量化训练出来的,也就是说,别的开源模型发布后靠量化「减肥」的那 4 倍空间,K3 在出厂前就已经花掉了。
这意味着什么?意味着你别指望社区再给它砍一刀。按半个字节一个参数算,2.8 万亿参数光权重就约 1.4TB,还没算 100 万上下文窗口的 KV 缓存。就算真有人搞出 2-bit 的极限量化版,也还在 700GB 以上——质量还没人敢打包票。
一台 512GB 的 Mac Studio?够不着。一台塞满 GPU 的工作站?差得远。月之暗面自己给的部署建议是:64 张以上加速器组成的高带宽超节点。
有意思的是,社区里真有人较劲。已经有开发者把大量 RTX 5090 连成集群,硬是把完整的 K3 跑了起来。它没用 H100、H200 那种天价数据中心卡,听着像是「平民路线」。但你算算 80 张 5090 是什么概念,这套设备依然不是任何一个普通玩家负担得起的东西。
Ollama 上倒是有个 K3 的页面,看着像本地支持来了。别高兴太早——那是个云端接口,请求会发到 Ollama 的服务器,还要订阅付费、消耗额度。Hugging Face 上也有社区转的 GGUF 文件,但 llama.cpp 根本加载不了这套架构,那些文件下载下来谁都打不开。别为它浪费一个周末的带宽。
所以「开源」这两个字,对 99% 的个人开发者来说,此刻更像是一张看得见摸不着的门票。
又强又贵:token 是怎么烧掉的
就算你搞定了硬件,还有第二道坎——它太费 token。
多位实测者反馈,做同一个复杂任务,K3 比 Fable 消耗更多 token。因为它默认全开 max reasoning 推理模式,思考时间长,喜欢把链路拉得很深。深度推理是它的强项,也是它的油耗。有人一天半就用光了每周的额度,然后开始在社区喊话:榜单别光比得分了,也该算算完成同一件事要烧多少 token。
这个呼吁其实很到位。
我们来把账摊开看。K3 的官方 API 定价是每百万 token 输入 3 美元、输出 15 美元,缓存输入 0.3 美元。作为对照,Claude Fable 5 是 10 美元和 50 美元。单看单价,K3 便宜得多。《金融时报》的说法是 K3 运行成本约为 Opus 4.8 的三分之一,Axios 给的口径是便宜约 40%。
但单价便宜,不等于总账便宜。当一个模型每次都要多想几倍、多吐几倍 token,那 15 美元的输出单价乘上去,实际一单的钱未必比看起来省。这就是为什么社区开始呼吁「按任务算总成本」——单 token 的价格战,掩盖不了 token 消耗量这个变量。
自托管也不是省钱按钮。K3 的 Kimi Delta Attention 打破了常规的前缀缓存,月之暗面专门给 vLLM 项目贡献了自研缓存实现才让它跑顺。技术报告里还藏着一个坑:K3 是以「保留思维历史」模式训练的,你的框架必须把完整的前序推理内容和工具调用一起回传,中途丢弃、或者从别的模型切过来,输出就会飘。
一句话,这是一个「Hugging Face + 集群 + 法务」的三重工程,不是一个下载即用的 App。
它到底算不算「开源」
聊到这,绕不开那场最较真的争论:K3 算不算真正的开源?
批评者的理由很硬。K3 没公开训练数据,也没给出完整训练代码,你拿到的是权重、许可证和一份技术报告。而且随权重一起来的那份 Kimi K3 License,不是标准的 MIT,是一份定制协议。
这份协议才是今天最被低估的信息。
它主体部分看着和 MIT 差不多:随便用、随便改、随便分发、随便商用。但营收线以上加了两道闸门。据 Unite.AI 逐条解读、开放模型研究者 Nathan Lambert 也公开印证:其一,你要是把 K3 做成推理或微调服务卖给第三方,且你和关联方连续 12 个月收入超过 2000 万美元,就得跟月之暗面另签协议;其二,月活过亿或月收入超 2000 万美元的商业产品,得在界面显眼处标注「Kimi K3」。纯内部使用,零义务。
看懂了吗?这不是按用户规模切,是按商业模式切。一个在自己机器上微调 K3 的团队,什么都不用管;一个大规模转售 K3 推理的云厂商,得先拿合同。这是中国头部模型公司第一次在开源许可里,把「云厂商搭便车」写成了明码标价的条款。
所以严格讲,英文技术社区划得很清楚:K3 是 open-weight(开放权重),不是 open-source(开源)。中文报道里两个词混用,会直接拖累可信度。
那支持者认这个茬吗?
不太认。他们的逻辑很朴素:能下载、能修改、能自己部署,已经比只能调闭源 API 多了太多自由。对金融、医疗、政企这类数据不能出内网的客户,这几个自由几乎是不可拒绝的。名字叫「开放权重」还是「开源」,不影响他们把数据留在自己机房里这件事。
这场争论谁也说服不了谁。但吵到最后你会发现,名字之争其实是个烟雾弹。真正改变力量对比的,是另一件事。
权重一旦上网,就永远在网上了
这才是 K3 开源最狠、也最容易被忽略的地方。
闭源模型会按厂商的时间表下线,你的工作流跟着一起陪葬。而公开的权重收不回去。就在同一周,据报道,联邦官员曾在亚马逊提出安全担忧后,要求 Anthropic 把最新的 Claude 模型全球下架两周有余。一边是美国监管对本土实验室的空前强度,一边是任何人只要有台服务器就能下载运行 K3,全程不经过任何美国云。
这构成了 2026 年 AI 治理最尴尬的一组对照。
数据更能说明问题。据 byteiota 引述 OpenRouter 的数据,中国开源模型目前已占该多模型 API 网关路由 token 用量的 46.4%,美国模型为 35.7%。这个数字,就是「封禁在技术上还来不来得及」这个问题的量化答案。
华盛顿那边的反应也印证了这一点。白宫科技政策办公室主任公开指控 K3 蒸馏了 Anthropic 的技术,财政部长放话要调查、要制裁。可就在同时,英伟达、微软、Meta 等一批公司联署了公开信《Open Weights and American AI Leadership》,反对全面封杀开源模型——而 OpenAI、Anthropic、Google 三家,恰恰不在首批签署名单上。连指控 K3 蒸馏的那位前白宫顾问 Dean Ball 都承认,K3「是个非常好的模型」,性能没法只用蒸馏来解释。
一个模型强不强,第三方跑一跑就知道。但一个开放权重被下载了多少次、装进了多少台机器,谁也数不清、更收不回。这就是 K3 真正的杠杆。它可能不是地表最强,但它是那个「谁都拦不住」的存在。
该怎么看这场开源
绕了一大圈,回到最开始的问题:Kimi K3 的开源,到底该怎么看?
我的判断是三句话。
它是一次诚实的顶级发布。月之暗面自己承认落后于 Fable 5,第三方给到全球第三,前端登顶是实打实的盲测投票。夸它的人没夸错,泼冷水的人也没说谎——它就是「追得很近但还没超过」的那个状态,这已经足够炸裂。
它的门槛是真的高。1.4TB 权重、64 张加速器、费 token、要法务,橱窗里的 F1 这个比喻不刻薄,是精准。别被「开源免费」四个字骗了,能真正吃到红利的,短期内是有集群、有工程能力的机构,不是你我的游戏本。
而它最深远的影响,不在跑分,在那条收不回的权重。当接近前沿的能力可以被任何人下载、部署、蒸馏成小模型,闭源订阅的溢价逻辑就被撕开了一道口子。「先试开源,不够再补闭源」,正在悄悄变成开发者的默认选项。
至于它算不算「真开源」——说真的,那台已经在无数硬盘里躺着的 2.8 万亿参数模型,根本不在乎你怎么叫它。
橱窗里的 F1 开不回家,但它证明了一件事:这辆车,中国人自己造得出来,还愿意把图纸的大半贴在墙上。剩下的争论,都是后话了。
引用来源
- 硅基见闻《Kimi K3 正式开源!2.8 万亿参数砸向全球》,新浪财经转载,2026 年 7 月 28 日
- Moonshot AI 官方 Kimi K3 模型卡与技术报告,Hugging Face / GitHub,2026 年 7 月 27 日
- ModemGuides《Can You Run Kimi K3 Locally? The Honest Math Now That the Weights Are Out》,2026 年 7 月更新
- Unite.AI《Moonshot Opens Kimi K3 Weights Under a Revenue-Tiered License》
- Artificial Analysis, Intelligence Index 与 Frontend Code Arena 评测数据,2026 年 7 月
- AI 工具宝箱《Kimi K3 开源权重发布:开源大模型四强横评》,2026 年 7 月 19 日
- The Week(转引《金融时报》《CNN》)、Axios 关于 K3 运行成本的报道,2026 年 7 月
- byteiota 引述 OpenRouter 路由用量数据,2026 年 7 月