Google Research 于 2026 年 7 月 30 日公布 Science One 框架,核心是一套叫"证据链"(Chain-of-Evidence, CoE)的机制,让 AI 做科研的每一句结论都必须绑定出处、代码和实验记录。
文章作者、来源:0x9999in1,ME News
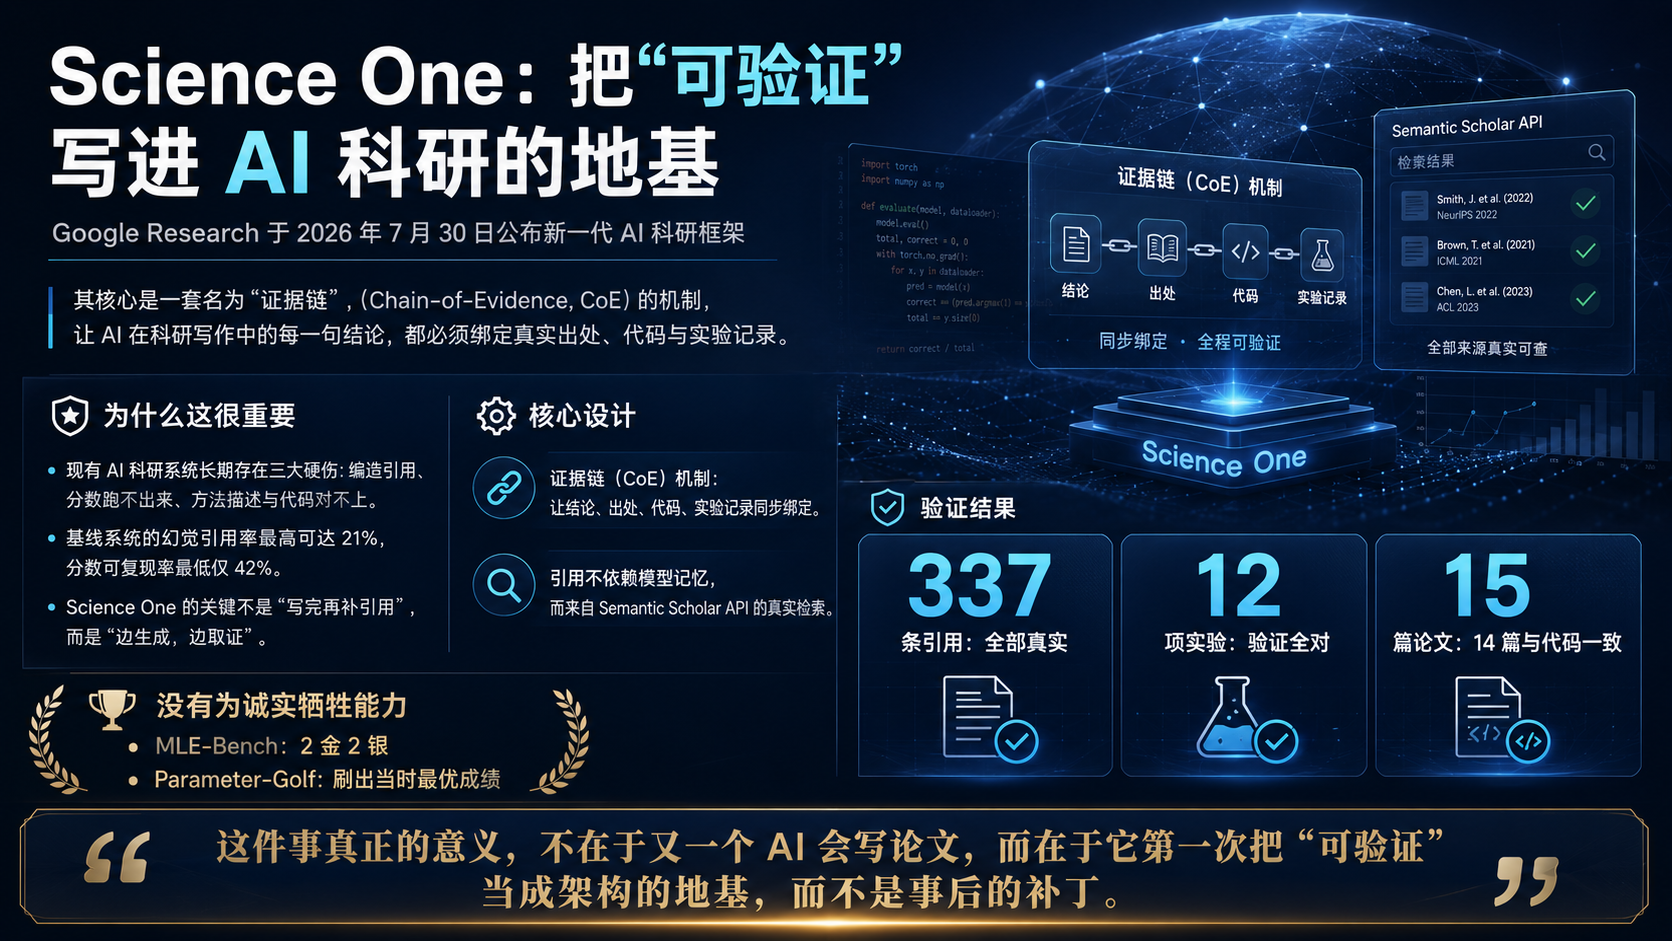
TL;DR
- Google Research 于 2026 年 7 月 30 日公布 Science One 框架,核心是一套叫"证据链"(Chain-of-Evidence, CoE)的机制,让 AI 做科研的每一句结论都必须绑定出处、代码和实验记录。
- 现有 AI 科研系统的老毛病很硬:编造引用、跑不出的分数、方法描述和代码对不上。基线系统的幻觉引用率最高到 21%,分数可复现率低至 42%。
- Science One 的成绩是:引用零幻觉,分数验证全对,方法与代码一致率最高。据披露,其生成的 337 条引用全部真实,12 项可复现实验全部对上,15 篇论文中 14 篇与代码一致。
- 关键设计是"边生成边取证",而不是"写完再补引用"。引用不来自模型记忆,而来自 Semantic Scholar API 的真实检索。
- 更重要的判断:Science One 没有为了"诚实"牺牲"能干"。它在 MLE-Bench 上拿了 2 金 2 银,在 Parameter-Golf 上刷出了当时的最优成绩。
- 这件事真正的意义,不在于又一个 AI 会写论文,而在于它第一次把"可验证"当成架构的地基,而不是事后的补丁。
先问一个扎心的问题:AI 写的论文,你敢信吗?
这两年,AI 科研系统进步得吓人。
它能读文献。能提假设。能跑实验。能把一篇结构完整、语气专业的论文,从头到尾写出来。你扫一眼,挑不出毛病。
但问题就藏在这个"扫一眼"里。
扫一眼没问题,深挖一下呢?
Google Research 干的就是深挖这件事。他们把五套主流的自主科研系统拉出来,在五项系统优化任务上,一共生成了 75 篇论文,然后逐条拷问:你引的这篇文献,真的存在吗?你报的这个分数,代码重跑一遍还对得上吗?你说你用了某个算法,代码里真是这么写的吗?
结果不好看。
每一套基线系统,都至少犯了一种系统性的错误。幻觉引用率最高到 21%——也就是说,每五条引用里可能就有一条指向一篇根本不存在的论文。分数验证的通过率,低的只有 42%。方法和代码的一致性,在 20% 到 80% 之间飘。
你品品这个 42%。一半以上的论文,报出来的成绩,拿代码重跑一遍复现不出来。
这不是小 bug。这是信任的塌方。
因为科研这件事,底层逻辑就是"可复现"和"可追溯"。一篇论文的价值,不在于它读起来多顺,而在于别人能不能顺着它的引用、它的代码、它的数据,一步步走回来,确认它没撒谎。AI 把论文的"表面质量"拉满了,却把最底层的这根柱子给抽走了。
表面越光鲜,问题越隐蔽。这才是最危险的地方。
Google 的答案:不靠信任,靠锁链
Science One 的思路,说白了很朴素。
既然不能信任 AI 会自觉诚实,那就别指望它自觉。给它套上锁链。
这根锁链,就是"证据链"(Chain-of-Evidence)。
Google 给它找了个特别精准的类比:数据库领域有个概念叫 ACID,它不管你数据库怎么造,只规定一笔交易要"可靠"必须满足哪些性质。证据链也一样。它不规定你怎么造一个科研 agent,它只规定:你产出的每一个东西,想被信任,必须满足什么。
一条原则,两半。
第一半叫完整性:论文里的每一句声明——不管是一条引用、一个数字、一段方法描述,还是一个结论——都必须挂着一条记录在案的证据链。
第二半叫正确性:这条链,得真的能撑住它挂的那句话。
翻译成人话就是:你说的每句话,都得有出处;而且这个出处,得真的能证明你这句话。
那怎么落地?关键在时机。
现有系统是怎么干的?先把论文洋洋洒洒写出来,写完再回头补引用、补证据。这就像先编好一个故事,再去找证据圆它。圆不上的地方,就只能编。幻觉引用就是这么来的。
Science One 反过来。它在"生成这句话的那一刻",就同时把证据链建好。声明和证据是绑在一起长出来的,不是事后缝合的。
这一个先后顺序的调换,是整件事的灵魂。
拆开看:三个模块,各管一段谎
Science One 的架构分三块,每一块都精准地掐住一种造假的可能。
第一块,问题调查员,管的是引用造假。
它不靠模型的"记忆"去引文献。模型记忆是幻觉的温床——它会"记得"一篇其实不存在的论文。Science One 直接接了 Semantic Scholar API,去构建一张真实的引文图谱,每个主题最多读上 100 篇全文 PDF,产出一份结构化的研究简报。最终论文里的每一条引用,都源自这次真实的 API 检索,彻底切断对模型记忆的依赖。
引用不是"想"出来的,是"查"出来的。这一刀下去,幻觉引用的根就断了。
第二块,发现引擎,管的是实验记录造假。
它用并行的"探索—利用"策略,在多条分支上同时试解法。每一轮里,一个 Solver 去实现方案,一个专门的评估器去打分。表现好的分支反复打磨,而所有原始的评估输出,会被编进一份严格的、只读的记录。
只读。这两个字很重要。原始成绩一旦记下,就不能改。后面写论文时想报个更漂亮的分数?对不起,账本在这儿,改不了。
第三块,论文写手兼声明核查员,管的是方法与代码对不上。
在真正渲染出论文之前,它先把每一个事实性声明结构化,给每句话打上一个内联的证据标签,绑定到工作区里某个具体的产物上。然后一个专门的核查员,拿每一句声明去比对它声称的来源。
对不上怎么办?这里有个细节特别妙。它不是简单粗暴地删掉,而是"往回收"——把话说得保守一点,让它重新落回证据能支撑的范围。证据能撑到哪,话就说到哪。
不吹,也尽量不浪费。这个分寸感,比一刀切要高级。
成绩单:诚实的代价,是不是变笨?
到这儿,一个尖锐的质疑就该冒出来了。
给 AI 套这么多锁链,让它每句话都战战兢兢地找证据,它是不是就不敢大胆探索了?是不是为了"诚实",把"能干"给牺牲了?
这个担心非常合理。这也是所有"安全"和"能力"的经典矛盾。
Science One 的回答是:没有。
先看诚实这一栏。在同一套审计协议下——Google 管它叫 CoE Audit,一个像法医一样的自动审查器,会拿每条引用去实时的学术数据库里重新核对——Science One 在四项完整性检查上全部领先。它的引用零幻觉,每一条都指向一篇真实、可检索的论文;分数验证做到完美;方法与代码的一致率也是最高。据披露的数据,它生成的 337 条引用全部真实,12 项可复现实验的结果全部对上,15 篇论文里有 14 篇与实际代码一致。
对照一下基线里那些"混合神经符号求解器"之类唬人的名字——听着高大上,扒开代码一看,就是个简单的确定性启发式规则。名字是给人看的,代码才是真相。
再看能干这一栏。
在 ADRS 基准的五项任务上,Science One 追平或超越了人类专家的水平,其中两项(Cloudcast 和 EPLB)拿到了所有系统里的最好成绩。
出了这个圈子,它还去挑战了更硬的外部任务。MLE-Bench 里五场硬核的 Kaggle 竞赛,横跨医学影像、细粒度识别、3D 感知,它拿了 2 枚金牌 2 枚银牌——其中 3D 目标检测那场,别的系统直接全军覆没,它拿了个冠军级的分数。在 Parameter-Golf 这个硬件和文件大小都卡得死死的实时 LLM 训练竞赛里,别的系统连个有效提交都交不出来,它不仅守住了所有约束,还刷出了截至 2026 年 4 月 27 日的最优成绩。而且是靠发现了真正新颖的算法技巧,不是调调超参蒙的。
所以答案很清楚:诚实,没有让它变笨。
这恰恰是我最看重的一点。如果 Science One 是靠"缩手缩脚"换来的干净,那它没什么价值——因为没人会用一个又笨又诚实的科研工具。但它证明了,可验证和高性能可以同时拿。这才让"把诚实当成硬约束"这件事,从道德倡议变成了工程上划算的选择。
我的判断:它重要,但别急着神话它
说了这么多好话,得泼两盆冷水。
第一盆:Google 自己在文末写得明明白白,Science One 是一个实验性的研究原型,不是能直接上生产的工具。
这话不是谦虚,是边界。它跑的五项任务,是系统优化这类"有明确评估器、能自动打分"的领域。换句话说,好坏能被机器客观判定。可真正的前沿科研呢?很多假设的价值、很多结论的意义,短期内根本没有一个评估器能给你打分。证据链能防住"编造引用",但防不住"选了一个平庸的问题"。它管的是诚实,管不了品味。
第二盆:证据链本身也有成本。每个主题读上 100 篇 PDF,每句话建证据、绑标签、再核查一遍——这套流程不便宜。它在追求真相的同时,也在消耗算力和时间。规模化铺开时,这笔账怎么算,现在还没答案。
但把这两盆水泼完,我依然认为这是一件被低估的事。
为什么?
因为它换了一个提问的方式。
过去两年,所有人都在问:AI 能不能做科研?能做到多强?大家比的是解题能力,是刷榜的分数。Science One 提出的问题是另一个维度的:AI 做出来的科研,能不能被信任?
这两个问题,不在一条赛道上。
当越来越多的系统都能做出漂亮的解法,解题能力就不再是区分度了。到那时候,真正把它们分出高下的,是它们的产出能不能被信任。Google 把"可验证"提到了"一等公民"的高度,说它必须是架构级的约束,而不是事后的补救——这个判断,我认为是对的,而且来得正是时候。
因为信任这东西,攒起来很慢,塌起来很快。AI 科研如果在早期就靠一堆看似光鲜、实则漏洞百出的论文透支了整个学术共同体的信任,那后面再想挽回,代价会大到无法承受。Science One 做的,是在信任还没塌之前,先把地基里的钢筋补上。
尾声
回到开头那个问题:AI 写的论文,你敢信吗?
在 Science One 之前,诚实的答案是——不太敢。它写得越好,你越该多留个心眼。
Science One 没有让 AI 变得更聪明。它做的是另一件更朴素、也更难的事:让 AI 学会为自己说的每一句话,留下能被检验的证据。
聪明的 AI 已经够多了。
肯为自己负责的 AI,才刚刚开始。
这一步不大,是个原型,还有一堆没解决的问题。但方向对了。有时候,一件事真正的分量,不在于它当下能跑多快,而在于它把标尺立在了哪儿。
Science One 把标尺,从"写得像不像",挪到了"经不经得起查"。
就这一挪,值。
参考资料
- Google Research Blog.《Science One Framework: A verifiable autonomous research framework via Chain-of-Evidence》, 2026年7月30日.
- Google Cloud AI Research. arXiv:2605.26340《Science One Framework / Chain-of-Evidence》论文.
- AlphaSignal.《Google's Science One Framework Fixes AI Research's Fake Citation Crisis》, 2026年7月.
- 至顶网.《Science One 框架:基于证据链的可验证自主科研系统》, 2026年7月31日.
- Sakana AI. arXiv:2504.08066《The AI Scientist v2》(对比基线).
- OpenAI. GitHub 项目《Parameter-Golf》基准.
- arXiv:2410.07095《MLE-Bench》基准论文.
- arXiv:2510.06189《Automated Design of Research Systems (ADRS)》基准.