真正的问题从来不是"AI需求会不会缩水",而是"价值最终沉在供应链的哪一层"。
文章作者、来源:0x9999in1,ME News
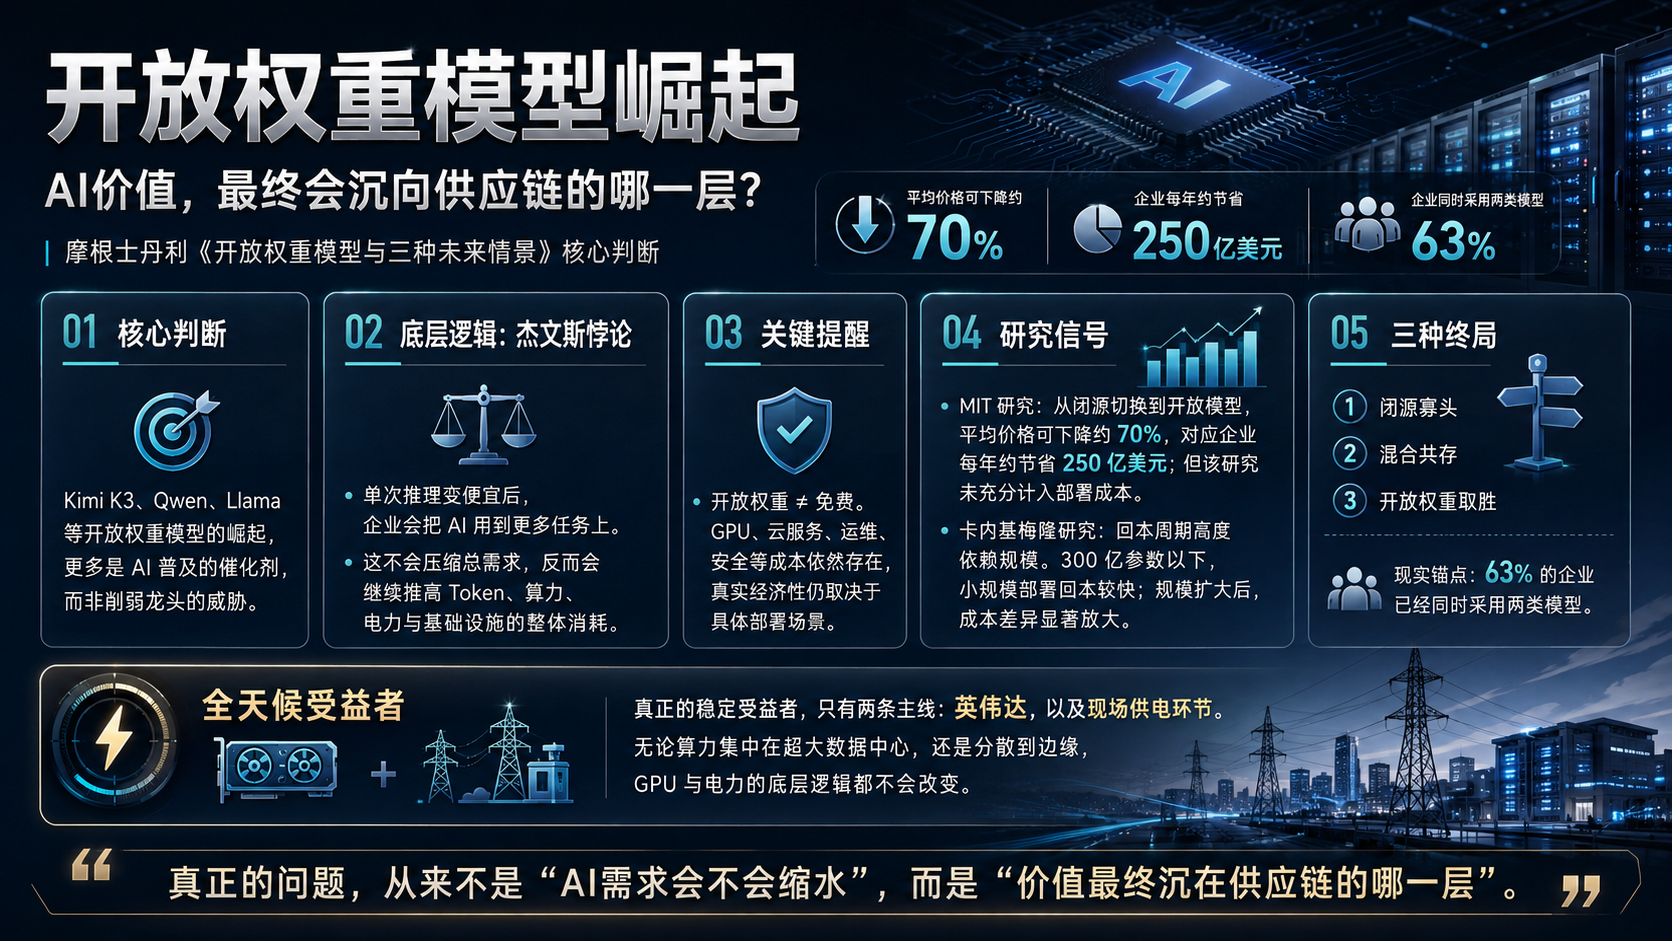
TL;DR
- 摩根士丹利在《开放权重模型与三种未来情景》中给出核心判断:Kimi K3、Qwen、Llama 这类开放权重模型的兴起,是加速AI普及的催化剂,不是削弱龙头的威胁。
- 论据是杰文斯悖论——单次推理变便宜之后,企业会把AI用到更多任务上,Token、算力、电力、基础设施的总需求反而被推高。
- 大摩明确提醒:开放权重不等于免费。GPU、云服务、运维、安全的成本还在,真实经济性取决于场景。
- 引用的MIT研究显示,从闭源切到开放模型可让平均价格下降约70%,对应企业每年约250亿美元的节省;但该研究完成于2025年12月,未充分计入部署成本。
- 卡内基梅隆的研究更冷静:回本周期高度依赖规模,300亿参数以下的小规模部署回本可以很快,规模上去之后差异巨大。
- 三种终局:闭源寡头、混合共存、开放权重取胜。现实锚点是63%的企业已经同时在用两类模型。
- 全天候受益者只有两条线:英伟达,以及现场供电环节。理由不是站队,而是无论算力集中在超大数据中心还是散到边缘,GPU与电力的底层逻辑都不变。
- 真正的问题从来不是"AI需求会不会缩水",而是"价值最终沉在供应链的哪一层"。
一、市场读错了什么
2026年7月中,Kimi K3 发布。费城半导体指数应声下跌,英伟达、美光、SK海力士,连Cadence这类EDA公司都跟着一起挨了一刀。
熟悉吗?太熟悉了。
一年多前DeepSeek那一波,市场的条件反射是一样的:开源模型越强,算力就越不值钱。逻辑听起来很顺——既然一个开放权重的模型能追平第一梯队,那闭源的溢价就没了;既然效率提上来了,那堆卡的必要性就下去了。于是卖芯片、卖设备、卖电力,一条链子往下砍。
摩根士丹利在8月4日的这份报告里,把这个反射弧直接称为误读。
误读在哪?在于市场把"单位成本下降"直接等价成了"总支出下降"。
这中间隔着一个巨大的变量:用量。
大摩搬出了杰文斯悖论。19世纪的经济学家杰文斯观察到一件反直觉的事:蒸汽机效率提升、烧同样的煤能干更多活之后,英国的煤炭消耗量没有下降,反而暴涨。因为便宜了,所以用得起了;因为用得起了,所以到处都在用。
放到AI上:单次推理从一分钱降到一毛钱的十分之一,企业不会把省下的钱揣进兜里。企业会把AI塞进原本"算不过账"的那些环节——客服工单的全量复核、代码库的持续扫描、合同的逐条比对、每一封邮件的自动分类。这些活以前不做,不是不想做,是贵得不划算。
价格一旦跌破那条线,需求不是线性增长,是塌陷式涌入。
二、"开放权重"到底开放了什么
这里必须先把概念掰清楚,因为市场的混乱一半来自术语的混乱。
大摩在报告里做了一个不算新鲜但很必要的区分:开放权重 ≠ 开源。
严格定义的开放权重模型——Meta 的 Llama、谷歌的 Gemma,以及 Qwen、DeepSeek、Kimi——公开的是训练好的参数。你能下载,能微调,能自己部署。但训练数据可能不公开,许可协议可能有限制。
真正的开源,是整套技术栈都摊在桌面上:代码、训练方法、数据细节。报告举的例子是 AI2 的 OLMo。这个圈子比大家想象的小得多。
所以更准确的说法是:开放权重和闭源的核心差别,不在参数规模,也不在某个榜单上谁高谁低,而在获取方式和付费方式。
开放权重:通常免费拿到权重,支持微调,部署方式灵活——本地、私有云、公有云、API,随你。
闭源:许可证 + Token 计费,所有用户拿到的是同一套权重,你改不了,也看不见。
大摩还说了一句挺实在的话:今天性能最强的前沿模型,基本还是闭源的。原因很朴素——训练成本高到离谱,在下一代模型出来之前,没人会把上一代白送。
这句话值得多读一遍。它意味着开放权重的追赶,本质上是一场有时滞的追赶。差距会缩小,但结构性的时间差不容易消失。
三、免费的最贵:那些没写在标价牌上的成本
报告里最有价值的一段,恰恰是给开放权重降温的那一段。
大摩引用了MIT的研究:从闭源切换到开放模型,平均价格能下降约70%,折算成企业端的节省,大约是每年250亿美元。
数字很漂亮。但大摩紧接着补了一刀——这份研究完成于2025年12月,没有充分计入部署成本。
什么是部署成本?GPU得自己买或者自己租,集群得有人运维,模型得有人微调,安全和合规得有人兜底。开放权重给你的是一辆车的图纸和零件,不是一辆能直接开走的车。
卡内基梅隆大学的研究把这件事量化得更狠:回本周期高度依赖部署规模。300亿参数以下的小规模部署,回本可以很快;规模一旦往上抬,账就完全是另一副样子了。
这是一个很少被讨论但极其关键的现实:开放权重的经济性不是一条平滑曲线,而是一个分段函数。
小场景、高频次、任务明确——开放权重香得不行。
复杂推理、长程Agent、需要极致可靠性——闭源的钱不是白花的。
再往前一步看 Kimi K3 这类超大 MoE 架构。它即使只激活少量专家,庞大的权重也仍然要分布在高容量内存和高速互连的集群里。所谓"开放",开放的是权重的所有权,不是对硬件门槛的豁免。
换句话说,开放权重把算力需求从少数闭源实验室扩散到了云服务商、主权云、企业自建机房。总量没减,只是换了主人。
这才是市场在7月那一跌里没算清的账。
四、三种终局,价值往哪儿沉
大摩没有押单一结论,而是给了三个情景。这种写法本身就是一个判断:没人知道终局,但每种终局的受益结构是可以提前画出来的。
情景一:闭源寡头胜出
假设前沿模型的性能难以复制。工作负载继续保持高算力密度,继续向超大规模云集中。Token 价格还是会跌,但跌得慢——因为寡头结构本身维持了定价纪律。
受益方:云厂商、安全软件、光网络、半导体、电力供应链。
报告在这里点了一个具体变量:谷歌。如果 Gemini 4 实现突破、重回前沿,谷歌用自家基础设施跑模型API的投资回报率大约能到45%。如果没能领跑前沿,谷歌就更像一个基础设施提供商,对应的ROI约30%。
十五个百分点的差距,就压在一代模型上。这就是前沿竞赛的赔率。
情景二:混合格局
没有单一架构通吃。闭源前沿模型主导复杂推理和AI Agent任务,开放权重承接高频、成本敏感、垂直专用的需求。
工作负载横跨公有云、私有云、本地、边缘。于是——模型编排、路由、评估、治理这些"中间层"软件,成了价值向上迁移的关键。安全软件的需求随着负载分散而扩张。
这个情景有一个非常硬的现实支撑:目前已有63%的企业同时在使用开放权重和闭源两类模型。
这个数字很说明问题。企业的选择不是"信仰哪一派",而是"哪个任务用哪个更便宜更稳"。这是采购行为,不是路线斗争。
情景三:开放权重取胜
开放权重性能逐步收敛到前沿水平,基础模型的智能变成广泛可得的东西。模型API价格显著下跌,企业采用出现一波浪潮。
AI基础设施走向去中心化:私有数据中心、主权云、本地部署、边缘设备的需求大幅增加。创新的重心从预训练转移到微调、推理优化、Agent和具体应用落地。
在这个情景里,安全软件是最大赢家之一。也很好理解——权重能自由流动的世界,攻击面是几何级扩张的。
个股层面的分化很有意思:AVGO 在闭源情景下可能是最大单一受益者;DELL、HPE 这类本地基础设施厂商,以及苹果这类边缘设备厂商,在开放情景下更容易释放价值。云厂商则要看负载最终流向哪里——如果开放情景成立,微软凭混合云和本地部署能力优势更清晰,亚马逊和谷歌在该情景中的位置会被下调为"其他受益者"。
五、全天候受益者:为什么是英伟达和电
三种情景推演完,大摩挑出了两条穿越所有情景的线。
第一条是英伟达。
逻辑不复杂,但很扎实:无论算力是集中在超大规模数据中心,还是分散到企业机房和边缘,GPU需求的底层逻辑都没有变化。
集中,是几家买巨量;分散,是几万家买少量。总量不减,甚至因为普及面扩大而更大。
值得注意的是,大摩近期还上调了AI集群的成本估算——英伟达 Vera Rubin 系统的定价被摆到了每吉瓦约490亿美元,比此前预测高出近20%。
这个数字放在这里就有点微妙了。一边是模型变便宜,一边是单位算力的资本开支在涨。两者并不矛盾:推理端的边际成本在跌,训练与部署端的固定资产投入在涨。前者驱动需求扩张,后者决定谁有资格参与供给。
第二条是现场供电(on-site power)。
理由是电力需求曲线同时覆盖"集中式"和"分布式"两种配置。无论负载怎么排布,AI扩张意味着耗电量和供电能力必须同步抬升。
电这件事,是整个AI叙事里最不讲情面的约束。模型可以开源,权重可以下载,芯片可以替代,但电不能开源。一个吉瓦就是一个吉瓦,谁也变不出来。
这可能是三种情景里最确定的一条线。确定到有点无聊。
六、这份报告的真正价值不是结论,是框架
说点自己的看法。
大摩这份报告如果只看那个标题——"开放权重加速普及而非削弱龙头"——很容易被当成一句安抚市场的话。但真正有份量的,是它把问题换了个问法。
市场原本的问题是:AI需求会不会因为效率提升而缩水?
大摩的问法是:AI需求肯定不缩水,问题是价值最终沉在供应链的哪一层——算力、云、软件编排与治理,还是本地与边缘的分布式基础设施?
这两个问法的差别,是熊市思维和结构思维的差别。
我认为大摩的方向是对的,但有两个地方值得保持警惕。
第一,杰文斯悖论不是自动生效的。
杰文斯效应成立有前提:需求要有足够的弹性空间。煤炭之所以越省越多,是因为19世纪的英国到处都有还没被机械化的产业。AI的情况类似但不完全一样——企业能塞进AI的场景确实很多,但塞进去之后能不能产生可衡量的回报,是另一件事。
如果大量企业只是把AI用在了"看起来很忙但说不清收益"的地方,那需求的扩张会有一个天花板,而且这个天花板会在某个季度突然出现。杰文斯悖论描述的是能量转换效率,不保证转换出来的是价值。
第二,"英伟达全天候受益"这个结论,正确得有点太舒服了。
它在逻辑上很难挑错——GPU需求不因架构路线改变。但正确的判断和好的投资判断之间,隔着价格。市场是不是已经把这个"全天候"预期充分定价了,报告没有回答,也不该由报告回答。
一个逻辑上无懈可击的多头论据,往往是拥挤交易的温床。这话不是唱反调,是提醒:结论的确定性,不等于赔率的吸引力。
七、对企业来说,这件事其实更简单
抛开二级市场的估值游戏,站在企业采购的角度看,这份报告的启示反而朴素得多。
63%的企业两头都用,这个数字已经把答案说完了:不要选边,要选场景。
高频、可预测、数据敏感、任务边界清楚的活——开放权重自建,能省下的钱是真金白银,尤其在300亿参数这个量级以下,回本周期短得让人心动。
复杂推理、长程Agent、需要持续跟随前沿能力升级的活——闭源API,为可靠性和迭代速度付费,不丢人。
真正需要投入的,其实是夹在中间那一层:编排、路由、评估、治理。你怎么判断一个请求该走哪条路?你怎么保证换了模型之后输出质量不塌?你怎么在权重可以随便下载的世界里管住数据边界?
大摩把这一层列为混合情景下的核心受益方,我觉得这判断比任何个股推荐都更实用。因为这一层是企业自己必须建的能力,买不来。
顺便说一句安全。开放权重让模型部署去中心化,也让攻击面去中心化。以前你只需要管好几个API密钥,现在你要管好一堆本地跑着的权重文件、微调数据、推理端点。安全软件在三种情景里都被点名,不是巧合。
八、收尾
Kimi K3 发布那天,半导体股集体跳水。今天回头看,那更像市场的一次肌肉记忆,而不是一次思考。
开放权重不是掀桌子的人。它是把桌子加长的人。
桌子加长之后,原来坐主位的会不会被挤下去?可能会,但不是因为开放权重本身,而是因为它自己没能守住前沿。这是两件事。
大摩这份报告最诚实的地方,是它没有告诉你终局是什么,只告诉你每一种终局里,谁的位置不会动。
英伟达,和电。
前者是共识,后者是物理。
至于中间那些跟着涨跌、跟着换阵营、跟着重新定价的公司——它们的命运高度依赖情景。这句话听起来像废话,但在一个人人都想要确定答案的市场里,承认"这取决于情景",反倒是最贵的一种诚实。
模型会一代代便宜下去,这是趋势,挡不住。
算力会一层层散出去,这也是趋势,挡不住。
但便宜和分散加起来,从来不等于萎缩。
杰文斯在1865年就看明白了这件事。一百六十年过去,人类还在为同一个直觉误区付学费。
真是有意思。
引用来源
- Morgan Stanley, *Open-Weight Models and Three Future Scenarios*(研究报告),2026年8月
- 格隆汇 / 新浪财经:《大摩:开放权重模型降低AI成本 "杰文斯悖论"或令算力需求持续增长》,2026年8月4日
- BigGo Finance: *Open-Weight Models to Accelerate AI Adoption: Morgan Stanley Outlines Three Scenarios, Names Nvidia and Power Chain as Beneficiaries*, 2026年8月4日
- 火星财经:《摩根士丹利:开放权重AI模型兴起将通过降低成本加速AI普及》,2026年8月4日
- Blockspace Media: *Morgan Stanley says open-weight AI could expand compute and power demand*, 2026年8月
- MIT 关于开放模型与闭源模型价格差异的研究(完成于2025年12月,经大摩报告引用)
- Carnegie Mellon University 关于开放模型部署回本周期与规模关系的研究(经大摩报告引用)
- Morgan Stanley Insights: *Opportunities in AI Infrastructure*(含 Vera Rubin 系统每吉瓦成本估算上调)