张一鸣近期要求团队避免依赖竞争对手模型蒸馏,哪怕接受短期落后。这个选择会牺牲短期追赶速度,却逼着Seed建立自己的数据和训练闭环。
文章作者、来源:0x9999in1,ME News
TL;DR
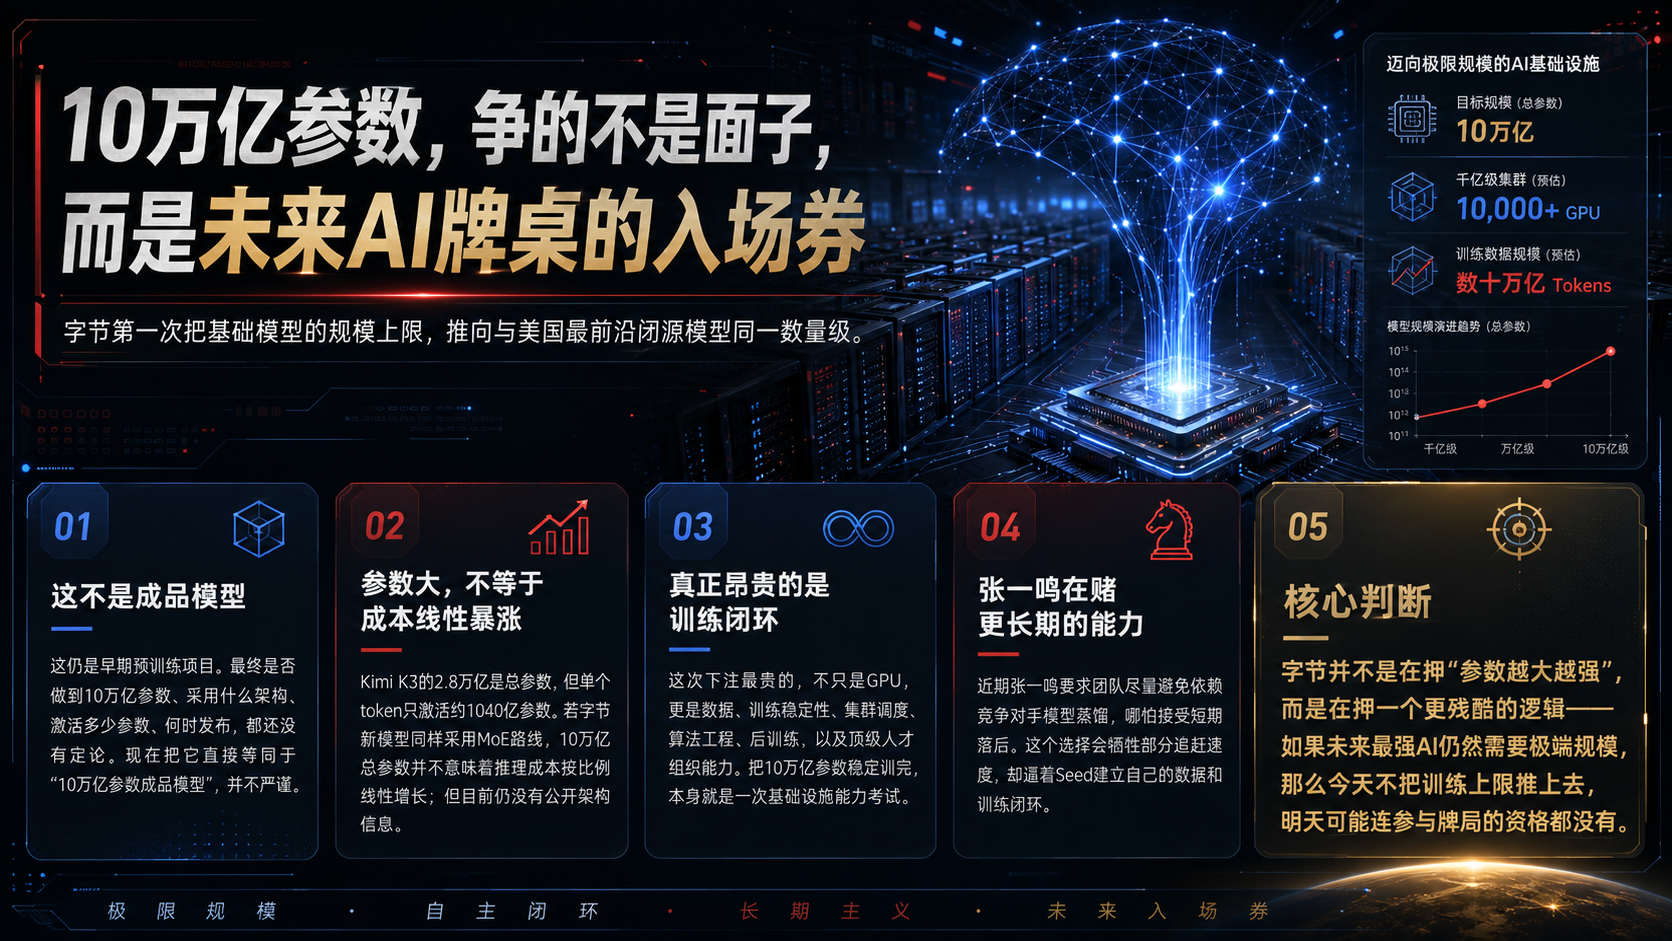
- 最高10万亿参数的意义,不是“比谁模型更大”,而是字节第一次把基础模型的规模上限推到美国最前沿闭源模型的同一数量级。
- 这仍是早期预训练项目,最终是否做到10万亿参数、采用什么架构、激活多少参数、何时发布,都没有确定答案。现在把它直接等同于“10万亿参数成品模型”并不严谨。
- Kimi K3的2.8万亿是总参数,但单个token只激活约1040亿参数。字节新模型若同样采用MoE路线,10万亿总参数并不意味着推理成本线性增长;但目前没有公开架构信息。
- 这次下注真正昂贵的地方,不只是GPU,而是数据、训练稳定性、集群调度、算法工程、后训练和人才组织。把10万亿参数稳定训完,本身就是一次基础设施能力考试。
- 张一鸣近期要求团队避免依赖竞争对手模型蒸馏,哪怕接受短期落后。这个选择会牺牲短期追赶速度,却逼着Seed建立自己的数据和训练闭环。
- 我的判断是:字节并不是在押“参数越大越强”,而是在押一个更残酷的逻辑——如果未来最强AI仍然需要极端规模,那么今天不把训练上限推上去,明天可能连参与牌局的资格都没有。
一、10万亿不是一个数字,是一次身份转换
先把最容易让人兴奋的部分压住。
《金融时报》8月7日报道,字节跳动正在预训练一款最高可能达到10万亿参数的模型,项目仍在早期,最终规模尚未敲定。按照报道引用的行业估算,Anthropic的Mythos 5约为8万亿参数、Fable 5约为5万亿;但Anthropic自己并未公开确认这两个模型的参数规模。
所以,“10万亿对8万亿”最多只能看成一个数量级上的比较,绝不能当作严格的工程对标,更不能据此宣布谁已经超过谁。
但即便把所有宣传性的解读都拿掉,这个数字仍然足够重。
因为中国此前公开模型的参数规模天花板,刚刚被Kimi K3推到2.8万亿。Kimi K3已经是一台极其庞大的机器:896个路由专家,每个token选择其中16个,总参数2.8万亿,但实际激活参数约1040亿。它已经证明,中国团队可以把数万亿级MoE模型真正训练出来、发布出来,并开放权重。
字节现在要做的,是把总规模上限再往前推三倍以上。
这意味着什么?
不是“字节模型一定比Kimi强三倍”。参数从来不是智商刻度。
真正的变化,是字节终于不再只以“中国最好之一”为参照物,而是直接把自己的工程目标对准全球最前沿闭源实验室的规模区间。
过去几年,中国大模型最有杀伤力的故事,往往是“更便宜”“更高效”“更开放”。DeepSeek把效率打成了全球议题,Kimi K3又把开放权重模型推到了2.8万亿参数。
现在字节补上了另一块拼图:
如果效率路线之外,前沿能力最终仍然需要更大的容量、更复杂的专家系统、更庞大的数据和更长时间的训练,中国有没有公司敢把算力和组织直接压上去?
字节的答案显然是:有。
而且它想亲自做那个最贵的实验。
二、为什么是字节?因为它手里恰好有三张别人很难同时拥有的牌
第一张牌,是钱。
字节不是一家靠下一轮融资决定GPU还能不能继续租的AI实验室。
Bloomberg今年5月报道称,字节内部讨论过将2026年资本开支提高到最高约700亿美元,主要用于数据中心和AI基础设施;报道同时称,公司2025年利润约500亿美元。需要强调的是,这些数字并非字节公开财报数据,资本开支计划也仍可能调整。
但它至少说明了一个现实:在中国互联网公司里,字节是极少数有能力把大模型研发变成长期资本开支问题,而不是单个项目预算问题的公司。
训练10万亿参数模型最可怕的,从来不是某一张GPU采购单,而是连续几个月不能停的系统性烧钱。
模型训练中途发生通信故障、数据污染、loss异常、专家负载失衡,任何一个问题,都可能让庞大的加速卡集群把钱烧在空气里。规模越大,很多工程问题就越容易被放大。
能不能把这种模型训出来,考验的不只是算法团队够不够聪明,更考验一家公司有没有承担大规模失败实验的财务耐力。
第二张牌,是用户。
《金融时报》称,豆包目前月活跃用户约3.24亿。
这个数字的战略意义经常被低估。
很多实验室拥有模型,却没有足够大的真实用户场;很多互联网平台拥有用户,却没有最前沿的基础模型能力。字节恰好站在两条曲线的交叉点上。
大模型到了2026年,竞争越来越不像“做一个聊天机器人”,而更像建立一个持续发现真实任务、观察失败、改进模型、再回到产品的闭环。
搜索、写作、代码、图片、视频、Agent、推荐、电商,每一种真实行为,都可能成为产品设计和模型评估体系的一部分。Seed2.0的官方模型卡也已经把重点放在复杂真实任务、长尾知识、复杂指令和Agent能力上,而不只是传统静态榜单。
这就意味着,字节的巨型模型不是实验室里孤零零的一头巨兽。
它背后有可能直接接上豆包、抖音、剪映、火山引擎,以及字节庞大的内容和商业生态。
第三张牌,是字节已经在多模态上证明过自己不是“只会做App”。
今年发布的Seedance 2.0已经把文本、图像、音频、视频等输入整合进统一的多模态音视频生成体系;Seed2.0则继续强调真实世界复杂任务。
把这些进展放在一起看,字节的路线其实越来越清楚:
它不是只想做一个更会答题的语言模型。
它想把语言、视觉、视频、工具调用和Agent逐渐塞进一个更大的智能体系。
10万亿参数,是这条路线迄今最激进的一次扩容。
三、但别被10万亿迷住:它可能是里程碑,也可能是世界上最昂贵的错觉
必须泼一盆冷水。
模型参数越大,能力就一定越强吗?
当然不是。
2022年的Chinchilla研究早已指出一个后来被行业反复验证的事实:模型尺寸、训练数据量和计算预算必须形成合理匹配。一个巨大的模型如果没有得到充分训练,本质上只是一个“没吃饱的巨人”。
进入MoE时代以后,这件事反而更复杂了。
总参数、激活参数、训练计算量、显存需求和推理成本之间,早已经不能简单画等号。
Kimi K3就是最直接的例子。
它有2.8万亿总参数,但每个token只激活约1040亿。总参数更像一个巨大的“能力仓库”,真正每次参与计算的只是其中一部分。
所以,当我们看到字节“最高10万亿参数”时,至少有四个真正重要的问题目前没有公开答案:
它是不是MoE?
每个token到底激活多少参数?
预训练用了多少token,高质量数据占比和合成数据策略如何?
后训练阶段又会投入多大规模的强化学习、Agent环境和推理时计算?
任何一个问题,都可能比“10万亿”本身更决定最终能力。
这也是为什么用参数规模直接比较Mythos、Fable、Kimi和字节新模型,实际上非常危险。
10万亿总参数的MoE,与10万亿全激活参数的模型,根本不是一个概念;不同训练数据、不同路由机制、不同后训练方案之间,也不存在简单的参数换算关系。
更现实的风险,则来自算力。
今年7月,美国官员表示,英伟达H200对华出货已经开始,但实际数量仍然“非常少”;此前也有报道称,中国计划只允许部分头部AI公司有限采购H200。
我们不知道字节正在训练的这款模型到底使用什么芯片、位于什么地区的集群,也不能因为上述信息就推断它依赖H200。
但外部约束非常清楚:
中国团队在追逐全球最大模型的同时,仍然处在最先进计算资源供应不够稳定、政策环境可能快速变化的现实之中。
这形成了一个非常尖锐的反差——模型目标越来越大,最先进算力却未必能够像美国头部实验室那样稳定获得。
因此,10万亿参数如果最终跑通,价值绝不只是最后那个模型文件。
训练过程中被迫解决的集群通信、容错、专家并行、数据吞吐、检查点恢复、训练稳定性和效率问题,本身都会沉淀成下一次训练的基础设施。
换句话说,哪怕最后模型没有拿到世界第一,只要这次训练把字节的“工业化造模型能力”推高了一个台阶,这笔钱就不能简单算成白烧。
当然,反过来也成立。
如果模型规模涨了三倍,能力只增加一点点,甚至很快被更小、更高效的新架构追上,那么10万亿也可能变成一堂极其昂贵的资本纪律课。
这场实验,没有便宜的结局。
四、不蒸馏,才是这场豪赌最狠的一刀
真正让我觉得这次字节变了的,不只是10万亿,而是张一鸣最近对蒸馏的态度。
路透社8月6日援引《澎湃新闻》报道称,张一鸣要求团队避免依赖竞争对手模型进行蒸馏,即使这意味着牺牲短期表现。
先把概念说清楚。
蒸馏本身是一种非常正常的机器学习技术。它可以把大模型能力迁移到更小、更便宜的模型中,也被大量用于推理效率优化。
真正敏感的,是把竞争对手的前沿模型当作“老师”,通过大量输出快速缩短能力差距。
为什么张一鸣宁可慢一点?
因为如果你的能力进步高度依赖别人的模型输出,你很容易获得一条非常漂亮的短期增长曲线,却很难真正获得属于自己的技术上限。
老师走到哪里,你就追到哪里。
更麻烦的是,一旦最前沿模型减少高质量输出、增强反蒸馏机制,或者整个行业突然进入新的模型范式,追随者就会发现,自己缺的并不是更多“答案”,而是独立探索未知区域的方法。
所以,“不依赖对手蒸馏”和“最高10万亿参数”放在一起看,整个故事就变了。
一边主动切掉最快的追赶捷径,一边把预训练规模推到此前从未到过的位置。
这个组合非常残酷。
短期榜单可能更难看,试错成本更高,训练周期更长,内部压力更大。
但如果成功,字节得到的不只是一个模型。
它会得到一套不需要别人当老师的能力生产线。
这才是张一鸣真正想买的东西。
他不是在买10万亿参数。
他是在买Seed独立进入世界第一梯队的可能性。
五、字节真正害怕的,可能不是输给DeepSeek,而是再次错过“基础层”
为什么一家靠推荐算法、短视频和广告做到全球巨头的公司,会突然如此执着于基础模型?
因为字节比很多公司更清楚,平台时代最危险的事情,不是某一个产品落后,而是底层范式已经换了,你却仍然只是上层应用。
移动互联网时代,字节最大的成功之一,就是没有依赖传统门户和搜索入口,而是用算法推荐重新定义内容分发。
它掌握的是用户时间的入口。
但生成式AI正在重新改写“入口”本身。
未来用户未必先打开一个App,再点击十次完成任务。
Agent可能直接理解意图、寻找信息、调用工具、生成内容、操作软件甚至完成交易。谁掌握最强的基础模型,谁就有机会成为新的任务分发层。
如果这个判断成立,那么豆包月活再高也不够。
因为一个拥有数亿用户、但底层智能长期落后一代的平台,最终仍然可能被更强的模型重新定义交互方式。
这就是10万亿参数下注真正的商业含义:
字节要确保自己不仅拥有“流量入口”,还拥有“智能入口”。
这也是为什么AI战役越来越像云计算时代资本竞赛的极端版本。
数据中心、芯片、网络、电力、模型、Agent平台和应用分发正在被绑成一个整体。
过去互联网公司可以把服务器主要视为成本中心;到了今天,算力越来越像决定产品能力上限的生产资料。
字节敢做这种下注,是因为它已经有产品、有用户、有商业化,也有足够强的财务能力承受研发失败。
但它同样没有退路。
如果10万亿参数最终证明规模红利仍然存在,而字节提前建立了巨型模型训练能力,它就有机会成为中国最接近美国前沿实验室的玩家之一。
如果规模红利迅速衰减,真正的突破来自更高效的新架构,那么这次训练至少也会逼着字节把基础设施、数据工程和研究组织磨到极限。
前提只有一个:
它得足够快地承认错误,而不是被“已经投入这么多”绑架。
这恰恰是大型科技公司最难的地方。
敢烧钱其实没有那么稀缺。
烧了很多钱以后,仍然敢推翻自己,才稀缺。
六、真正值得争的,不是“模型最大”,而是谁能把巨大模型变成便宜产品
再往前看一步,字节真正面对的还有第二场战争。
假设10万亿参数最终真的训练成功,而且效果很好,然后呢?
如果一次调用贵得离谱,如果推理速度无法进入真实产品,如果Agent连续工作半小时就让成本失控,如果3亿用户稍微多用几次就把GPU集群打满,那么这个模型依旧不具备真正的商业统治力。
这也是今天AI竞争最有意思的矛盾:
训练端在拼命做大,产品端却必须拼命做小。
最强模型负责打开能力上限,更小的模型、蒸馏模型、量化模型、缓存、路由系统负责把能力压到用户付得起的价格。
所以,张一鸣反对依赖竞争对手蒸馏,绝不意味着字节从此不需要蒸馏技术。更合理的理解是:前沿能力不能靠蒸馏别人获得,但自己的旗舰模型一旦足够强,就可以反过来成为整个字节模型家族的“老师”。
这才形成真正完整的模型经济。
最贵的模型负责探索边界,中型模型负责复杂任务,小模型负责高频场景;火山引擎承担企业调用,豆包承担消费者入口,剪映、抖音以及各种Agent产品继续消化能力。
如果这个飞轮建立起来,那么10万亿模型甚至不需要被绝大多数普通用户直接调用。
它只需要足够强。
因为它的价值,可以沿着整个模型体系向下传递。
这也是字节和纯AI实验室最大的区别之一。
实验室必须想办法把模型变成收入。
字节已经拥有庞大的应用和商业体系,它需要解决的是另一件事——怎样把自己的应用体系变成模型能力的放大器。
一旦做到这一点,模型研发、用户数据、产品分发和商业化之间就能形成一个非常难复制的闭环。
这才是真正值得其他中国AI公司警惕的地方。
不是字节做出了一个10万亿参数模型。
而是如果它真的做出一个世界级模型,它已经准备好了数亿用户去接住它。
七、结尾:10万亿参数不是胜利,它只是字节终于把自己放进了最危险的赛道
今天讨论这款模型,最容易犯两个错误。
第一个错误,是看到10万亿,就宣布“字节超过Anthropic”或者“中国模型已经领先美国”。
没有依据。
模型还在预训练,最终参数没有确定,更没有公开评测。Anthropic自身也没有确认Mythos 5和Fable 5的参数规模。参数数量更不是能力排行榜。
第二个错误,是走到另一个极端,认为“参数已经不重要,大模型以后只看算法”。
这同样过于轻松。
过去几年最前沿能力的提升,从来不是一个变量的胜利,而是规模、数据、架构、后训练、推理时计算和基础设施共同向前推进的结果。
至少截至2026年8月7日,没有足够事实证明极端规模已经失去价值。
所以,我更愿意把字节这次下注理解成一种战略保险。
它赌的是:
如果前沿智能仍然需要极端规模,我不能缺席。
如果未来突然转向更高效的新架构,我也要先拥有训练极端规模模型的工程能力,才更有资格去优化它、替代它。
这是字节目前最激进的一次模型下注,也是一次非常典型的张一鸣式下注——不满足于把产品做得更热闹,而是试图把决定产品上限的底层能力抓到自己手里。
10万亿参数不会自动带来世界第一。
它甚至可能失败。
可能训练规模最终被下调,可能收益不及预期,可能几个月之后行业又出现新的架构,把今天看起来惊人的参数规模迅速变成旧时代的数字。
但它释放出的信号已经非常清楚:
字节不想再仅仅用“离第一名还有多远”来衡量Seed。
它开始用另一个更凶狠的问题逼问自己——
如果世界最强模型的门票真的贵到这个程度,我们敢不敢买?
现在,字节把筹码推上去了。
接下来真正值得看的,不是“10万亿”这四个字有多震撼。
而是几个月以后,它究竟能不能把这笔天价计算,变成真正可感知的智能增量。
如果能,字节跨过去的就不只是一道参数门槛。
它会第一次真正拥有资格,坐到全球基础模型牌桌最中央。
如果不能,10万亿参数也会用最昂贵的方式提醒所有人:
AI世界里,规模可以买到入场券。
但买不到冠军。
参考资料
- Financial Times. “ByteDance targets mega AI model nearing Anthropic’s Mythos.” 2026年8月7日。《金融时报》援引三名知情人士报道字节最高10万亿参数模型的预训练进展,并披露Mythos 5、Fable 5的行业参数估算。(金融时报)
- Reuters. “ByteDance targets mega AI model that could match Mythos scale, FT reports.” 2026年8月7日。路透社对《金融时报》报道进行跟进,并强调参数规模不等同于实际模型能力。(Reuters)
- Reuters. “ByteDance founder tells staff to avoid AI distillation, The Paper reports.” 2026年8月6日。关于张一鸣要求团队避免依赖竞争对手模型蒸馏、接受短期能力代价的报道。(Reuters)
- Kimi Team. “Kimi K3: Open Frontier Intelligence.” arXiv:2607.24653,2026年7月27日。Kimi K3技术报告披露其2.8万亿总参数、1040亿激活参数及MoE架构。(arXiv)
- ByteDance Seed. “Seed2.0 Model Card: Towards Intelligence Frontier for Real-World Complexity.” arXiv:2607.00248,2026年6月30日。介绍Seed2.0在复杂真实任务、长尾知识、推理、视觉与Agent方向的能力建设。(arXiv)
- Bloomberg News. “ByteDance Weighs Capex of as Much as $70 Billion in AI Push.” 2026年5月27日。报道称字节讨论将2026年资本开支提升至最高约700亿美元,并披露其AI基础设施投入计划及2025年利润估算。(彭博税务新闻)
- Reuters. “US official says Nvidia has begun shipping powerful H200 AI chips to China.” 2026年7月14日。美国商务部官员表示H200已经开始对华出货,但截至当时实际数量仍然非常有限。(Investing.com)
- Hoffmann, Jordan, et al. “Training Compute-Optimal Large Language Models.” arXiv:2203.15556,2022年。经典Chinchilla研究,讨论模型规模、训练数据与计算预算之间的最优配置关系。(arXiv)