真正决定国产芯片能不能站住的,已经不是一项跑分,而是整座集群能否稳定、便宜、持续地跑起来。
文章作者、来源:0x9999in1,ME News
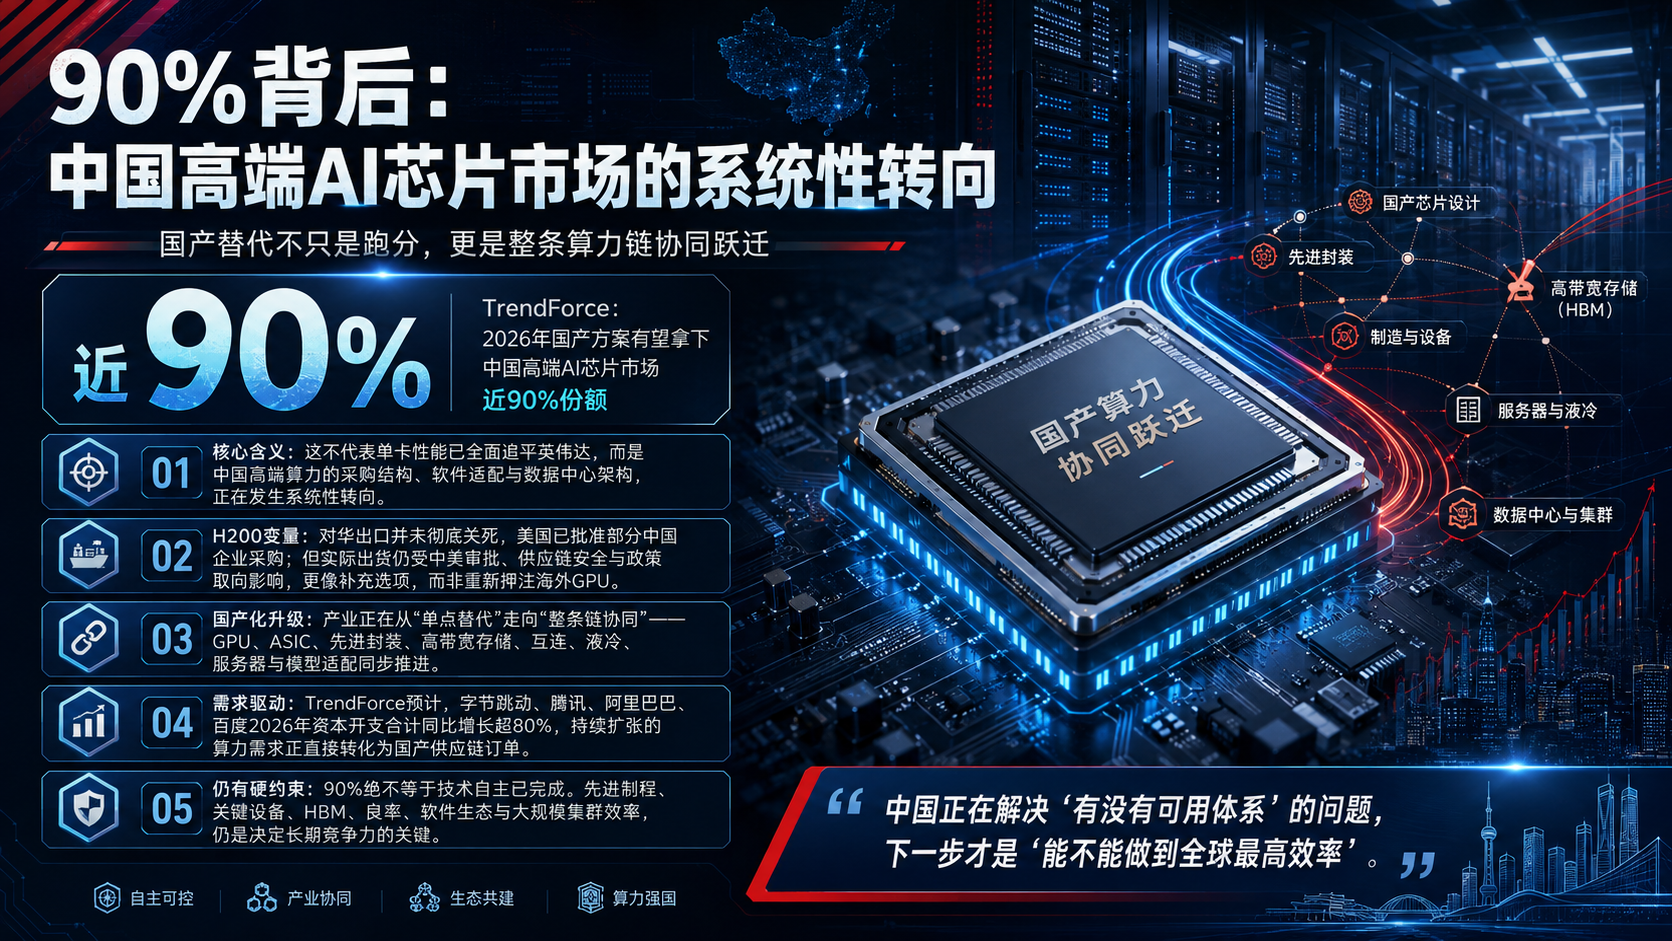
TL;DR
- TrendForce在2026年8月10日的最新供应链观察中预计,国产方案今年有望拿下中国高端AI芯片市场近90%的份额。这个数字最重要的含义,不是国产芯片已经在单卡性能上全面追平英伟达,而是中国高端算力的采购结构、软件适配和数据中心架构正在发生系统性转向。
- H200对华出口的门并没有彻底关死。美国已经批准部分中国企业购买,但实际出货仍受中美两侧审批、供应链安全和政策取向影响。它更像一个充满变量的补充选项,而不是中国AI基础设施重新押注海外GPU的信号。
- 中国国产化正在从“单点替代”走向“整条链协同”:GPU、ASIC、先进封装、高带宽存储、互连、液冷、服务器和模型适配一起推进。真正决定国产芯片能不能站住的,已经不是一项跑分,而是整座集群能否稳定、便宜、持续地跑起来。
- 需求端也在推着产业链向前。TrendForce预计,字节跳动、腾讯、阿里巴巴、百度2026年资本开支合计同比增长超过80%。算力需求没有因为进口限制消失,反而把“缺什么就补什么”的压力变成了国产供应链最直接的订单。
- 但90%绝不能被解读成“技术自主已经完成”。先进制程、关键设备、HBM、良率、软件生态和大规模集群效率仍是硬约束。中国正在解决的是“有没有可用体系”的问题,接下来才是“能不能做到全球最高效率”的问题。
90%最震撼的地方,不是数字大,而是市场逻辑变了
几年前讨论中国AI芯片,最常见的问题还是:国产GPU能不能替代英伟达?
到了2026年,这个问题已经显得有些落后。
TrendForce在8月10日发布的最新供应链观察给出了一个非常激进、也非常值得谨慎理解的判断:国产方案今年有望占据中国高端AI芯片市场近90%的份额,中国AI基础设施正逐步从高度依赖海外GPU,转向“国产GPU+自研ASIC”的双轨模式。
90%意味着什么?
它当然不意味着中国所有国产AI芯片的单卡性能、能效、软件生态都达到了全球最顶级水平,更不意味着先进制造环节已经不存在外部依赖。把市场份额直接等同于技术领先,是最容易犯的错误。
真正值得关注的是另一件事:过去国产芯片往往是在“英伟达买不到时先顶上”,现在却越来越像“项目从立项开始就按国产平台设计”。
这两者差别巨大。
前一种模式里,国产芯片只是备胎,CUDA仍然是默认语言,服务器设计、模型训练、运维工具和人才体系都围绕海外GPU建立。只要限制松一点,客户就可能回去。
后一种模式则完全不同。芯片、服务器、网络、存储、散热、编译器、框架、模型和采购标准一起改变。一旦一个大型云厂商把数千甚至数万张国产加速卡部署进生产环境,并让团队投入大量时间完成适配,迁移成本就开始反过来保护国产生态。
所以,近90%如果最终兑现,它不是一张“性能冠军证书”,而是一张“市场结构改写通知书”。
这也是为什么H200即便重新获得部分进入中国的可能,也很难让时间倒流。
H200为什么重要,又为什么没那么重要
H200当然重要。
它有成熟的CUDA生态,有经过大规模验证的训练和推理能力。对已经深度使用英伟达平台的大型互联网公司来说,继续采购H200可以降低迁移成本,也能缓解短期高端算力紧张。
今年美国已经允许H200在许可机制下对华销售,并批准大约10家中国企业购买。到了7月,又有报道称,中国可能允许阿里巴巴、字节跳动、DeepSeek等头部AI企业购买有限数量的H200,潜在批准规模可能少于20万颗。
这听起来像是英伟达重新打开了中国市场。
可问题是:门开了一条缝,不等于供应链恢复原样。
TrendForce在8月10日的判断仍然是,H200能否顺利完成对华出货存在很大不确定性。过去几个月的反复本身已经说明,企业面对的不是普通采购问题,而是一个审批条件、政策目标和地缘政治随时可能变化的供应问题。
对大型AI基础设施来说,最怕的并不是某一张卡贵10%,而是你不知道明年还能不能继续买,不知道下一代产品能不能顺利交付,也不知道已经建好的集群是否能在未来几年持续获得扩容资源。
这会直接改变采购者的风险模型。
于是,一个看似矛盾的局面出现了:H200越强,越能证明英伟达仍然有技术吸引力;但H200出货越不确定,中国企业就越有动力把关键工作负载迁移到可持续获得的国产平台。
这也是当前中国AI芯片自主化最核心的推动力之一——不是所有客户突然产生了技术情怀,而是供应确定性本身已经变成性能指标。
真正的国产化,不是在芯片上贴一个“中国制造”
如果只盯着GPU芯片本身,很容易低估这场变化。
AI算力从来不是一颗芯片的比赛。一个高端训练集群能不能工作,取决于芯片、HBM、先进封装、服务器、互连、交换机、光模块、供电、液冷、编译器、框架、调度系统和模型优化。
任何一个环节掉链子,理论算力都会变成机房里昂贵的热量。
TrendForce此次特别提到,中国本土产业链正在先进制程、先进封装和散热管理等关键环节加速成熟。这个判断与过去一年中国AI基础设施的发展方向是一致的:不再执着于“单卡一定要完全复制英伟达”,而是越来越强调系统级补偿。
华为是最典型的例子。
华为公开的Atlas 900 A3 SuperPoD采用384颗昇腾910C组成大型计算系统,其后续昇腾950系列进一步强调低精度计算、内存与芯片互连,并规划更大规模的SuperPoD。
这里最关键的不是“384”这个数字,而是一种思路:如果单颗芯片受制于制造工艺,那么就用更多芯片、更高互连带宽、更激进的系统架构,把单芯片差距尽可能转化为集群工程问题。
这条路并不轻松,甚至可能更耗电、更复杂,对通信和软件调度要求更高。但它至少给了中国厂商一条现实路径:在无法自由获得全球最先进制造条件和最成熟GPU的情况下,不等工艺追平之后再做AI,而是边跑边补。
芯片制程落后,就补架构。
单卡能力不足,就补互连。
显存受限,就重新设计内存层级。
硬件利用率不够,就从模型、编译器和调度系统里找效率。
这不是魔法,更不能消除基础技术差距,但它正在把一场原本高度依赖单颗旗舰GPU的竞赛,拖进更复杂的系统工程战场。
而系统工程,恰恰是中国庞大制造业和数据中心市场能够不断提供试错空间的地方。
GPU之外,ASIC正在成为第二条腿
如果说国产GPU解决的是通用性,那么ASIC解决的就是成本和效率。
全球云厂商其实都在做同一件事。Google有TPU,AWS不断扩大自研芯片部署,Meta也在推动自己的AI加速器。原因并不神秘:当AI计算量大到一定程度,把所有工作负载都交给昂贵的通用GPU,财务上会越来越难受。
中国也在进入这个阶段。
TrendForce预计,字节跳动、腾讯、阿里巴巴和百度2026年资本开支合计同比增长超过80%,其中字节跳动的投资重点就包括大型AI数据中心、自研ASIC和GPU集群。与此同时,字节跳动正在接触天数智芯等本土AI芯片供应商,也在评估百度昆仑芯方案;7月,DeepSeek又被曝正在开发自己的推理芯片。
这就说明,中国AI芯片市场并不是简单地从“NVIDIA一家独大”切换为“某一家国产GPU独大”。
更可能出现的是多层结构:训练端需要高通用、高互连的大型GPU或NPU平台;推理端会出现越来越多针对特定模型、推荐系统、Agent和云服务优化的ASIC;部分互联网巨头则会把自研芯片与外部国产GPU混合部署。
为什么推理尤其适合ASIC?
因为AI产业正在从“拼命训练模型”走向“让模型每天服务海量请求”。训练追求极限能力,推理更在乎每个Token花多少钱、每瓦电能产生多少有效吞吐、服务器能否长时间稳定运行。
一旦推理成为算力消耗的大头,芯片竞争就会从“谁的峰值算力最大”,转向“谁能把一百万次请求做得更便宜”。
到那时,中国市场最大的机会未必是造出一颗完全复制英伟达的GPU,而可能是围绕本土模型、本土云和本土应用,长出一批极度贴合工作负载的专用芯片。
这才是“国产GPU+ASIC”双轨路线真正值得警惕的地方:它不是永远追着一个标杆跑,而是在尝试改变赛道的形状。
订单正在变成国产生态最宝贵的训练数据
芯片产业有一个残酷规律:没有大规模客户,就很难真正迭代。
实验室里的跑分能证明一颗芯片“能用”,但只有生产环境会告诉你,它会在哪个算子崩溃、哪种并行方式效率低、哪个驱动在长时间负载下不稳定、哪个机柜散热扛不住。
这就是为什么2026年的国产替代比过去更有意义。
TrendForce今年7月援引的调查显示,中国企业未来12个月计划把AI加速器预算中用于国产产品的比例从当前约30%提高到46%。同一篇报道还援引伯恩斯坦预测,英伟达在中国AI半导体市场的份额2026年可能降至约8%,而华为可能超过50%。
这些数字与“高端AI芯片近90%国产份额”不能简单机械相加,因为机构、产品范围、收入与采购预算的统计口径并不相同。
但方向高度一致:钱正在向本土方案倾斜。
更重要的是,这已经不只是政策采购。
DeepSeek今年发布V4时,把模型重点向华为昇腾平台优化;随后国内大型科技企业对新一代昇腾芯片的需求升温。路透此前报道称,华为计划2026年出货约75万颗950PR。对于国产产业链来说,量产与交付能力因此从一个制造问题,变成了决定整个AI生态扩张速度的问题。
模型适配芯片,芯片根据模型继续优化,再由云厂商用真实业务把问题反馈回来——这才是生态真正开始闭环的时刻。
英伟达最强大的地方,从来不只是GPU晶体管多,而是二十多年积累的CUDA、开发者、库、工具和应用。
中国国产AI芯片想挑战这道护城河,没有捷径。
但有一种东西可以加速追赶:真实订单。
每一批国产卡进入数据中心,都是一次压力测试;每一个大模型主动适配国产平台,都是一次软件生态扩容;每一家云厂商把国产芯片放进生产服务,都在给整个产业链增加一层经验。
市场份额本身,会制造下一轮市场份额。
这可能才是90%最有力量的地方。
但别被90%冲昏头:真正难啃的骨头还在上游
说到这里,最需要泼的一盆冷水也必须泼。
近90%的国产市场份额,如果实现,是一次巨大的产业转折;但它绝不等于高端AI芯片已经完全自主。
截至2026年,中国先进逻辑芯片制造仍面临明显的工艺和设备约束。路透今年5月在讨论华为新一代芯片设计路线时指出,中国最先进、已经得到验证的制造能力仍普遍被认为在7纳米左右,而台积电已经进入2纳米,并计划在2028年推进1.4纳米量产。
这就是现实差距。
EUV光刻机等先进制造设备的限制并没有因为国产GPU市场份额提高而凭空消失。
这意味着,国产芯片当然可以通过架构、互连、封装和软件提高系统性能,但如果完成同样的任务需要更多芯片、更大机房和更多电力,最终成本仍然会被拉高。
系统工程能够缓解制程差距,却不能让物理规律消失。
HBM也是类似的问题。
AI加速器不是只需要计算单元,还需要巨大的内存容量和带宽。国内企业正在加速建立自己的高带宽存储、先进封装和内存体系,但最终能否在性能、良率、规模、成本和封装上实现长期稳定供给,仍然决定着国产高端算力能走多快。
软件则是另一座山。
从CUDA迁移到国产平台,不只是重新编译一次代码。算子库、通信库、调度框架、性能分析、故障定位、集群运维全部要重新磨合。几十张卡能跑,与几万张乃至更大规模集群长期稳定运行,中间隔着一整套工程能力。
所以,现在最危险的叙事有两种。
一种是“国产已经90%,所以英伟达不重要了”。
另一种是“国产单卡还没全面追平,所以国产化没有意义”。
两种都错。
前者忽略技术差距,后者忽略产业学习速度。
中国真正争夺的,不是一颗GPU,而是AI时代的工业底座
把时间拉长,中国正在做的事情其实非常清楚。
第一阶段,是在外部限制下解决“有没有”。
第二阶段,是通过政策、订单和资本开支解决“能不能规模化”。
第三阶段,才是最艰难的——解决“同样一度电、同样一块钱、同样一个机柜,谁能产出更多有效智能”。
2026年显然已经进入第二阶段,而且速度比很多人预想得更快。
TrendForce预计,全球九大云服务商2026年资本开支合计将超过8867亿美元,同比增长约90%;其中字节跳动、腾讯、阿里巴巴、百度四家中国云服务商的资本开支合计增幅预计超过80%。
这组数字说明了一件事:全球AI基础设施竞赛远没有降温,中国也没有因为高端GPU受限而退出牌桌。
恰恰相反,需求越大,国产供应链承受的压力越大;压力越大,芯片、封装、存储、互连和散热的迭代速度就越快。
这是一场极其昂贵的产业实验,也一定会有失败者。
不是每一家国产GPU公司都能活下来,不是每一种架构都能形成生态,也不是所有政策支持最终都能变成商业竞争力。高估任何一家企业,都可能付出惨重代价。
但产业方向已经越来越难逆转。
只要中国最大的云厂商、大模型公司和数据中心继续把真实负载交给国产芯片,国产化就不再只是“替代进口”的供应链命题,而会变成一个商业飞轮:订单带来收入,收入支撑研发,研发提升性能,性能再换来更多订单。
国产化真正的分水岭,不是芯片第一次点亮。
而是客户第二次、第三次还愿意继续下单。
如果这一步跨过去,性质就完全不同了。
结语:H200也许会进来,但旧时代很难再回来
未来几个月,H200究竟能不能大规模进入中国,仍然值得看。
如果放行,中国科技公司会买吗?
会。
成熟、高性能、生态完整的芯片,没有理由因为国产化就拒绝使用。真正理性的公司也不会为了“国产”两个字主动放弃明显更高效的商业方案。
但H200还能重新成为中国AI基础设施唯一的默认答案吗?
恐怕越来越难。
因为真正发生变化的,不只是进口规则,而是整个产业的决策方式。
过去企业先问:“英伟达能给我什么?”
现在越来越多大型项目必须先问:“什么方案能够连续供应三到五年?能不能在本土持续扩容?模型能不能深度适配?成本能不能被我自己控制?”
当问题变了,答案自然会变。
近90%的国产份额,如果最终兑现,不代表中国已经赢得高端AI芯片战争。它只代表中国终于拥有了一块足够大的主场,可以让自己的芯片、软件和基础设施在真实商业环境里反复训练。
而半导体产业最怕的,从来不是对手暂时落后。
最怕的是,对手有市场,有资金,有客户,有工程师,还有足够多的失败机会。
2026年的中国高端AI芯片,真正跨过去的也许不是某一道制程节点,而是心理和产业上的那道线:
从“等别人卖给我”,走向“即使别人愿意卖,我也必须保留自己的答案”。
这条路距离终点还很远。
但方向,已经很难回头。
参考资料
- TrendForce. “China's Aggressive Push for High-End AI Chip Autonomy.” 2026-08-10.
- TrendForce. “AI Server Shipments Forecast Raised to Nearly 31% YoY in 2026 as 90% Surge in CSP CapEx Fuels Infrastructure Expansion.” 2026-08-03.
- TrendForce. “[News] Chinese Firms Reportedly Raise Domestic AI Chip Budget Share from 30% to 46% Amid Shift from NVIDIA.” 2026-07-07.
- Reuters. “China plans to let top AI firms buy limited Nvidia H200 chips, the Information reports.” 2026-07-08.
- Reuters. “Huawei's new AI chip finds favour with ByteDance, Alibaba, which plan to place orders.” 2026-03-27.
- Reuters. “DeepSeek unveils new AI model tailored for Huawei chips as China pushes for tech autonomy.” 2026-04-24.
- Huawei. “Groundbreaking SuperPoD Interconnect: Leading a New Paradigm for AI Infrastructure.” 2025-09-18.
- Reuters. “China's Huawei reveals chip design breakthrough amid US sanctions.” 2026-05-25.