ChatTJB不是AI行业的替代方案,也不证明“真人一定比AI好”。它更像一面故意做得很慢、很笨的镜子:当答案越来越便宜、越来越即时,真正稀缺的东西开始变成判断、质疑,以及愿意为一个答案负责的人。
文章作者、来源:0x9999in1,ME News
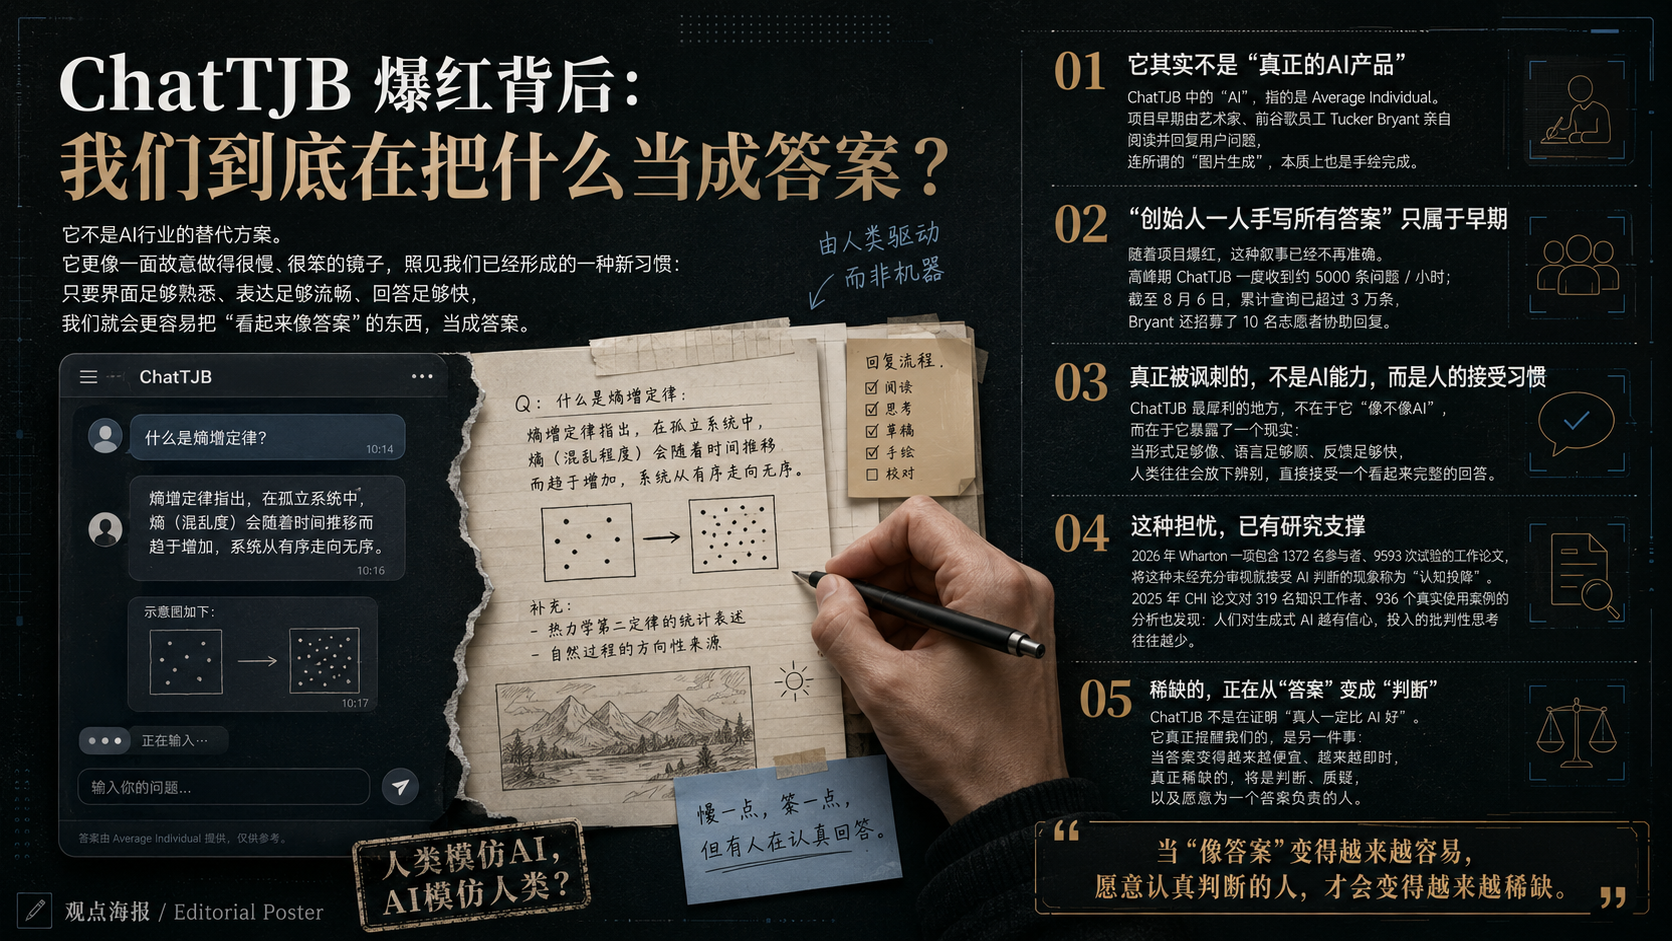
TL;DR
- ChatTJB并不是真正的AI产品。“AI”在这里指Average Individual,最初由艺术家、前谷歌员工Tucker Bryant亲自阅读并回复用户问题,连“图片生成”也是手绘。
- 但“创始人一人手写所有答案”只适用于项目早期。爆红后,ChatTJB峰值一度收到约5000条问题/小时;截至8月6日累计超过3万条查询,Bryant已经招募10名志愿者协助,因此今天再说“所有答案都由他一人回复”并不准确。
- 这个项目真正讽刺的不是AI能力,而是人类正在形成的一种新习惯:只要界面足够熟悉、表达足够流畅、回答足够快,我们就倾向于把“看起来像答案”的东西当成答案。
- 这种担忧并非纯粹文艺表达。2026年Wharton一项包含1372名参与者、9593次试验的工作论文,把无充分审视地接受AI判断称为“认知投降”;2025年CHI论文对319名知识工作者的936个真实使用案例分析,也发现对生成式AI越有信心,投入的批判性思考往往越少。
- ChatTJB不是AI行业的替代方案,也不证明“真人一定比AI好”。它更像一面故意做得很慢、很笨的镜子:当答案越来越便宜、越来越即时,真正稀缺的东西开始变成判断、质疑,以及愿意为一个答案负责的人。
这不是“AI造假”,而是一面故意做得很慢的镜子
旧金山最近最有意思的“AI新品”,没有模型参数,没有推理集群,没有GPU,也没有什么令人眼花缭乱的Benchmark。它甚至没有真正的人工智能。
ChatTJB的玩法很简单:网页长得像聊天机器人,广告牌写着“由AI驱动”,但那个小小的星号藏着整个笑话——AI不是Artificial Intelligence,而是Average Individual,普通个人。这个“普通个人”,最初就是32岁的Tucker Bryant,一位艺术家、演讲者和前谷歌员工。用户发来问题,他本人阅读、思考、敲字;用户要图片,他就拿笔画。官网把它包装成“Artisanal Intelligence”,手工打造的智能,又一本正经地发明了“Single-Operator Large Language Experience”,单人运营的大型语言体验。
荒诞吗?当然荒诞。但它的荒诞是精心校准过的。
Bryant今年4月上线这个项目,7月27日在旧金山SoMa投下了一块约6000美元的广告牌,项目随后迅速扩散。根据WIRED在8月7日刊发的采访,截至8月6日,ChatTJB已经收到超过3万条查询,峰值约5000条每小时。一个人当然不可能扛住这种流量,于是他从超过3000名申请者中招募了10名志愿者帮忙。
也就是说,如果今天还把它描述成“所有答案都由创始人一人手写”,就已经落后于事实。准确说法是,它最初确实靠Bryant本人逐条回复,爆红之后正在变成一个由真人共同回答的社区式艺术项目。
这处修正很重要。因为ChatTJB最有力量的地方,从来不是“一个人硬扛几万条消息”的苦情故事,而是它故意把现代AI产品最核心的卖点全部反过来:别人拼速度,它让你等;别人强调规模,它强调一个人的有限;别人追求稳定输出,它允许情绪、疲惫、偏好甚至“不知道”出现。
我们已经被数字产品教育了二十多年:等待意味着产品差,摩擦意味着体验差,不确定意味着能力差。ChatTJB偏偏把这些“缺点”全部搬回来,然后问一句:如果一个回答需要等待,你会不会更认真地看它?如果你知道回答者只是一个普通人,你会不会更自然地保留怀疑?如果答案不再像流水线一样源源不断,我们是不是反而会重新意识到,回答问题本来就是一种有成本的行为?
这才是它真正扎人的地方。
最刺眼的不是“真人装AI”,而是我们已经习惯“机器像人”
ChatTJB这个笑话能成立,靠的不是观众不懂AI,而是观众太熟悉AI。
深色界面、输入框、正在生成的动态、流畅完整的段落、近乎永远在线的响应——过去几年,这套交互已经迅速变成一种新的心理暗示。我们看到这样的界面,会自动预期背后存在一个庞大、即时、无疲劳的系统;更进一步,我们也越来越容易把“表达得像专家”与“真的可靠”混在一起。
这不是小众行为。OpenAI在2026年7月31日披露,其模型已经覆盖超过10亿活跃用户和200多万家企业;公司还称,用户注册六个月后,日均发送消息量大约增加50%,使用ChatGPT处理的工作类型大约翻倍。8月6日发布的OpenAI Signals数据则显示,在工作场景中,人们使用ChatGPT去“完成任务或创造产出”的倾向,是非工作场景的两倍以上。
无论如何评价这些由公司自身披露的数据,一个趋势已经很难否认:生成式AI正在从“偶尔问一下”,变成工作流和日常决策的基础设施。
问题也恰恰从这里开始。
当工具只是偶尔使用,人会把它当工具;当工具每天出现几十次,它就会开始塑造人的默认动作。以前遇到一个小问题,我们可能先想一想,再搜索;现在越来越多人的顺序变成了先问AI,再决定自己要不要想。这个变化看起来只节省了几十秒,但它真正改变的是“谁先提出第一版判断”。
Bryant自己举过一个很有代表性的例子:他住在旧金山多年,却有一次因为当天大约18摄氏度,跑去问语言模型该穿短袖还是长袖。问题不在于AI能不能回答天气穿衣,而在于他突然意识到,这件事自己完全有经验、有身体感受、有生活常识,却仍然下意识把判断外包了。
这就是ChatTJB要制造的那一点刺痛:不是告诉你“别用AI”,而是让你发现,自己究竟从什么时候开始,连原本不需要外包的判断也顺手外包了。
“认知投降”不是段子,但也不能被夸大成“AI让人变笨”
Bryant频繁提到一个词:Cognitive Surrender,认知投降。
2026年,Wharton研究者Steven D. Shaw与Gideon Nave在一篇工作论文中提出“三系统”框架:除了快速直觉的System 1、缓慢审慎的System 2,人类如今多了一个外部的System 3——AI。关键不在于用了AI,而在于AI给出结论之后,人还有没有真正启动自己的审视。
他们进行了三项预注册实验,共1372名参与者、9593次试验。研究者人为控制AI回答的正确与错误。当参与者咨询到错误的AI建议时,全部相关试验中有73.2%被归为“认知投降”,也就是用户接受了错误建议;19.7%属于成功纠正AI的认知卸载。第一项研究中,相比没有AI的基线,AI正确时参与者准确率提高约25个百分点,AI错误时反而下降约15个百分点,而且参与者在使用AI之后的自信心仍会上升,哪怕AI给错了。
这个结果确实值得警惕,但必须把边界说清楚:这是一篇工作论文,它研究的是特定实验条件下的推理行为,不足以推出“使用AI会让所有人长期变笨”这种耸动结论。
更准确的结论是,当AI输出足够流畅、用户又高度信任它时,人类原本负责检查、质疑和纠错的那一层判断,可能更容易被跳过。
另一项更早、也更贴近日常工作的研究提供了相似信号。2025年CHI大会论文调查了319名知识工作者,收集936个真实的生成式AI工作案例。研究发现,在控制任务和个人差异后,对生成式AI的信心越高,用户自报的批判性思考投入越少;相反,对自己完成任务的能力越有信心,批判性思考越多。研究者同时强调,AI并非简单“消灭思考”,而是把思考重心转向验证信息、整合答案和管理任务。
这两组研究放在一起,最值得注意的不是“AI危险”,而是一个更麻烦的事实:越好用的AI,越可能要求用户拥有更强的判断力。
这听起来有点反常。工具不是应该越智能越省心吗?执行层面当然是。但当一个系统能够写代码、做分析、拟合同、提供健康信息、解释法律条款、安慰情绪、规划人生时,它越像一个万能顾问,人就越容易忘记它依然存在知识边界、上下文缺失、概率性错误和目标错配。
AI能力上升,并不会自动让人的责任下降。很多时候,恰恰相反。
ChatTJB最聪明的一点,是把“低效率”重新变成了信息
ChatTJB的答案慢,可能隔很久才来;回复的人也会挑问题,有志愿者明确说自己不会去答那些困难数学题。有人问严肃的家庭关系,有人问晚饭吃什么,有人在蜜月第一晚因为无法放松而寻求安慰。面对这些问题,真人会迟疑、会选择、会意识到某些话不能随便说。
从商业产品角度看,这些都是缺陷。可从认知角度看,它们又都是信号。
“我需要时间想一想”,意味着这件事可能没有标准答案;“这个我不会”,意味着知识有边界;“我不想回答”,意味着注意力有成本;“这件事太严肃,不能开玩笑”,意味着回答者意识到后果。传统人际交流里,我们正是通过这些信号判断一个回答有多大分量。
而今天的大模型,最强大的体验之一,恰恰是把这些信号压平。无论你问的是煎蛋、估值模型、分手短信还是人生选择,界面都可以用同样稳定的速度、同样完整的句式、同样从容的语气回应。对产品而言,这是一种惊人的能力;对人类心理而言,它也制造了一个前所未有的难题:不同风险等级的问题,看起来获得了同等“专业感”的答案。
所以ChatTJB真正恢复的,不只是“真人味”,而是摩擦。
摩擦提醒你这里有人在判断;等待提醒你答案不是空气;不完美提醒你别把输出当神谕。它甚至暴露了自己的不可扩展性:流量一上来,一个人的手就不够用了,只能招志愿者、做筛选、增加危机应对资源、过滤骚扰信息。它越失败,反而越把“人类回答的真实成本”展示得清楚。
当然,这也意味着ChatTJB绝不是什么值得复制的产品范式。真人可能同样错误、偏见、情绪化;多人志愿回复会带来一致性问题;如果用户误以为自己在和机器说话,还可能无意间披露敏感信息。正因为如此,Bryant才不断强调它首先是一件讽刺性的公共艺术作品,而不是一项真正的AI服务。
它的价值不在可扩展,而在不可扩展。
AI产品真正该学的,不是“变慢”,而是别让用户太快相信
把ChatTJB理解成“人类战胜AI”,会错过它最有价值的部分。Bryant本人并不反AI,甚至用AI辅助搭建了ChatTJB网站。这种反差恰恰说明问题:他批评的不是人工智能存在,而是我们把“高效输出”误认为“无需判断”。
未来的AI不会因为这场艺术项目而变慢。相反,它只会更快、更主动、更像代理人。从2026年的产品趋势看,AI正在从回答问题走向完成多步骤任务;这意味着用户面对的也不再只是“这句话对不对”,而是“这个系统替我做了哪些决定、用了什么依据、在哪一步可能错了”。
因此,更成熟的AI产品设计,未必应该永远追求零摩擦。对于高风险任务,好的系统应当让不确定性更可见,让来源更容易核验,让关键假设能够被追踪,让用户在不可逆操作前重新确认;更进一步,AI可以主动给出反方论据,指出自己最可能错在哪里,而不是把所有输出都包装成同一种顺滑的确定感。
这听起来会不会降低体验?会,至少会让某些流程多几秒钟。但问题是:金融交易、医疗判断、法律文书、重大职业选择,真的应该像刷短视频一样追求“无感完成”吗?
效率是价值,摩擦有时也是价值。关键在于摩擦出现在哪里。
如果AI替你整理会议纪要、改格式、生成初稿,越顺越好;如果AI正在替你做一项可能影响金钱、健康、声誉和关系的判断,那么“请再想一次”可能比“立即完成”更值得设计进去。真正高级的人机协作,不是让人永远待在环里当一个盖章的橡皮图章,而是让人知道什么时候必须重新接管。
真正稀缺的,正在从“答案”变成“对答案负责”
过去,获得答案很贵。你要查书、找专家、做调研、付咨询费。搜索引擎把找资料的成本打了下来,生成式AI则进一步把“组织成答案”的成本压到接近零。
这是一场巨大的生产力革命,没有必要浪漫化低效率,更没必要把手写回复包装成人类文明最后的高地。AI能做的事情会越来越多,其中大量工作本来就应该被自动化。
但恰恰因为答案变得极其便宜,判断开始升值。
什么值得问AI,什么应该自己先想?什么可以直接采用,什么必须核验?什么只是信息问题,什么其实是价值选择?什么错误可以撤销,什么错误一旦执行就会留下真实代价?这些问题不会因为模型更强而消失,只会因为AI更深地进入生活而变得更重要。
一个很实用的界线是:低风险、可逆、重复性的任务,可以大胆外包;高风险、不可逆、涉及价值取舍和身份选择的任务,把AI当第二意见,而不是最终裁判。更好的习惯甚至可以再多一步——先写下自己的初步判断,再去问AI;要求它反驳你,而不是迎合你;遇到关键事实回到原始来源;如果答案让你异常舒服,尤其要问一句:它是在提供证据,还是只是在提供一种确定感?
ChatTJB不会取代ChatGPT,也不会成为下一家百亿美元公司。它大概率注定是一个小项目,一块广告牌,一场被流量意外放大的行为艺术。
可它偏偏在2026年的此刻出现,显得非常准确。
当全世界都在竞赛怎样让机器更像人,一个真人却坐在屏幕后面,故意把自己包装成机器;当整个行业都在消灭等待,他重新制造等待;当模型越来越擅长给出完整答案,他用笨拙、有限和偶尔的不确定,提醒用户别忘了自己的那部分工作。
所以,ChatTJB真正好笑的地方,不是“AI原来是个人”。
而是我们已经走到一个时代:一个普通人只需要套上AI界面,就能立刻借到机器的权威感;而一台机器只要说得足够流畅,也能轻易借走人的判断权。
未来的AI当然应该越来越聪明。但如果人的目标只是把每一个问题都更快地交出去,那么再聪明的机器,也无法替我们回答最后那个问题——究竟哪些判断,仍然应该由自己承担。
答案越来越多之后,最贵的东西,也许就是这一点不肯轻易交出去的判断力。
参考资料
- Caroline Haskins. “The Hottest New AI Chatbot Is Just a Guy Answering Your Questions.” WIRED, 2026-08-07.
- Lily Janiak. “San Francisco artist’s fake AI chatbot goes viral — because it’s actually human.” San Francisco Chronicle, 2026-08-06.
- ChatTJB. “Artisanal intelligence, handcrafted by one human.” ChatTJB Official Site, accessed 2026-08-11.
- Steven D. Shaw, Gideon Nave. “Thinking—Fast, Slow, and Artificial: How AI is Reshaping Human Reasoning and the Rise of Cognitive Surrender.” Wharton School / SSRN Working Paper, 2026.
- Hao-Ping Lee et al. “The Impact of Generative AI on Critical Thinking: Self-Reported Reductions in Cognitive Effort and Confidence Effects From a Survey of Knowledge Workers.” CHI Conference on Human Factors in Computing Systems, ACM, 2025.
- OpenAI. “Building abundant intelligence.” 2026-07-31.
- OpenAI. “From asking to doing: How the world is putting ChatGPT to work.” 2026-08-06.