WeLM最值得关注的地方,不是6170亿总参数,而是微信把模型目标明确压向了Agent、工具调用和微信生态执行:80B已经进入“小微”,617B则直接瞄准更复杂的小程序开发和工具生成。
文章作者、来源:0x9999in1,ME News
TL;DR
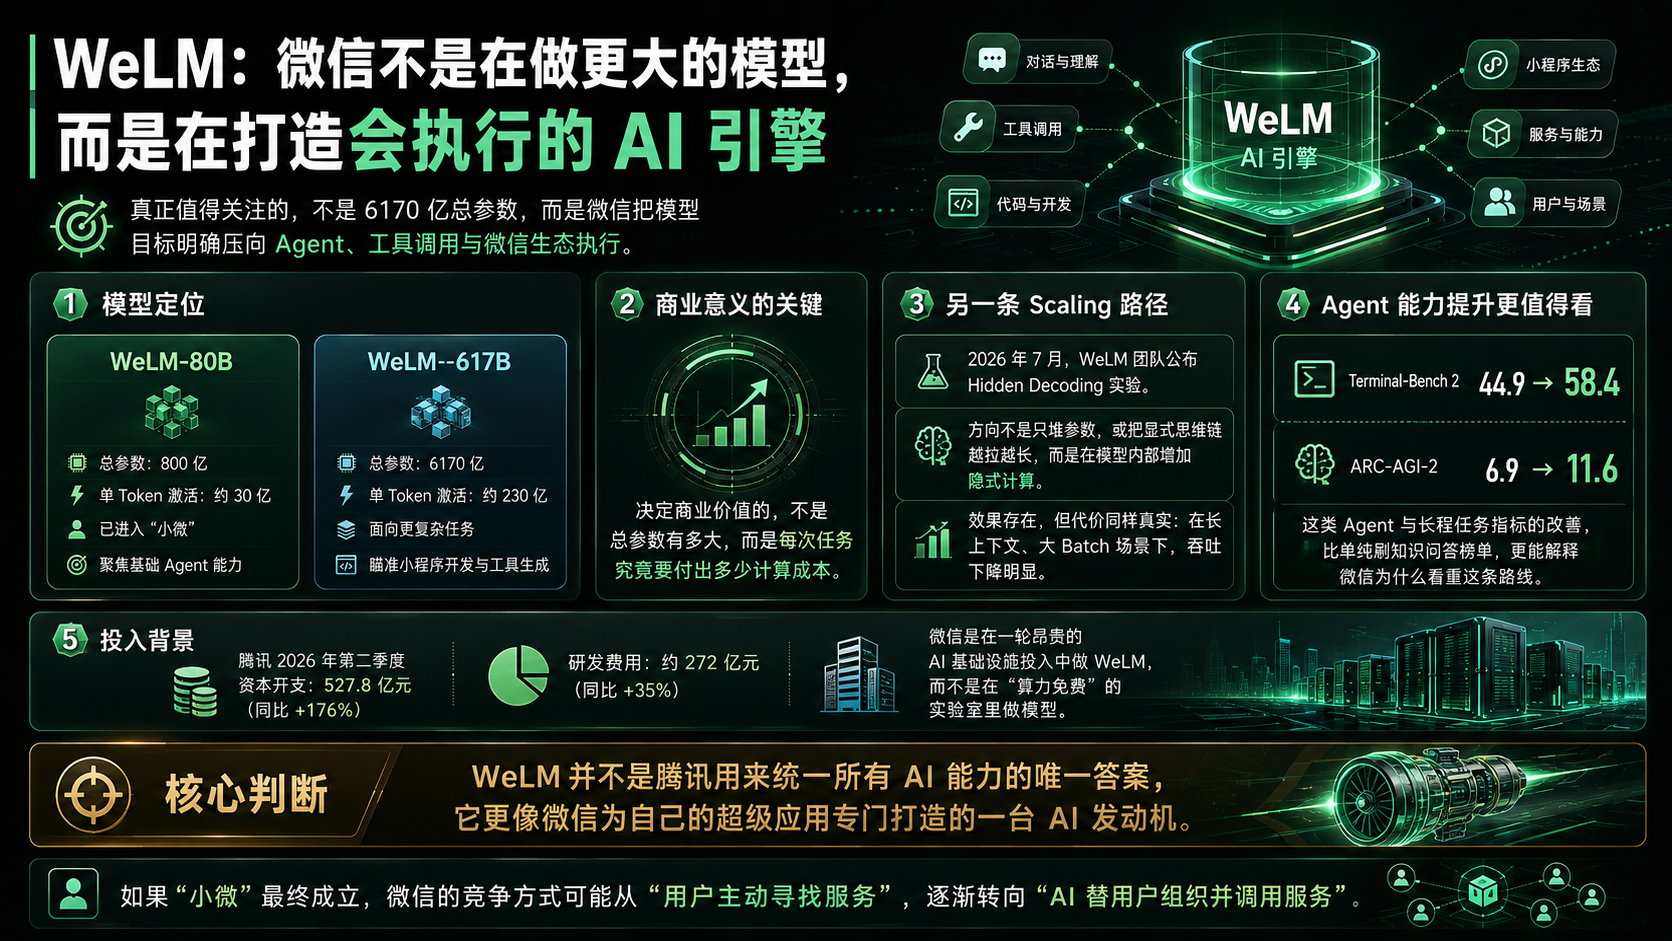
- WeLM最值得关注的地方,不是6170亿总参数,而是微信把模型目标明确压向了Agent、工具调用和微信生态执行:80B已经进入“小微”,617B则直接瞄准更复杂的小程序开发和工具生成。
- 80B总参数800亿、单Token激活约30亿;617B总参数6170亿、激活约230亿。真正决定商业意义的不是总参数有多吓人,而是每次任务究竟需要付出多少计算成本。
- 7月公布的Hidden Decoding实验显示,WeLM团队正在尝试另一条Scaling路径:不只是继续堆参数或把显式思维链越拉越长,而是在模型内部增加隐式计算。效果存在,但代价同样真实,尤其在长上下文、大Batch场景下吞吐下降明显。
- WeLM-80B在Terminal-Bench 2上从44.9提高到58.4,ARC-AGI-2从6.9提高到11.6。这类Agent和长程任务指标的改善,比单纯刷知识问答榜单更能解释微信为什么对这条路线感兴趣。
- 腾讯2026年第二季度资本开支达到527.8亿元,同比增加176%;研发费用272亿元左右,同比增加35%。微信是在一轮昂贵得惊人的AI基础设施投入中做WeLM,而不是在一个“算力免费”的实验室里做模型。
- 我的判断是:WeLM并不是腾讯用来统一所有AI能力的唯一答案,它更像微信为自己的超级应用专门打造的一台AI发动机。如果“小微”最终成立,微信的核心竞争方式可能从“用户主动寻找服务”,逐渐转向“AI替用户组织并调用服务”。
一、真正重要的,不是617B,而是“只激活23B”
2026年8月13日,微信团队进一步公开了WeLM的两档配置。
WeLM-80B,总参数800亿,单次计算激活约30亿参数,已经进入微信原生AI Agent“小微”,承担聊天、搜索、调用微信原生能力和小程序服务等任务。
更大的WeLM-617B仍在开发。总参数6170亿,激活约230亿,面向的也不再只是“回答问题”,而是更复杂的微信生态任务,包括智能开发小程序,以及为小微生成工具。
看到6170亿这个数字,人很容易条件反射:微信也开始卷超大模型了?
但这恰恰可能看错了重点。
617B当然大,可MoE模型最重要的经济参数之一,从来不是“仓库里一共放了多少参数”,而是每处理一个Token时,究竟有多少参数真正参与计算。6170亿总参数、230亿激活参数,激活比例不到4%;80B对应3B激活,同样是非常稀疏的路线。
为什么微信会如此在意这件事?
因为实验室里的大模型和微信里的大模型,根本不是同一种生意。
截至2026年6月底,微信及WeChat合并月活跃账户已经达到14.39亿,同比增长2%。当一个AI能力被塞进这种体量的产品里,哪怕单次请求只贵一点点,乘上亿级用户和高频调用之后,都会变成巨大的服务器、GPU、电力和折旧账单。腾讯8月12日晚公布的Q2财报已经把这种压力写得相当直白:第二季度资本开支527.8亿元,同比大增176%;经营性资本开支518亿元,同比增加190%;研发费用约272亿元,同比增长35%。自由现金流则降至负138亿元。
所以微信面前的问题从来不只是:模型够不够聪明?
还有一句更现实的话:聪明以后,养不养得起?
这也是理解WeLM的第一把钥匙。微信没有把“资源效率”写在模型介绍里当一句漂亮口号,它面对的是14亿级产品真正上线之后近乎残酷的成本乘法。
二、为什么80B先上,而617B还要继续等?
如果只看模型大小,很容易产生另一个疑问。
既然617B明显更强,为什么不直接把最大的模型塞进小微?
答案其实已经藏在微信给两个模型安排的工作里。
80B负责的是聊天、搜索、原生微信功能和小程序服务调用。这些任务最大的要求未必是极限智力,而是反应快、成本低、调用稳定,并且能准确理解微信内部的对象和操作。
你让它帮你找信息、调一个服务、打开某项功能,用户真正无法忍受的并不是模型少知道一道奥数题,而是等了十几秒以后,它还点错了按钮。
617B瞄准的却是另一层任务:更复杂的理解、推理、代码生成、工具构建乃至小程序开发。任务越长、步骤越多,模型在某一步做错判断造成的连锁损失越大,这时候值得为更强的推理能力支付更多计算成本。
这实际上是一种非常典型的Agent经济学:简单任务不值得动用最贵的大脑,困难任务才需要升级算力。
这也意味着,未来真正成熟的微信AI很可能不是“一个模型包办天下”,而是一套不同模型、工具和计算预算之间的调度系统。至于微信最终是否采用这样的动态路由方式,目前并没有公开信息能够确认;但80B和617B被赋予明显不同的产品任务,本身已经说明微信并不打算用单纯的“大力出奇迹”解决所有问题。
这个判断很重要。
过去两年,大模型行业最热闹的舞台是排行榜:谁参数更多,谁数学分数更高,谁代码Benchmark更漂亮。但Agent进入真实产品以后,评价体系正在发生变化。
用户不会每天问:“你的GPQA Diamond是多少?”
用户只会问:“我说了一句话,你到底能不能把事办完?”
微信恰好拥有全中国最丰富的一批“可以被办掉的事”:聊天、内容、公众号、小程序、支付、购物、本地服务以及各种开发者提供的能力。WeLM真正特殊的地方因此不是它又做出了一款模型,而是它出生时就坐在工具堆旁边。
三、Hidden Decoding,才是WeLM最值得看的一张底牌
WeLM-80B和617B并不是今天突然冒出来的名字。
7月9日提交的《Hidden Decoding at Scale: Latent Computation Scaling for Large Language Models》中,两档WeLM架构已经出现:80B为800亿总参数、30亿激活参数;617B为6170亿总参数、230亿激活参数。对应模型分别为49层和94层。
真正有意思的是论文试图回答的问题。
大模型怎么继续变聪明?
最熟悉的办法有两个。
第一,把模型做得更大。
第二,让模型“想得更久”,也就是使用更多推理Token、更长的显式思维过程,用推理时计算换能力。
Hidden Decoding试图插入第三条路:在不继续扩大Transformer主干的情况下,把一个Token扩展成多个内部计算流,让模型在输出下一个Token之前,多进行几轮不可见的内部计算。
可以把它粗略理解成:过去模型拿到题目,走过一遍神经网络就开始落笔;Hidden Decoding则想让它在真正落笔之前,先在内部多打几遍草稿。
这不是一句玄学比喻。WeLM团队在实验中使用了四路Hidden Decoding,也就是HD4。
结果相当值得看。
在相同的早期监督微调条件、没有加入强化学习的情况下,WeLM-HD4-80B在Terminal-Bench 2上的解决率从44.9提升到58.4,增加13.5个百分点;ARC-AGI-2从6.9提升到11.6;LiveCodeBench v6从83.7升至85.1。十项扩展测试中,有八项取得提升。
为什么Terminal-Bench 2这个数字格外值得注意?
因为它不是让模型坐在那里回答一道选择题,而是要求模型在容器环境中操作、执行任务并最终让验证器判断任务是否完成。换句话说,它距离Agent真实工作方式明显更近。
617B的结果也没有令人失望。在论文给出的九项高难评测中,HD4版本全部优于对应的普通617B版本。比如GPQA Diamond从89.1升至91.2,HLE从33.6升至35.4,SciCode从51.4升至52.1。
论文还拿1万亿总参数、320亿激活参数的Kimi K2.6作为外部参考。WeLM-HD4-617B在九项指标中五项更高、四项更低。
这组数据应该怎么描述?
不是“全面碾压”。
更准确的说法是:在明显更低的激活参数量下,WeLM-HD4-617B已经表现出与当时前沿MoE模型竞争的能力。
这个措辞没那么刺激,却更重要。因为对于微信来说,每一次推理都可能最终落到成本表上。
四、但别急着神化Hidden Decoding,它并不是免费的智能
一种AI技术最容易让人误判的时候,就是只展示能力提升,却不谈账单。
Hidden Decoding同样有账单。
理论上,把序列扩大4倍,如果所有注意力层都进行完整计算,注意力成本可能迅速膨胀。WeLM团队因此设计了Stream-Factorized Attention,让大量层只在单条流内部计算,只让部分层进行跨流信息交换。
最终测得的训练成本并没有膨胀到完整注意力下可能出现的16倍:在80B实验中,4倍有效序列带来的单Batch训练时间约为基线的5.1倍;617B约为4.4倍。
已经漂亮很多,但仍然不是免费午餐。
推理端更能说明问题。
在8张H20 GPU上测试WeLM-HD4-80B时,Batch Size为1的交互场景里,模型还能保持普通80B约83%到88%的解码吞吐。这非常关键,因为聊天式产品更接近低Batch、追求响应时间的工作负载。
可一旦上下文越来越长、Batch越来越大,代价迅速暴露。32K输入、Batch Size 32时,吞吐只剩基线的27%。
所以,如果有人把Hidden Decoding理解成“白捡四倍思考能力”,那一定过头了。
它真正提出的是另一种资源交换方式:允许模型付出更多内部计算,换取在不继续扩大主干参数的情况下提高能力,而且尽量让这部分计算仍然适配现代大模型的并行训练体系。
这是一种工程选择,而不是魔法。
更要强调一点:论文中的WeLM-HD4模型,与今天微信公布并用于产品介绍的WeLM型号之间,不能在缺乏官方说明的情况下简单画等号。论文明确区分了普通WeLM和加入Hidden Decoding的HD4版本,目前公开信息能够确认的是80B已经驱动小微,以及两档基础架构和产品定位;不能据此断言线上所有小微请求都在运行HD4。
这条边界必须留着。
技术分析最忌讳的一件事,就是看到两块拼图形状相似,就替官方把最后一块拼上去。
五、微信真正想做的,可能不是ChatGPT装进微信
直到现在,我仍然认为,讨论WeLM时最容易犯的错误,是把“小微”想象成微信里的另一个聊天机器人。
那样太小看微信了。
聊天框只是AI最自然的入口,却未必是终点。
腾讯财报给小微的定义是“微信中的Agentic AI”,而且明确表示WeLM是针对用户隐私、微信场景以及推理效率定制的模型。与此同时,微信今天又把80B的任务写得更加具体:调用微信原生功能、调用小程序服务。
这两个信息放在一起,方向已经相当清楚。
搜索时代,用户寻找页面。
App时代,用户寻找功能。
Agent时代真正令人不安也令人兴奋的变化是:用户可能连功能都不想找了。
想订一个东西、查一个服务、调用某个小程序、整理某段内容,甚至以后生成一个临时工具,人只负责表达意图,剩下的步骤交给Agent判断该调用什么服务。
这时候,微信过去十几年积累的小程序和原生服务不再只是一排排需要用户主动打开的图标,它们有机会变成AI能够调度的“能力接口”。
这才是WeLM真正令人警觉的地方。
模型本身不是护城河的全部,模型能够调用什么,才开始成为护城河。
一个在公开Benchmark上领先5分的模型,如果只能回答问题;另一个稍弱一些,却能够安全、稳定地操作支付、内容、社交和上百万开发者提供的服务,哪一个最终更有商业价值?
答案未必属于排行榜第一名。
腾讯自己的财务数字其实已经展示了这种逻辑。Q2营销服务收入436亿元,同比增长22%,公司明确把增长部分归因于AI广告推荐模型升级、AIM+智能投放以及微信生态闭环营销能力。也就是说,在消费者Agent真正大规模商业化之前,AI已经先在腾讯原有业务中转化成了收入增长。
这也是大型互联网平台与纯模型公司的最大不同。
它不必等AI本身开始收订阅费,才能证明AI有价值。
六、但真正困难的比赛,现在才开始
WeLM面前依然有三个非常现实的问题。
第一个是可靠性。
聊天机器人答错一句话,用户最多重新问一次;Agent调错一个服务、执行错一个步骤,代价会高得多。模型从“说”走向“做”,容错率不是下降一点,而是整个产品责任都变了。
第二个是权限。
微信掌握着极其丰富的关系链、内容、服务和交易场景。AI能够访问得越深,就越有用;能够访问得越深,隐私、安全和授权设计也越难。腾讯特别强调WeLM针对用户隐私进行定制,恰恰说明这不是一个边缘问题,而是小微能不能真正放量的基础条件。
第三个仍然是成本。
腾讯第二季度527.8亿元资本开支已经给整个市场发出一个相当清晰的信号:AI时代所谓的“入口战争”,背后首先是一场资本密集型战争。
更有意思的是,腾讯披露的Non-IFRS经营利润为756亿元,而如果剔除Hy、元宝、CodeBuddy、WorkBuddy和小微等新AI产品影响,则达到861亿元,两者相差约105亿元。
这不能简单解释成“AI亏损105亿元”,因为该口径同时包含相关收入、成本和开支影响;但至少说明一件事:腾讯正在用一笔已经足以影响利润增速的真金白银,为下一代产品买门票。
所以,今天判断WeLM成功还太早。
617B仍在开发,小微仍处于小范围原型测试和灰度阶段。模型评测可以告诉我们它“有能力”,却还不能证明14亿级产品中的用户愿不愿意天天用,更不能证明Agent能否长期稳定完成真实交易和复杂任务。
但今天之后,有一点已经变得越来越清晰:
微信不是在给聊天框加一个AI按钮,而是在试图让AI成为微信内部重新组织服务的一层系统。
80B负责让这套系统跑得动。
617B试图让它处理更难的事情。
Hidden Decoding则在探索,同样一套大脑还能不能用新的计算方式再多想一点。
三件事背后其实是同一个目标:在智能、成本和执行能力之间寻找一个足以覆盖十亿级用户的平衡点。
真正值得等待的 therefore 不是617B哪一天正式上线,也不是下一张Benchmark榜单谁领先半分。
而是有一天,当用户想办一件事时,会不会越来越少说出“我该打开哪个小程序”,而是直接对微信说:
帮我办了。
如果那一天真的到来,WeLM最大的意义就不会是一款模型。
它会成为微信从“超级App”走向“超级Agent”的那台发动机。
参考资料
- Tencent Holdings Limited. Tencent Announces 2026 Second Quarter Results. 2026-08-12. 腾讯披露Q2营收、利润、资本开支、微信及WeChat月活、小微灰度测试及WeLM定位等信息。
- Liu, Aiwei, et al. Hidden Decoding at Scale: Latent Computation Scaling for Large Language Models. arXiv:2607.08186, 2026-07-09. 包含WeLM-80B、WeLM-617B架构、Hidden Decoding评测、训练成本及推理吞吐实验。
- Su, Hui, et al. WeLM: A Well-Read Pre-trained Language Model for Chinese. arXiv:2209.10372, 2022-09-21. WeLM系列早期公开研究。
- IT之家:《腾讯微信公布WeLM模型:80B版已在AI助手小微上应用,617B版正在开发》,2026-08-13。报道微信团队公开海报中的两档参数规模及产品定位。
- Reuters. Tencent Q2 revenue climbs 11% on AI-driven ad gains, but profit falls short. 2026-08-12. 对腾讯Q2业绩、AI资本投入及广告业务增长的独立报道。