AI开始卷信息不对等了?
文章作者、来源:机器之心
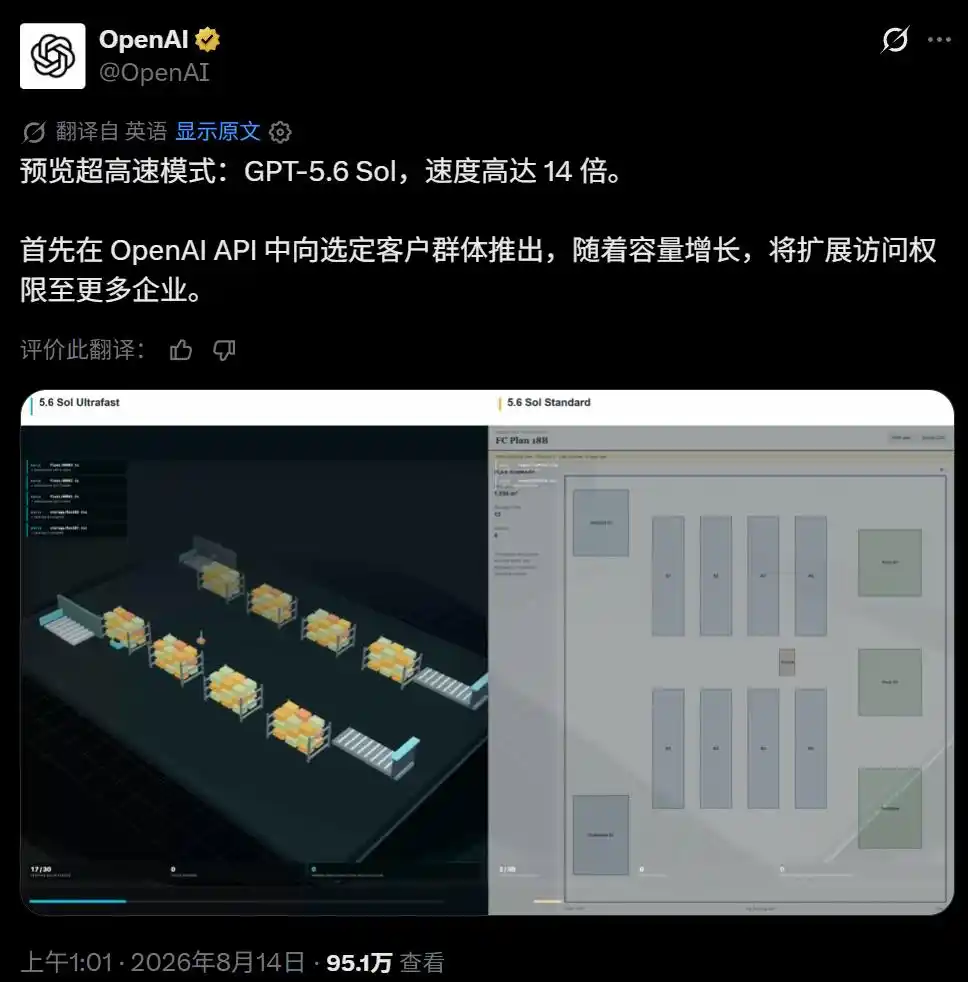
8月14日凌晨,OpenAI联合AI芯片厂商Cerebras正式预览了其旗舰模型GPT-5.6 Sol的全新服务层级「超高速模式」(Ultrafast Mode)。
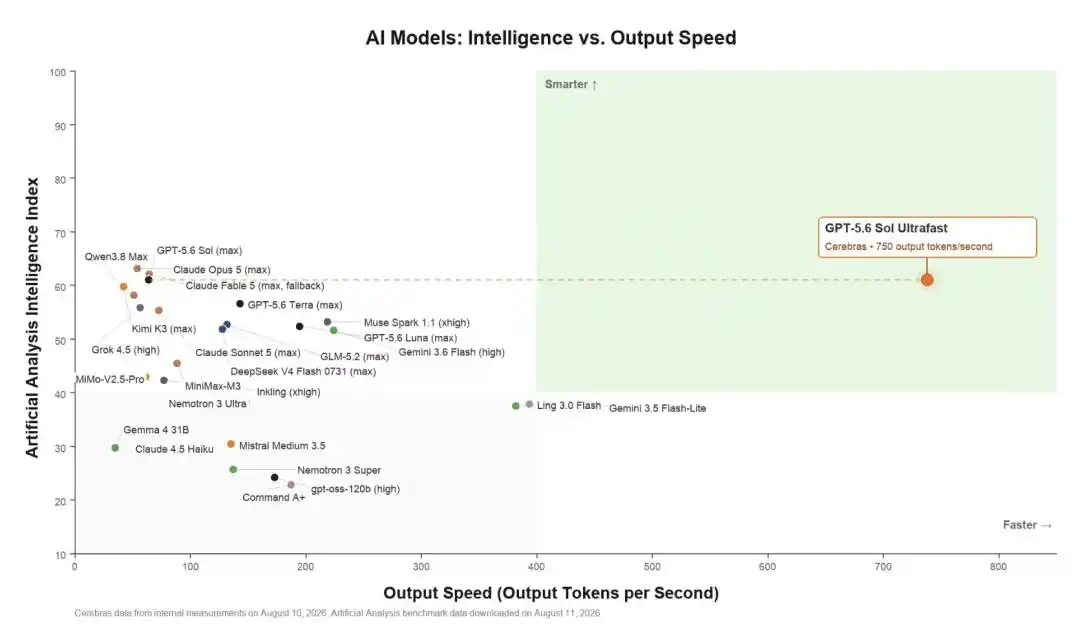
在该模式下,GPT-5.6 Sol的输出速度最高可达750 tokens/s,相比目前Standard(标准)模式约53 tokens/s的推理基线,速度提升最高达14倍,同时不降低任何质量。横向对比的话,GPT-5.6 Sol加速后比Fable 5快11倍,比Opus 4.8在Fast模式下快5倍。
Ultrafast模式将率先在OpenAI API中推出,当前已面向部分客户推出有限预览版。
为此,OpenAI与Cerebras还对当前先进AI大模型现在的速度和智力对比拉了个表格,GPT-5.6 Sol Ultrafast处于绝对领先的位置:
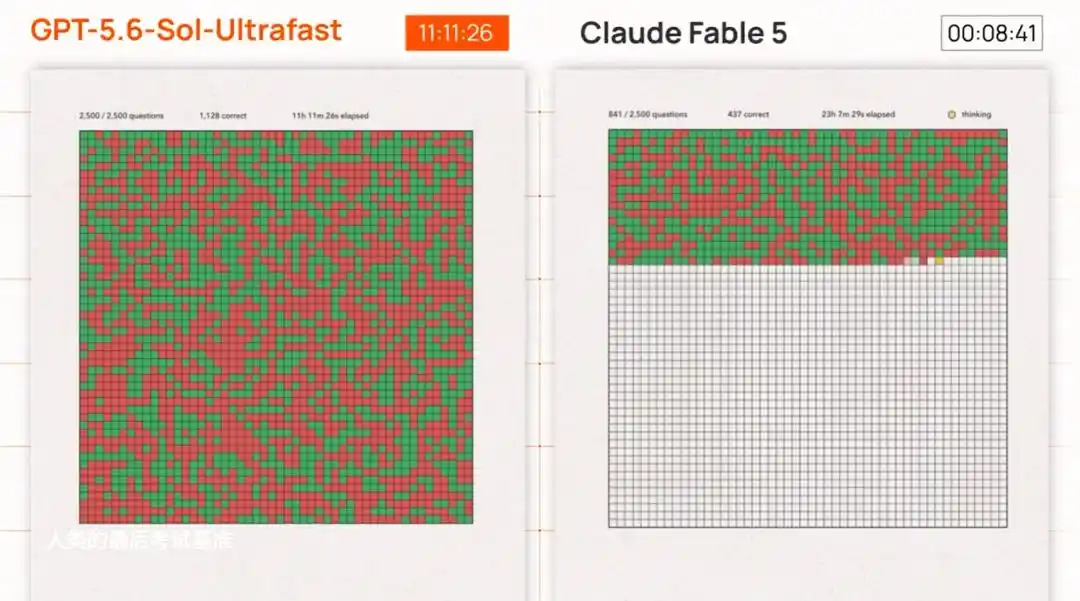
在Cerebras的博客中,工程人员介绍了在「人类最后的考试」(Humanity's Last Exam, HLE)上进行的测试,他们把Ultrafast后的模型与直接竞对进行了对比。我们知道,HLE是一项具有挑战性的模型基准,包含2500道题,通常只有化学、经济学和文学等领域的博士才能解答。
GPT-5.6 Sol在超快模式下仅用11小时11分钟就回答了全部问题。而Claude Fable 5则需要78小时27分钟,也就是超过三天的连续计算才能得出相同的结论。GPT超快模式仅用一个工作日就完成了人类知识的前沿领域,在准确率相近的同时,速度几乎是Claude Fable的7倍。
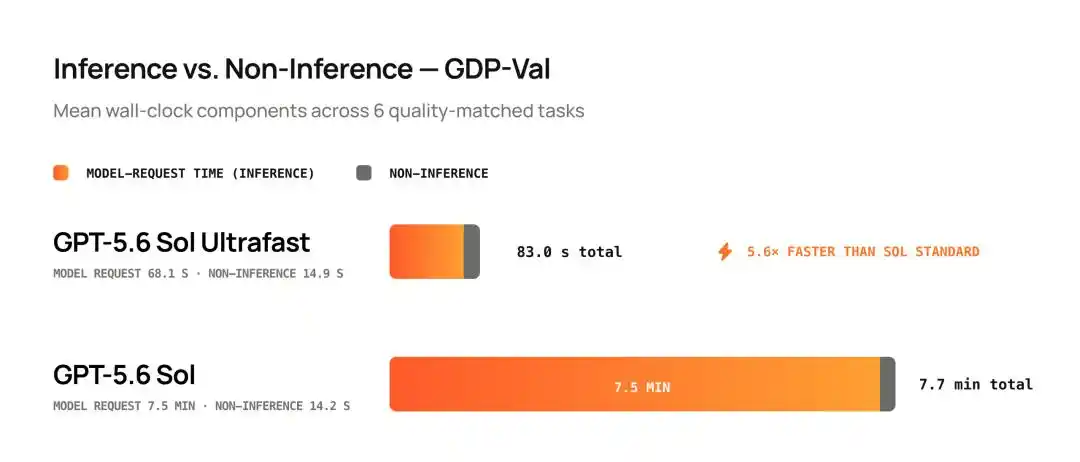
随着模型能力的不断提升,快速推理的应用范围也会扩大。GPT-5.6 Sol是OpenAI迄今为止在法律文书、金融模型和工程报告方面表现最佳的模型。在GDP-Val(衡量经济价值知识工作任务的基准)上,Ultrafast实现了5.6倍的端到端速度提升,且质量未受影响,充分展现了更快的推理速度如何加速经济价值工作的开展。
更快的AI处理速度为新兴工作流增加了不少可能性,人们现在可以将智能体部署到问题的关键路径上。OpenAI为你列举了一些应用场景:
- 事件响应和可靠性:当关键系统发生故障时,AI分析应用程序日志、最近的代码更改和工程师报告,以确定可能的原因,并在故障仍在发生时帮助准备修复方案。
- 金融研究与安全:在市场形势瞬息万变的情况下,分析市场信号、评估交易并识别可疑活动。
- 客户支持和语音:实时解决复杂的客户问题,即使找到答案需要多个步骤或系统,也不会中断对话。
- 商务:在购物者还在犹豫不决时,回答产品问题、检查库存、个性化推荐并解决结账问题,避免犹豫演变成放弃购物车。
- 实时研究和实验:将以前需要一夜才能完成的研究变成交互式工作会议,让团队测试想法、检查结果、调整方法,并在不中断工作流程的情况下进行另一次实验。
在OpenAI内部,开发人员在超快速模式下测试了GPT-5.6 Sol,事件响应是使用Ultrafast的一个例子。当警报触发时,工程师需要在系统和证据仍在变化的情况下构建准确的事件图景。借助Sol级别的智能,团队可以快速读取日志、分析跟踪信息、汇总对话、确定下一步检查,并协助准备或验证修复方案。Ultrafast模式缩短了从观察到信号、验证假设到选择下一步行动之间的延迟,同时工程师仍然负责判断和部署。
在研究方面,OpenAI团队使用Ultrafast来快速搜索知识库、查询数据,并快速收集、整理和汇总来自不同工具的信息。以往研究中常见的流程是,团队成员在夜间启动一批实验,并在第二天早上查看结果。而有了Ultrafast,发现的流程可以缩短,从而支持在工作日内进行多次迭代。
Ultrafast模式的突破在于打破了传统GPU集群在大模型推理解码阶段的内存带宽瓶颈,其实现主要依赖于Cerebras的晶圆级硬件架构。
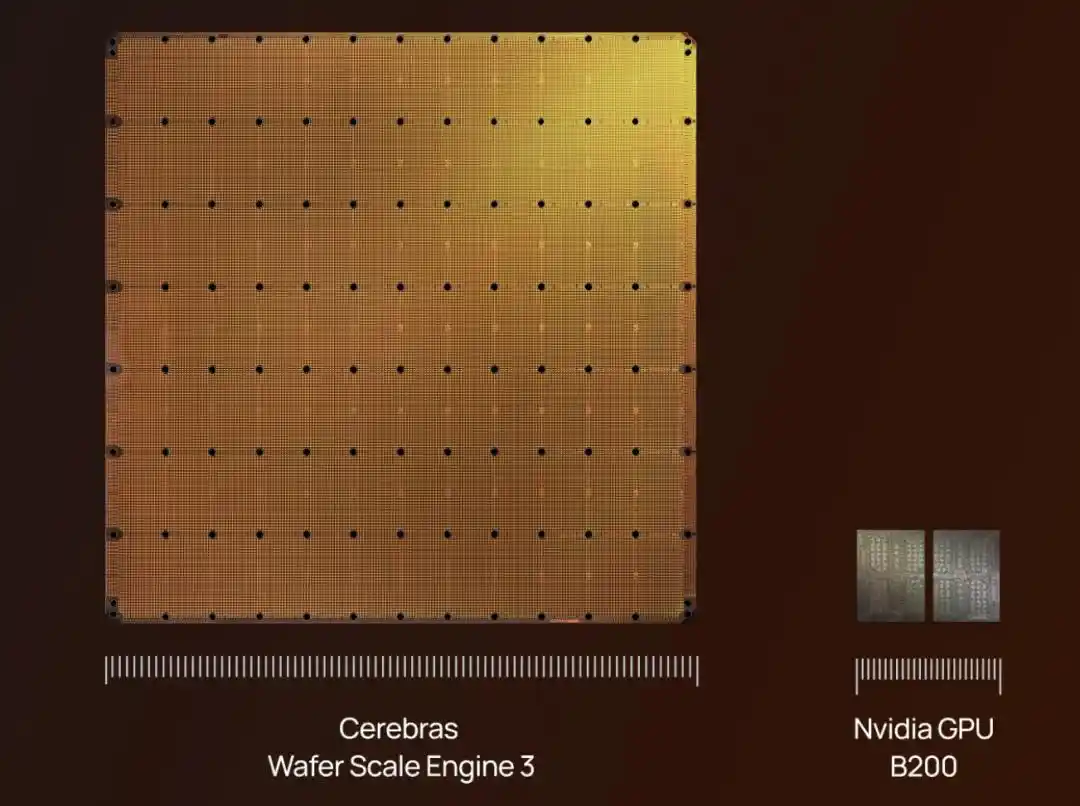
在AI芯片厂商行列中,Cerebras的解决方案独树一帜:其历代芯片采用整片晶圆制成,在单片上集成了海量计算核心与超高速互联网络。
传统GPU在运行大模型自回归解码生成Token时,受限于显存带宽,需要不断将庞大的模型权重在片外HBM和计算核心之间往返搬运;同时多卡切分还会带来跨芯片互连(PCIe/NVLink)的通信延迟。
而每块Cerebras最新的晶圆级芯片(WSE-3)集成了4万亿晶体管,125 petaflops的AI算力和高达44 GB的片上高速SRAM,模型参数直接全部常驻在超高带宽的片上SRAM中,避免了反复从片外内存加载权重的等待时间。
当然,GPT-5.6 Sol作为前沿旗舰模型,完整参数量显然远超芯片容量。Cerebras还有「多晶圆流水线并行(Pipelined across wafers)」机制,其将模型的各网络层分别分布于多颗晶圆上,每层参数常驻于各自芯片的SRAM中,能让Token在晶圆间无缝流水传输。
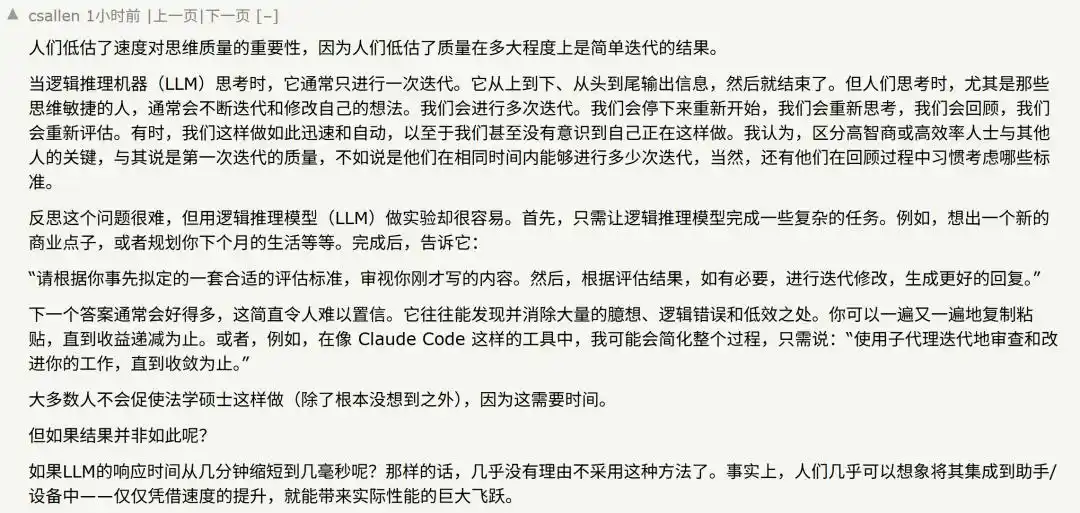
对于众多大模型用户来说,旗舰模型14倍速会意味着以前不少必须切换次级模型(如Luna和Terra)的任务现在可以直接放心地满血跑,对于需要多轮工具调用、代码生成排错和复杂链式思考的Agent任务,原本需要几小时的流程可压缩至几分钟完成。
更快的速度或许也意味着我们使用AI的方式发生转变:
AI社区里,人们已经在期待Luna和Terra版的超高速模式了,就是不知道Cerebras的芯片是否够用。