当公开互联网越来越难提供足够稀缺、可靠、未经AI生成内容污染的高质量文本,旧书正在从文化商品变成AI时代的数据原料。
文章作者、来源:0x9999in1,ME News
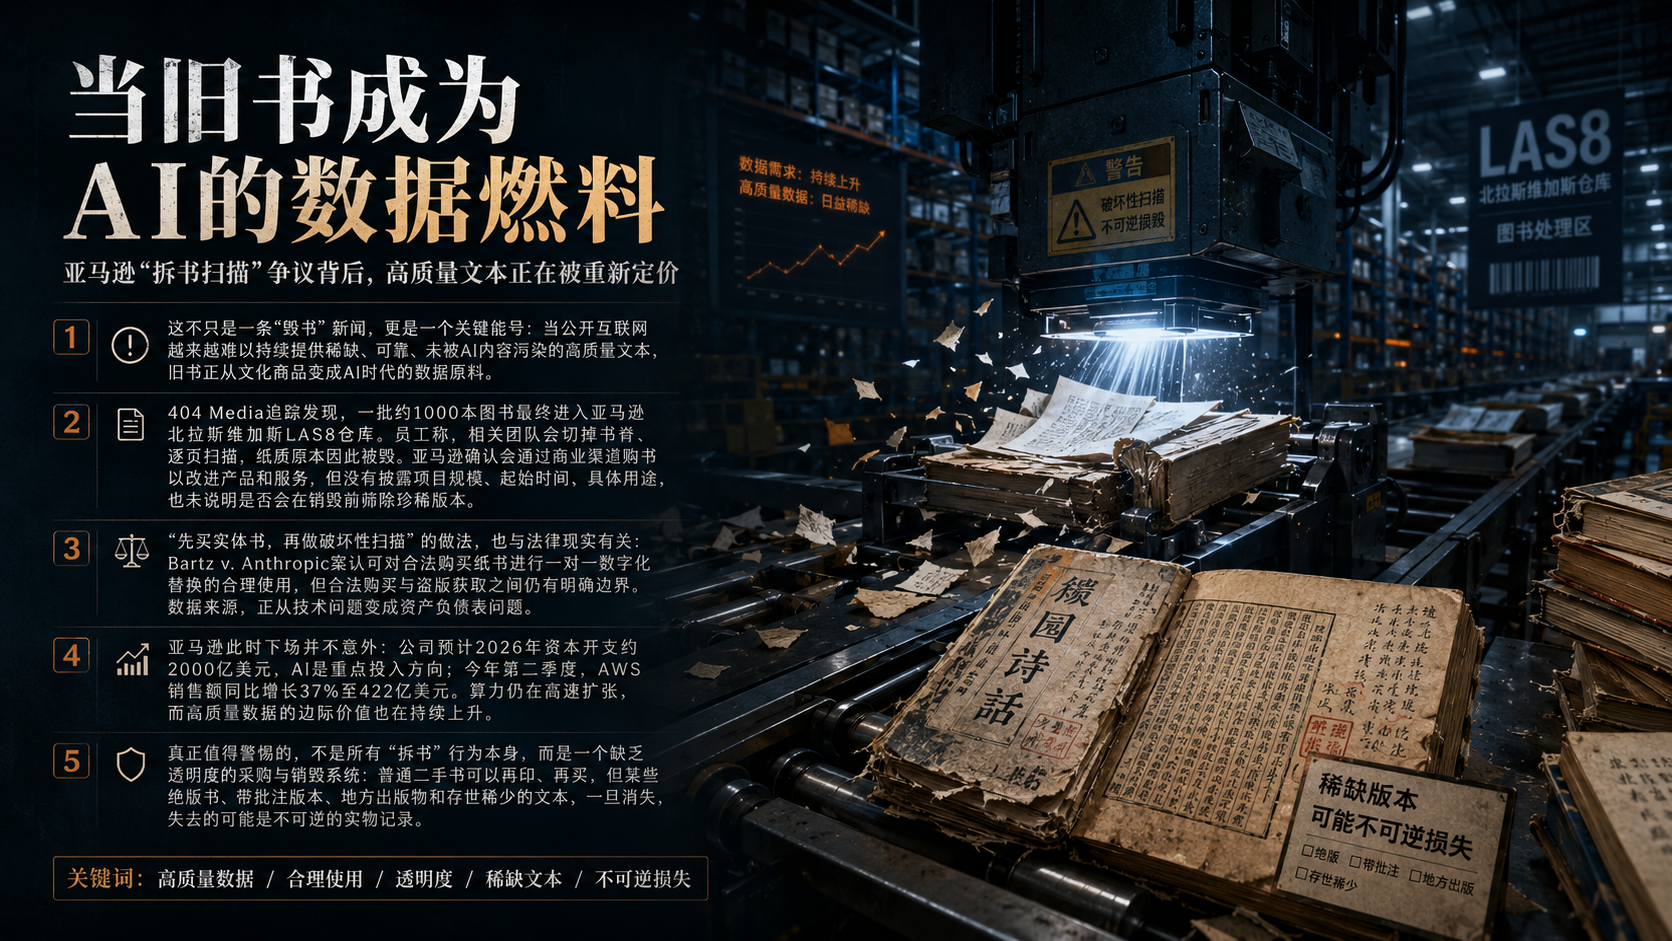
TL,DR
- 这不是一条简单的“亚马逊毁书”新闻。更重要的信号是:当公开互联网越来越难提供足够稀缺、可靠、未经AI生成内容污染的高质量文本,旧书正在从文化商品变成AI时代的数据原料。
- 404 Media追踪的一笔约1000本书订单最终进入亚马逊北拉斯维加斯LAS8仓库;员工称其中VGT3团队会切掉书脊、扫描页面,纸质原本因此被毁。亚马逊确认会通过商业渠道购书以改进产品和服务,但没有公开项目规模、起始时间、具体用途,也没有回答是否会在销毁前筛除珍稀或稀缺版本。
- “先买实体书、再做破坏性扫描”还有一层现实背景:2025年的Bartz v. Anthropic案中,美国联邦地区法院认可了对合法购买纸书进行一对一数字化替换的合理使用,但明确区分了合法购买与盗版获取。到2026年7月,Anthropic涉及盗版来源的集体版权诉讼又以15亿美元和解获得最终批准。数据来源正在从技术问题变成资产负债表问题。
- 亚马逊此时下场并不奇怪。公司预计2026年资本开支约2000亿美元,AI是重点投入方向;今年第二季度AWS销售额同比增长37%至422亿美元。算力还在疯狂扩张,但高质量数据的边际价值也在上升。
- 真正需要警惕的不是所有“拆书”行为本身,而是一个缺少透明度的采购与销毁系统:普通二手书可以再印、再买,某些绝版书、带批注的版本、地方出版物和存世稀少的文本却可能无法恢复。一旦筛选机制不存在,AI公司获得的是数据,社会失去的可能是不可逆的实物记录。
一本书被拆掉,不是故事真正的重点
这件事最抓眼球的画面当然很残酷:一本书被切掉书脊,纸页被送进扫描设备,最后原书不再存在。更戏剧性的是,做这件事的公司偏偏是亚马逊——那个1995年从网上卖书起家的亚马逊。三十多年后,它又开始大批量买书,只是这一次,书未必是要交到读者手里,而是要变成机器可以吞咽的数据。
根据404 Media 8月17日发布的调查,记者Emanuel Maiberg与一名通过Biblio接到大单的书商合作,在一批约1000本书中的一本放入AirTag。追踪器一路抵达亚马逊位于北拉斯维加斯的LAS8仓库。报道援引在该地点工作的员工称,一个名为VGT3的团队负责接收大量纸质书,切除装订后快速扫描,原书在流程中被破坏。亚马逊随后向Inc.确认,公司确实“通过商业渠道购买书籍,以帮助开发和改进客户所使用的产品和服务”,但没有回答究竟买了多少、项目从何时开始、数据进入哪些产品,以及是否会提前剔除珍稀或稀缺版本。
更值得注意的是,这条线索并非昨天突然出现。Inc.发现,早在2024年9月,亚马逊卖家论坛里就有人报告大量书籍订单被送往LAS8:有人遇到单一买家一次下68单,有人凌晨集中收到48笔订单,而且全部是大学出版社图书,还有卖家称同一账户几乎每天都在买书。亚马逊论坛代表当时最终确认这些订单有效,但亚马逊如今没有说明那些订单是否与VGT3有关。
我的判断是,这件事真正值得关注的,不是“科技巨头竟然毁书”这种情绪冲击,而是它暴露了AI产业正在发生的一次资源重估:过去几年最稀缺的是GPU、机房、电力和资本,现在,高质量、可追溯、尽可能没有AI生成内容污染的人类文本,也开始被重新定价。
旧书市场突然被卷进AI供应链,并不是怀旧时代的荒诞插曲,而是大模型工业化之后很自然、也很冷酷的一步。
为什么偏偏是旧书
互联网看起来无穷无尽,但真正适合训练前沿模型的数据并不是无限的。
Epoch AI在2024年的研究中估计,经过质量与重复调整后,可供训练使用的公开人类文本有效存量大约为300万亿token;如果当时的数据规模增长趋势延续,这一存量可能在2026年至2032年间被充分利用。这个预测不是“数据明天就会枯竭”的倒计时,因为合成数据、数据效率、后训练和多模态方法都在继续变化,但它揭示了一个方向:单纯依靠继续扩大网页抓取,越来越难得到同等质量的新增信息。
而旧书有几个让AI公司无法忽视的特点。
首先,它们往往经过作者、编辑、出版社多轮筛选,信息密度和结构通常比随机网页更稳定。其次,大量地方史、专业手册、小众学术著作、旧版教材、行业资料和非英语出版物从未完整数字化,公开网页根本抓不到。更微妙的一点是,尤其在生成式AI大规模普及之前出版的内容,更大概率来自纯粹的人类写作环境。
这种价值已经被数据商直接说了出来。今年7月有关图书采购市场的报道中,图书数据库公司ISBNdb一度用“世界上最好的AI训练数据正躺在书架上”来测试面向AI公司的图书采购需求,并强调图书所包含的是经过整理、编辑、专业化的人类知识。ISBNdb后来表示该页面只是市场需求测试,并已经撤下。
可这句话为什么刺眼?因为它把整个行业的焦虑说透了。
生成式AI越强,互联网中由AI写出来、AI改写过、AI汇总过的文字就越多。模型如果再无差别地吞回这些内容,数据来源会越来越复杂。于是那些在生成式AI浪潮前已经印在纸上的东西,突然多了一层过去没有的价值:至少在时间上,它们更加接近一个未经大规模生成式AI介入的信息环境。
所以,亚马逊买旧书并不意味着它“退回纸媒时代”,恰恰相反,这是非常彻底的数据化思维。对于模型训练者而言,一本书的封面、装帧和收藏故事可能没有直接训练价值,真正值钱的是里面那些可以被分词、索引、去重、标注和训练的token。
书从商品变成语料,价格体系也随之改变。以前几十年没人问津的一本专业旧书,可能因为网上没有完整电子版,突然产生新的机器需求。
这才是最值得注意的地方。
为什么一定要切书,而不是好好扫描
原因首先很朴素:效率。
要把成千上万本书工业化数字化,逐页翻拍是一件极慢的事。切掉书脊以后,纸页能够被平整分离,更适合高速扫描和后续文字识别。破坏性扫描并不是AI时代才出现的技术,但AI可能把它第一次推向如此直接的数据工业用途。
可还有第二层更敏感的背景:法律。
2025年6月,美国加州北区联邦地区法院在Bartz v. Anthropic案中披露,Anthropic曾购买数百万本纸质书,拆除装订、裁切页面、扫描成数字副本,并在生成数字版本后丢弃纸质原本。法官William Alsup在当时的具体事实下认为,这种“一个纸质副本被一个内部数字副本替换、且数字副本不向外传播”的格式转换属于合理使用;法院也认定案中特定的大模型训练用途属于合理使用。
但同一份判决也划出了一条非常硬的线。
Anthropic此前从盗版数据库下载了超过700万本书。法院认为,建立并长期保存这些盗版来源的中央数字图书馆,不能因为其中部分内容后来用于AI训练,就自动获得合理使用保护。合法购买与盗版取得,被法院明确分开处理。
这条线为什么重要?因为它给整个AI行业上了一堂昂贵的采购课:不是“只要为了训练,什么数据都能拿”,而是数据从哪里来、企业是否付钱取得副本、保存与复制方式是什么,都可能改变法律风险。
而这堂课后来真的变贵了。
2026年7月20日,美国联邦法院最终批准Anthropic与作者和出版方达成的15亿美元集体版权和解。和解涉及超过48.2万本书,约91%的相关作品已经有人提出赔付申请。必须说清楚,这笔和解针对的是盗版来源相关索赔,并不意味着美国司法系统已经给所有AI训练确立了一张统一通行证;其他案件、不同数据来源和不同使用方式,仍可能产生不同结果。
也因此,亚马逊如今通过商业渠道购买实体书,在风险控制逻辑上非常容易理解。
它是否直接照着Anthropic案件形成的法律路径设计流程?目前没有公开证据,不能这样下结论。但在Anthropic的判决和15亿美元和解都已经摆上桌面的2026年,任何大型AI公司都会更加在意一件事:你能不能证明数据是从哪里来的。
买一本实体书的价格,可能很便宜;几年后在法庭上解释几百万份训练材料从哪里来的,可能一点也不便宜。
AI行业过去习惯把数据看成网络上取之不尽的空气,现在,它正在学会给“出处”付钱。
最值得警惕的,不是“毁书”,而是黑箱
这里必须把情绪和事实分开。
普通畅销书、印量巨大的通俗读物、市场上仍有大量副本的旧书进入回收体系,本身并不等于文化灾难。二手书和古旧书行业过去也存在拆书售卖插图、处理滞销书等行为。不能因为AI出现,就突然假装每一本旧书都是孤本。
问题在于,亚马逊至今没有回答它是否会在破坏扫描之前识别珍稀、绝版或者特殊版本。
404 Media追踪的那本书被报道描述为一本稀有书籍,而Inc.专门向亚马逊追问,公司在销毁书籍之前是否筛除珍稀或稀缺版本,没有得到回应。
这就留下了一个不能用“反正已经花钱买下来了”轻易带过的漏洞:法律意义上的所有权,与文化保存价值根本不是一回事。
一本书的正文可以扫描。可是某个具体版本上的签名、读者批注、藏书票、特殊装订、勘误信息、地方印刷痕迹,甚至一本书几十年流转留下来的物理记录,并不一定会进入OCR,更不一定会进入最终训练集。
文字留下了,物证却可能消失。
这种担忧也不只存在于美国。今年英国和爱尔兰多家二手书商向《卫报》表示,近几个月出现了一批主题毫无关联、价格敏感度很低的大宗采购:有人一次购买爱沙尼亚语版小说、特定版本的勃朗特作品和1983年的旧杂志;一名书商称今年以来已经收到类似买家约6000本书的订单。澳大利亚此前也有书商报告异常的大批量订单。
但这里同样必须守住事实边界:这些海外订单背后是否都是AI公司,目前没有公开证据。《卫报》的报道本身也明确把它们写成书商的猜测和担忧,而不是已经确认的AI采购。
真正被追踪设备一路带到具体AI扫描设施的,是404 Media这次针对亚马逊的调查。
这恰恰说明透明度为什么重要。
如果企业认为这种采购合法、合理,而且确实能改善产品,那么几个最基本的问题并不过分:哪些类型的书会进入破坏性扫描?是否排除孤本、珍本、签名本以及具有特殊实物价值的版本?扫描后的纸张如何处理?数字副本保留多久?大体会用于哪些产品或模型类别?
企业当然不必公开全部训练配方。
但“我们花钱买了,所以可以沉默地把一切都切掉”,不是一个足够成熟的答案。
亚马逊为什么会在此时做这件事
因为它正在以前所未有的速度押注AI。
亚马逊在今年2月表示,预计2026年全年资本开支约2000亿美元,重点机会包括AI、芯片、机器人和低轨卫星。到了第二季度,公司销售额达到2006亿美元,同比增长20%;AWS销售额达到422亿美元,同比增长37%,创18个季度以来最快增速。过去12个月自由现金流已经转为76亿美元净流出,亚马逊明确表示,物业和设备采购大幅增加,主要反映人工智能投资。AWS的AI业务和芯片业务也分别突破250亿美元年化收入运行率。
更值得注意的是亚马逊与Anthropic的关系。
今年4月,亚马逊宣布在此前80亿美元投资基础上,再向Anthropic投资50亿美元,并可在达到特定商业里程碑后追加最多200亿美元。与此同时,Anthropic承诺未来十年在AWS技术上的支出超过1000亿美元,并将获得最高5GW的现有及未来Trainium算力。
换句话说,亚马逊现在既是云基础设施提供商,也是前沿模型产业的资本参与者,同时还经营Nova、Alexa、Rufus以及大量企业AI服务。
它需要的已经不只是更多芯片。
它需要更多高质量知识,更长尾的知识覆盖,更可靠的数据来源,以及更容易解释的数据产权链条。
以亚马逊当前的资本开支规模而言,批量采购旧书显然不会成为决定公司财务状况的主要成本。真正重要的是这个动作本身释放出来的信号:一家愿意一年投入约2000亿美元扩建技术基础设施的巨头,仍然愿意把供应链触角伸进分散、低效率、一本一本定价的二手书市场。
为什么?
因为有些数据,真的没有快捷方式。
这也是AI竞争正在变化的地方。过去大家比谁能爬更多网页,后来比谁有更多GPU,现在越来越要比谁拥有更干净、更独特、更合法、更难复制的数据。
数据不再只是训练开始之前的一堆“原料”。
它正在变成一种必须采购、清洗、确权、追踪和审计的资产。
真正的数据护城河,也许不是“谁拥有互联网的副本”,而是谁拥有别人拿不到、拿不稳,或者拿到了也不敢放心使用的高质量内容。
这场争议最后会落在哪里
我不认为结论应该是“禁止AI公司扫描实体书”。
数字化本身可以保存知识,也可能让绝版内容重新进入搜索、研究和机器理解体系。对于大量普通二手书而言,破坏性扫描也未必比最终进入废纸回收更糟。把这件事简单写成“AI正在焚书”,情绪很足,事实却不够。
真正的边界有两条。
第一条是权利边界:买到一本纸质书,不等于买到了这部作品的全部版权,更不等于所有训练、复制和输出行为天然合法。Bartz案只是美国一家联邦地区法院在特定事实下作出的重要判决,不是全球AI公司的永久通行证。
第二条是保存边界:如果一家企业无法证明自己会识别并避开存世稀少、版本独特或者具有特殊历史价值的书,那么所谓“高效扫描”,就可能把一个数据工程问题变成不可逆的文化损失。
亚马逊最应该回答的,其实不是“你们为什么需要书”。
这个答案已经越来越清楚:因为人类过去几百年留下的大量高质量知识,并不全部存在于开放互联网里。
真正的问题是:当这些书从书架走进AI训练流水线时,谁来判断什么可以被牺牲,什么不应该被牺牲?谁来确认企业得到的是内容,而不是顺手抹掉了内容之外的历史?
这件事的讽刺感很强。
亚马逊当年靠把书送到人的手里,成为互联网商业最重要的公司之一;今天,它又把书买回来,拆开,把文字送进机器。
技术当然可以改变知识的载体,但不能因此假装载体毫无价值。
AI需要人类写过的东西,这一点没有什么可羞耻。真正值得警惕的是,当整个行业越来越依赖“人类留下来的高质量文本”,却仍然把获取过程藏在供应链深处,把版权、来源、稀缺性和保存责任当作事后问题。
模型可以把一本书压缩成token,企业可以把token变成参数,但有些东西一旦被切碎,就没有下一次训练可以还原。
文明可以被数字化,责任不能被“格式转换”掉。
参考资料
- Emanuel Maiberg. “We Tracked a Shipment of Rare Books. It Ended at an Amazon AI Training Facility.” 404 Media, 2026-08-17.
- Georgia Fearn. “Amazon Is Buying Up Older Books and Destroying Them After Scanning. The Orders Go Back to 2024.” Inc., 2026-08-17.
- Amazon.com, Inc. “Amazon.com Announces Second Quarter Results.” 2026-07-30.
- Amazon. “Amazon and Anthropic expand strategic collaboration.” 2026-04-20.
- United States District Court, Northern District of California. Bartz v. Anthropic PBC, Order on Fair Use and Infringement, 2025-06-23.
- Reuters. “US judge approves Anthropic’s $1.5 billion settlement of copyright lawsuit.” 2026-07-20.
- Pablo Villalobos et al. “Will we run out of data? Limits of LLM scaling based on human-generated data.” Epoch AI, 2024-06-06.
- Dan Milmo. “Secondhand booksellers in UK and Ireland suspect AI firms behind ‘strange’ bulk orders.” The Guardian, 2026-08-15.