GPT-6 Astra公开披露使用超过10万张Grace Blackwell GPU训练,这意味着前沿模型竞争已经进入超大规模集群时代。
文章作者、来源:ME News
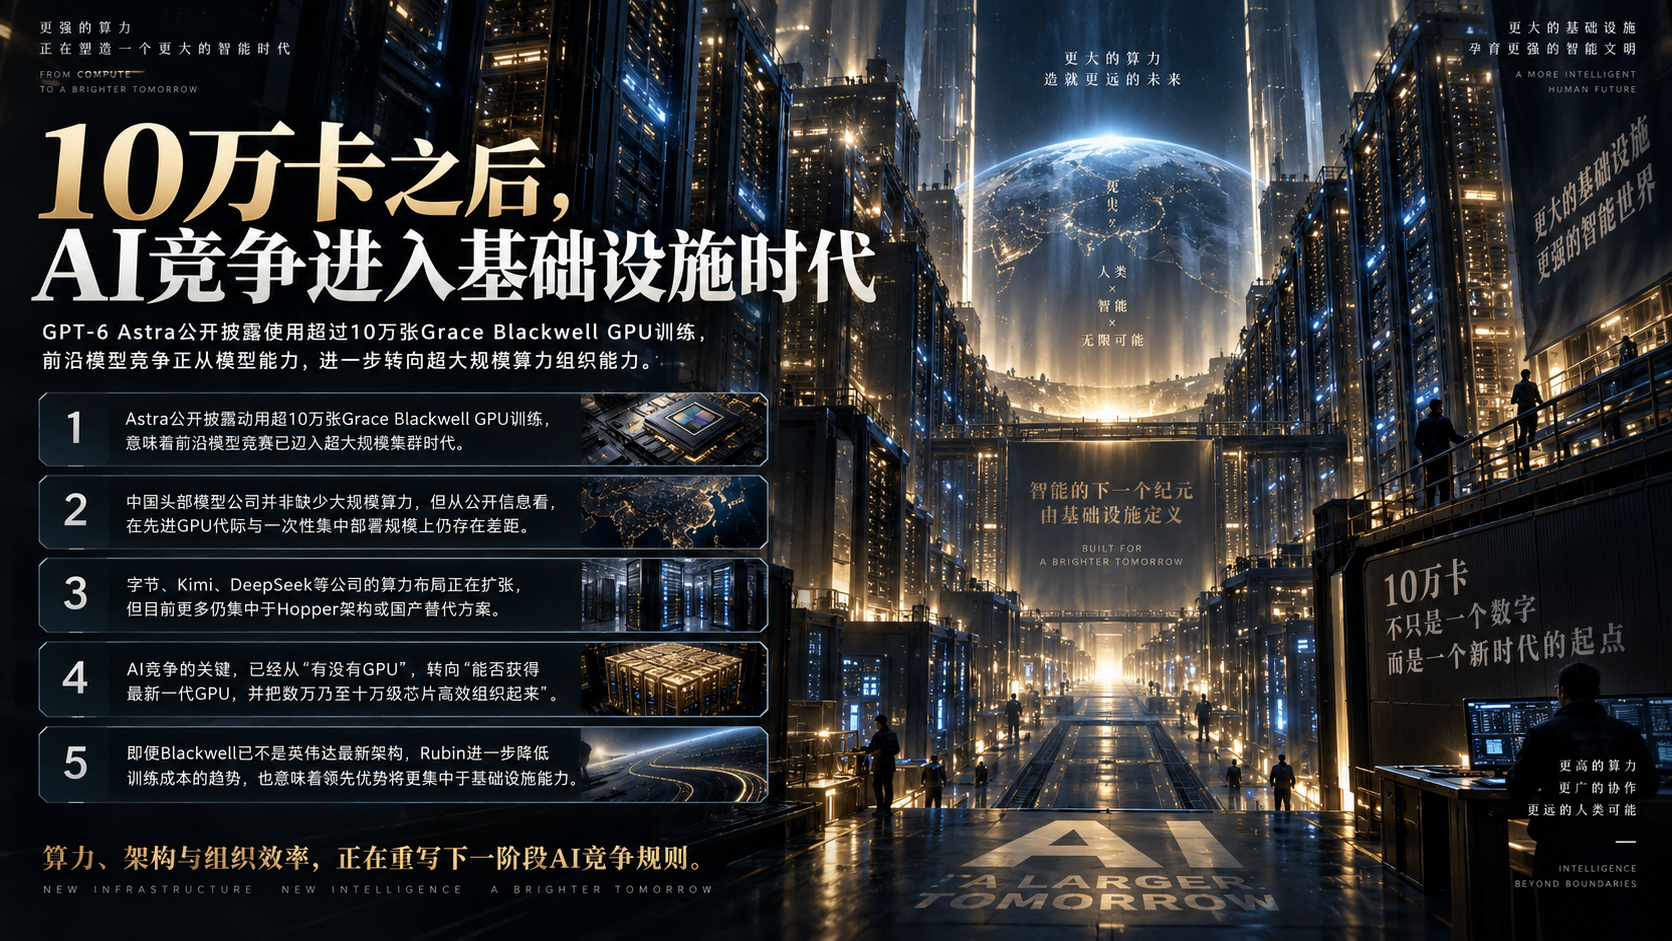
TL;DR:
- GPT-6 Astra公开披露使用超过10万张Grace Blackwell GPU训练,这意味着前沿模型竞争已经进入超大规模集群时代。
- 中国头部模型公司并非没有大规模算力,但公开信息显示,在先进GPU代际和一次性集中部署规模上仍存在明显差距。
- 字节、Kimi、DeepSeek等公司的算力布局正在扩大,但目前更多集中于Hopper架构或国产替代方案,与Blackwell级集群仍有距离。
- AI竞争的关键已经从“有没有GPU”转向“能否获得最新一代GPU,并将数万乃至十万级芯片高效组织起来”。
- 即便Blackwell已经不是英伟达最新架构,Rubin进一步降低训练成本的趋势,也意味着领先差距可能继续向基础设施能力集中。
10万张Blackwell背后,大模型竞争进入算力基础设施时代
黄仁勋披露GPT-6 Astra训练规模时,外界关注的并不只是“10万张GPU”这个数字本身,而是这个数字背后代表的一种新的AI竞争范式。
过去几年,大模型竞争经常被理解为算法、数据和工程能力的竞争。模型架构创新、训练方法优化、推理效率提升,确实决定了AI产品最终的能力。但进入2026年以后,一个越来越明显的趋势正在形成:当模型规模持续扩大,基础设施能力本身已经成为决定技术上限的重要因素。
根据黄仁勋公开披露,GPT-6 Astra训练使用了约10万张以上Grace Blackwell GPU,并通过NVLink72组成高速互联集群。他同时表示,下一批将有40万张GPU上线,但没有披露具体型号和归属。
无论后续部署细节如何,这一信息释放出的信号非常明确:最先进模型的训练,正在从过去几十万亿参数、几千张GPU的竞争,转向数万甚至十万级先进GPU集群之间的竞争。
这里的关键并不只是数量。
如果只是比较GPU数量,中国企业并非完全没有大规模算力资源。真正的差距在于,能否获得最新一代高性能GPU,以及能否让这些GPU在同一个训练任务中形成高效率协同。
对于大模型而言,单张GPU的峰值性能只是基础。训练一个大型模型,需要大量GPU之间持续交换参数和数据。如果互联效率不足,即使拥有大量芯片,也可能无法形成有效算力。
因此,AI基础设施的竞争,本质上已经从“买多少卡”升级为“建设怎样的计算系统”。
中国头部模型公司的算力布局,与Blackwell时代存在代际差距
目前公开信息显示,中国头部模型公司的算力规模正在快速提升,但与GPT-6 Astra所代表的Blackwell级训练集群相比,仍存在明显差距。
字节跳动是国内公开算力布局中较接近国际头部水平的公司之一。今年字节通过马来西亚接入约3.6万张B200 GPU。这批芯片属于英伟达Blackwell架构,与Astra使用的GB200属于同一代产品。
但需要注意的是,这批B200部署在海外。字节公开介绍中国境内AI基础设施时,主要使用的仍是Hopper架构的中国特供版H20,以及此前获得的H800等芯片。
这其中体现出的并不是简单的数量差距,而是供应链和部署环境差距。
Blackwell相较Hopper,在计算能力、显存、互联能力等方面进行了升级。尤其是GB200,它并非单纯的一张GPU,而是将Grace CPU和Blackwell GPU结合,通过NVL72系统把72张GPU连接到同一个高速互联域。
对于训练大型模型而言,这种系统级设计的重要性越来越高。因为模型规模越大,GPU之间通信占据的比例越高,芯片之间能否高效协同,会直接影响训练效率。
Kimi背后的月之暗面也被曝出通过阿里获得约2万张Hopper GPU。彭博社援引消息称具体型号为H200,但阿里否认了H200这一型号说法。
如果按照H200计算,它仍属于上一代Hopper架构,而B200已经进入Blackwell时代。两者之间并非简单的新旧替代关系,而代表了不同阶段的AI基础设施能力。
DeepSeek的情况更加特殊。
DeepSeek在2025年初凭借高效率模型引发全球关注,其技术路线证明了算法优化和工程效率能够部分降低算力需求。但从公开信息来看,公司并没有披露V4完整训练硬件配置。
流出的梁文锋投资者交流会转写稿显示,公司5月约有2万张H等效算力,其中大部分刚刚到货,未来采购“基本都是英伟达”。华为提供给DeepSeek的950产能约为1.6万张。梁文锋称,这批国产卡约相当于4000张Nvidia B系列,只够当前一代模型训练。
这些信息反映出一个现实:即便中国企业已经拥有数量可观的AI算力,但距离一次训练任务集中使用10万张同代先进GPU,仍然存在规模差距。
中国AI算力真正的短板,不是没有芯片,而是缺少先进集群能力
讨论中国AI算力时,容易陷入两个极端。
一种观点认为,中国完全缺少先进AI芯片,因此无法参与竞争;另一种观点认为,只要国产芯片数量增加,就可以快速追平英伟达。
实际上,情况更复杂。
AI训练能力由多个环节共同决定,包括芯片性能、先进制程、显存容量、高速互联、服务器设计、数据中心供电、软件生态以及大规模调度能力。
GPU只是其中最核心的一环,但不是全部。
英伟达长期建立的优势,也不仅来自GPU硬件,而来自CUDA生态、网络互联技术、服务器方案以及与云计算厂商形成的完整体系。
Blackwell时代,这种体系优势进一步被放大。
当一次模型训练需要10万张GPU时,问题已经不是采购几万块芯片那么简单,而是如何建设一个能够稳定运行的大型计算工厂。
这也是为什么公开资料中,中国公司尚未披露使用10万张同代先进GPU完成一次模型训练案例的重要原因。
中国企业正在通过多种方式提升能力,包括增加海外算力部署、扩大国产芯片适配规模、优化模型架构、提高训练效率。这些路径都有价值,但短期内很难完全替代最先进GPU集群带来的基础能力优势。
过去几年,中国AI行业证明了一个事实:算法创新可以显著缩小部分差距。
DeepSeek等公司的出现说明,优秀工程团队可以通过模型结构优化、训练策略调整和资源利用效率提升,在有限算力条件下取得突破。
但另一个事实同样存在:当全球竞争进入下一代基础模型阶段,算力规模的重要性仍然会上升。
效率优化可以降低成本,但很难完全改变先进硬件和超大规模集群带来的能力边界。
Blackwell之后,Rubin时代可能进一步拉大基础设施差距
更值得关注的是,Blackwell并不是英伟达当前技术路线的终点。
英伟达下一代Vera Rubin架构已经进入量产阶段。按照英伟达公开估算,在训练大型MoE模型时,Rubin所需GPU数量可以降低到Blackwell的四分之一左右。
这意味着未来AI竞争可能出现一个新的循环。
领先企业拥有最新架构,因此能够以更少芯片完成更大规模训练;更低训练成本又推动企业进行更多实验,进一步提升模型能力。
而落后企业如果只能获得上一代硬件,就可能面临两个问题:一方面训练效率低,另一方面难以参与最大规模模型竞争。
当然,这并不意味着中国AI企业没有机会。
AI历史已经多次证明,技术竞争并非完全由单一硬件决定。模型创新、应用场景、商业化能力和工程效率,都可能创造新的突破。
但如果从基础设施角度观察,GPT-6 Astra使用10万张Blackwell GPU这一事件,确实揭示了一个正在发生的变化:全球AI竞争的核心战场,正在从模型层面进一步向算力基础设施层面移动。
未来几年,决定AI公司竞争力的,不只是能不能训练一个优秀模型,而是能否建立持续训练下一代模型的能力。
对于中国AI产业而言,真正需要追赶的,并不是某一个模型或者某一次发布,而是从芯片获取、数据中心建设、集群调度到软件生态的一整套体系能力。
10万张Blackwell的意义,不在于它创造了一个令人震撼的数字,而在于它提醒市场:人工智能正在进入工业化阶段,而工业化竞争最终比拼的是基础设施。
参考来源:
- NVIDIA官方关于Blackwell、GB200 NVL72、Vera Rubin架构及AI基础设施的公开资料。
- Huang Renxun公开演讲及媒体采访信息。
- Bloomberg关于Kimi算力采购及H200相关报道。
- 字节跳动公开披露的AI基础设施及海外算力部署信息。
- DeepSeek公开信息及梁文锋投资者交流会相关转写资料。
- 阿里云关于AI基础设施及大模型算力合作的公开信息。